Автоматизация кросс-постинга: боремся с трудностями API Facebook | 2026-05-23T14:28:22

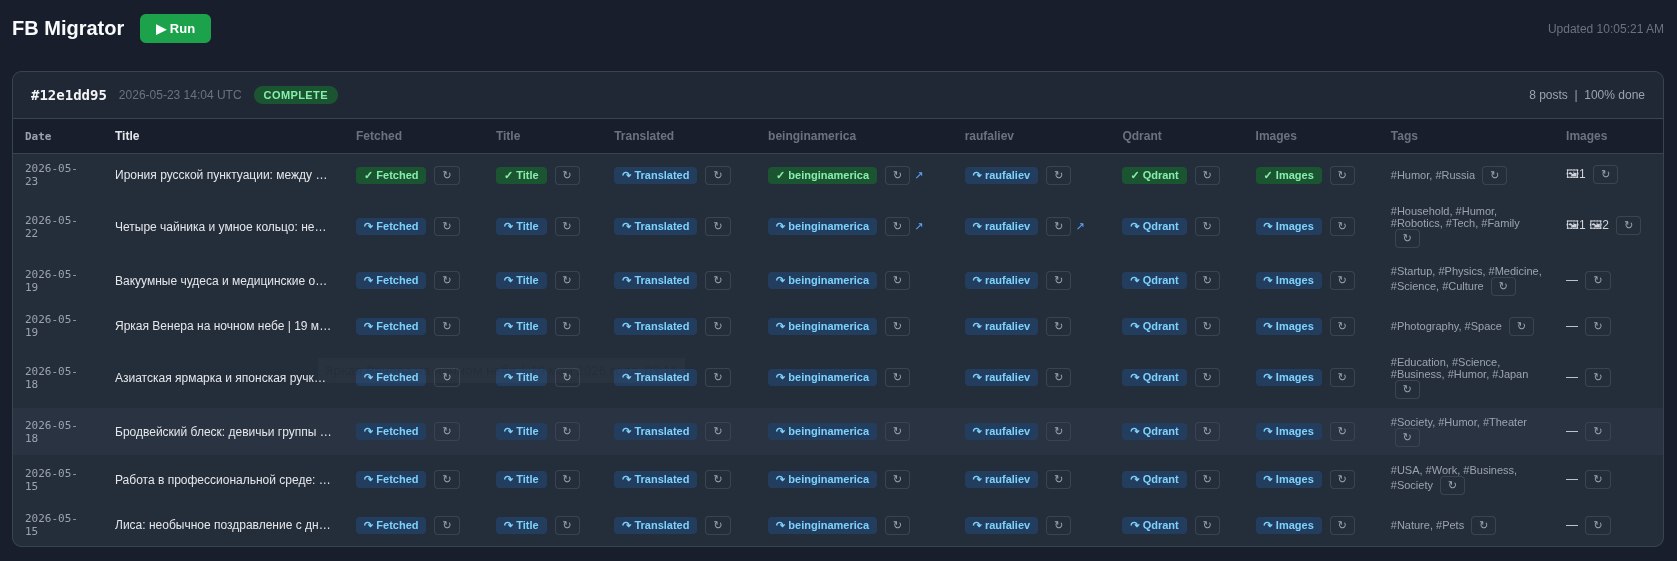
Доделал в лучшем виде кросс-постинг из фейсбука на два моих сайта-блога [на которые почти никто не заходит] — beinginamerica точка com и raufaliev точка com. При публикации нового поста в фейсбуке по расписанию стартует механизм перевода поста на английский, разбор приложенных картинок, генерация описаний к ним, создание заголовка на основе текста поста и описания картинок, создание тегов на их же основе, запись поста в turso db — это облачная база, бесплатная до определенных лимитов, создание эмбеддингов через openai, запись в qdrant cloud — это тоже облачная база, но уже векторная, ну и загрузка изображений в wordpress по API, и публикация поста на английском и на русском по API.

Все бы хорошо, но из всех API самый дурацкий — у фейсбука. Во-первых, для страниц как у меня, переведенных в New Experience, нет возможности использовать почти все из этого API. Точнее, есть, но нужно долго доказывать фейсбуку, что это реально надо, показывая документы на стартап, демонстрируя приложение и т.д. Очевидно, им не хочется иметь дело с чем-то уносящим контент из их системы во вне. Кроме этого, токен, который дает доступ к последним сообщениям, относительно короткоживущий (возможно, несколько недель), и получать его заново нужно через браузер только. То есть, любая автоматика требует регулярного внимания, иначе она ломается.

Если протупил и вовремя не выгрузил последние посты через этот Facebook Graph API, они просто исчезают из списка последних и все, больше по API к ним не обратиться. Единственный способ — запросить выгрузку архива у фейсбука. Эта выгрузка тоже довольно дурацкая — там нужно много трансформаций делать и убирать лишнее. Например, в файле с постами, который я обрабатываю, там почему-то хранятся ссылки, которые я отправлял в комментариях без сопроводительного текста. А комментарии там идут в отдельном файле!

Чтобы назначить теги, пришлось решить отдельный челендж. Вот есть около 10000 постов за все время. Это большой кусок, и по нему теги построить нельзя, потому что он в контекстное окно LLM не помещается. А надо. Поэтому я делал так: скрипт берет случайные посты из 10000 в таком объеме, чтобы их суммарный размер был чуть меньше указанного лимита в токенах, и в конец этого блока добавляется промпт «сгенери мне наиболее частые теги, 30 штук» (промпт привожу упрощенно). В итоге я запустил это 10 раз и получил 10 наборов тегов по 30 штук, сгенерированных для разных срезов базы. Получилось 300 тегов, из которых конечно есть полные дубликаты, а есть синонимы и близкие по смыслу. Это все скармливается LLM, и получаем список тегов и иерархию тегов. Теперь у нас есть ограниченный набор тегов, которые максимально отражают 10000 постов. Так получилось, что за почти 20 лет на фейсбуке у меня расклад такой:

Тег Постов

==================================================

#Russia 3412

#Thoughts 3146

#Tech 3105

#Culture 2765

#Hobbies 2726

#AI 1603

#Science 1367

#Software 1358

#Travel 1298

#Learning 1138

#Society 1050

#Nature 958

#Education 915

#Business 902

#Art 894

#Programming 889

#Humor 840

#History 807

#Gadgets 750

#Moscow 713

#USA 614

#Cinema 567

#Webdev 493

#Music 476

#Sports 473

#Mindset 443

#Auto 400

#Books 386

…

ну и так далее. Этот список включает как теги из ограниченного списка, так и теги, которые LLM поставила материалу просто потому, что не нашла в ограниченном ничего подходящего.

Теги из ограниченного списка стали категориями на сайте. Остальные теги + эти стали просто тегами wordpress.

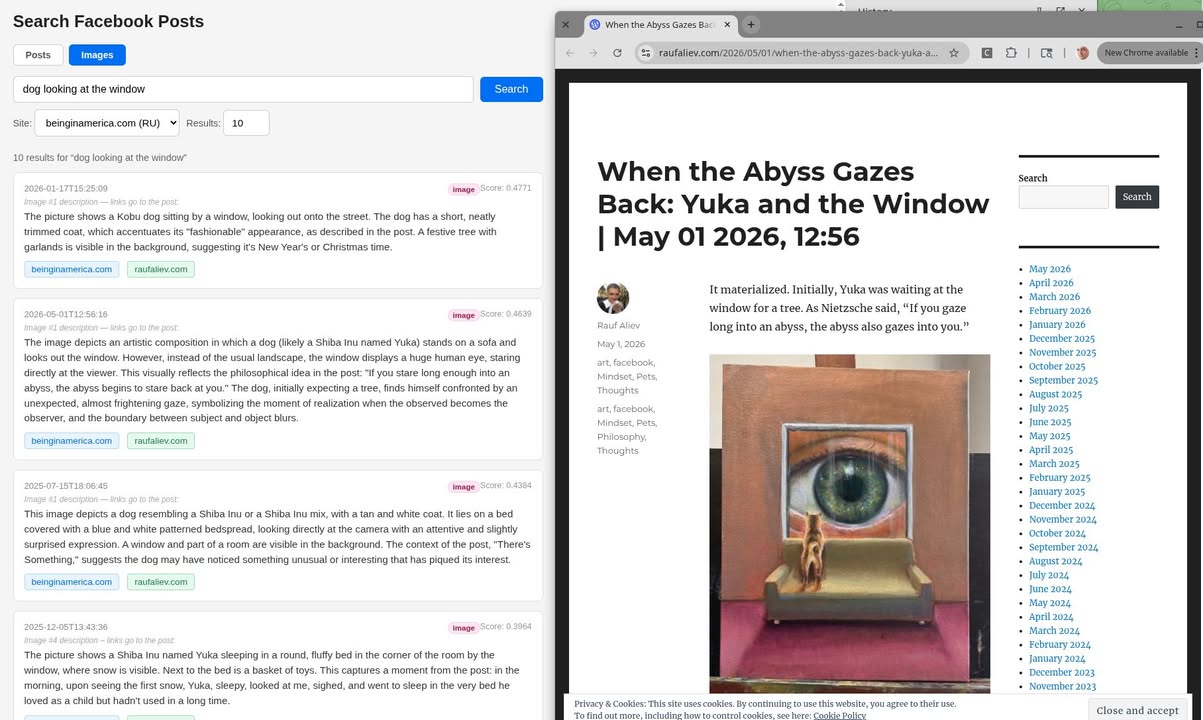
Поиск по картинкам. У меня было две идеи как его сделать. Первая — OpenCLIP. Это довольно просто, но требует хостинга модели где-нибудь. На своей машине легко, но каждый раз ее запускать неудобно, плюс я планировал переносить мигратор на дешевый сервер в амазон. В облачных моделях тоже нормально считать, но хоть немного за это надо платить, а это еще одна dependency. Но главное — что и без этого неплохо работает. Я с помощью OpenAI , который и так используется для перевода на английский, генерю описания к картинкам, и дальше по этим описаниям делаю embeddings с помощью large модели. Пока что все тесты на поиск проходят на ура. Особенно, когда на картинке есть текст, и большой вопрос разобрал бы ли его OpenCLIP.

В итоге:

1) вордпресс raufaliev точка com — бесплатный

2) вордпресс beinginamerica точка com — бесплатный

3) turso db где хранятся все посты — бесплатный

4) qdrant cloud где хранятся эмбеддинги — бесплатный

5) openai для перевода и описания картинок — не бесплатный, но недорогой (обработка постов за год потребовала 30 баксов).

Прикладываю два скриншота — как работает поиск по изображениям, и по текстам, а также дашборд мигратора.
Эксперимент СФИНКС: Изоляция и человеческие конфликты | 2026-05-10T18:01:06

В книжке Project Hail Mary Стратт рассказывает Грейс, что в СССР якобы был эксперимент, где запирали на несколько месяцев людей и наблюдали что будет, и что там народ чуть друга друга не поубивал, и эксперимент прекратили. Такого не было, но я нагуглил, что был другой — СФИНКС в 1999 году.

Там было несколько групп. В первой было четыре россиянина и они под новый год на праздновании с алкоголем набили друг другу морду (10 минут, кровь, разнимали). Еще в одной было трое парней и девушка (Джудит Лапьер) и миссия завершилась, потому что под новый год на радостях Джудит постарались дважды поцеловать. На этом миссию прекратили.

Как пишет VICE, диалог был такой «Нам стоит попробовать поцеловаться, я не курил шесть месяцев. Потом мы сможем поцеловаться после миссии и сравнить. Давай проведем эксперимент сейчас».

В команде были врачи со степенями (Лукьянюк, Карашкин, Мурашов) и Хайдер Хобихожин, который по сути был кажется случайный техник со средним образованием, и который заменил японца справа на фото и который первый на втором фото. Кто там кому бил морду и целовал уже подзабыто.

Вадим Гущин, координатор от ИМБП, уже после скандала заявил, что драка была «дружеской», а Лапьер «испортила миссию, атмосферу, отказавшись быть поцелованной».

Лапьер в космическом агенстве Канады сказали, что такое поведение нормально для русских и что публичные жалобы будут считаться табу в культуре принимающей страны.

Захватывающее чтение на английском: «Project Hail Mary» | 2026-05-10T15:30:56

Прочитал пока где-то четверть project hail mary. Очень простой английский, легко читается, увлекательно, в фильме пока все идет почти по книге, но но из-за этого почти читать все-таки интересно. Но мне вообще сложно читать художественную литературу, потому что я постоянно отрываюсь гуглить всякое. Дошел до фразы «..I used the bathroom (or «head» I guess, because I was on the ship)…» и задумался, а интересно, оказывается, что туалет на судне не только в русском называется иначе. И почему head? оказалось, что гальюн — это и есть head, только на датском и немецком). Кстати, гальюн есть еще и на самолетах, а исторически гальюны были только для матросов, офицеры ими не пользовались.

Вообще текст очень детский, ну и понятно почему — главный герой все-таки учитель физики в школе. Все эти motherfluffer и dang it, gosh darn it, fudge, holy moly, for cripes’ sake вместо for christ’s sake, там даже есть bull-puckey вместо bullshit. «Сходить по-маленькому» там to go wee. Вспоминается, позавчера мы заходили в магазин матрасов, и там консультант, обсуждая поднятую тему «если один из вас идет в туалет, второй даже не заметит, что первый встал» — ну мол, матрасы такие мягкие — активно использовала глагол «пописать» (to pee). А что такого? 🙂

Update: когда учитель физики встречает инопланетный корабль на 120 странице, глава заканчивается holy fucking shit! Вот к чему было все остальное;)

Там периодически бывают довольно забавные выражения, которые можно даже использовать в жизни 🙂 например, главный герой спрашивает Who pooped in your Rice Krispies? — это идиома to poop in someone’s cereal — «кто тебе в кашу нагадил».

В общем, если выбираете первую книжку для прочтения на английском — это в моем рейтинге на первом месте. Например, даже простой казалось бы «Гарри Поттер» сложнее (sophisticated) на мой взгляд. Здесь куча диалогов, школьная, но почти без сленга лексика, и довольно интересный сюжет. Плюс это настоящая научная фантастика, где автор образовывает читателя, про научный метод, про устройство мира и т.д. это происходит от имени героя, учителя физики, где тот делится всякими фактами и размышлениями о том, как работает физика, в применении к сюжету в общении с другими героями или сам с собой (а не с читателем). На уровне школьной программы 6-8 класса пока, но может дальше будет посложнее.

Разочарование в «Project Hail Mary» | 2026-05-04T16:40:03

Сходили вчера на Project Hail Mary. Честно говоря, совсем не понравилось ни мне, ни Наде. Может, мы просто выросли из возраста, кому такие кино нравятся. Комикс-стайл. Сам инопланетянин, на мой взгляд, появился из экономии. Мне кажется, уровень начала 2000-х годов — тогда можно было бы сделать вот точно тоже самое. Тот же фильм Прибытие вспомните, где пыталить сделать что-то придумать необычное. Ну правда, это каменое уродство стоило 200М? Весь сюжет полон условностей и банальностей. За минуту они сделали так, что человек и инопланетянин начали прекрасно друг друга понимать с помощью какой-то программы, которую учитель естествознания создал за день. Мол, пусть астронавт и кусок камня сразу начинают болтать как приятели.. 5 километров железной цепи толщиной в указательный палец это где-то 10 тонн металла … это у них на корабле было столько?

Режиссеры стали успешными на поприще мультфильмов Лего-фильм и Осадки в виде фрикаделек, парой комедийных сериалов и Мачо и ботан. Я ожидал фильма в духе Интерстеллара или Марсианина, умного взрослого sci-fi, который не боится научных деталей, а получил детскую сказку с некрасивым инопланетянином.

Погуглил, оказалось, что прям до фига народу в восторге от этого, и кассу собирает.. Вероятно, люди соскучились по такому среди постиронии, сатиры, повесточек разных, Лантимоса и «Битвы за битвой». В детстве все смотрели «Полет навигатора» и «Короткое замыкание», ну вот взрослые ностальгируют по простому добру. Возможно, что это просто такой семейный фильм, для просмотра с детьми. Тогда может и норм.

ну ок, возвращаемся к просмотру второго сезона Succession. Он значительно лучше.

Словесные паттерны в религиозной литературе: анализ на основе Project Gutenberg | 2026-05-02T03:28:59

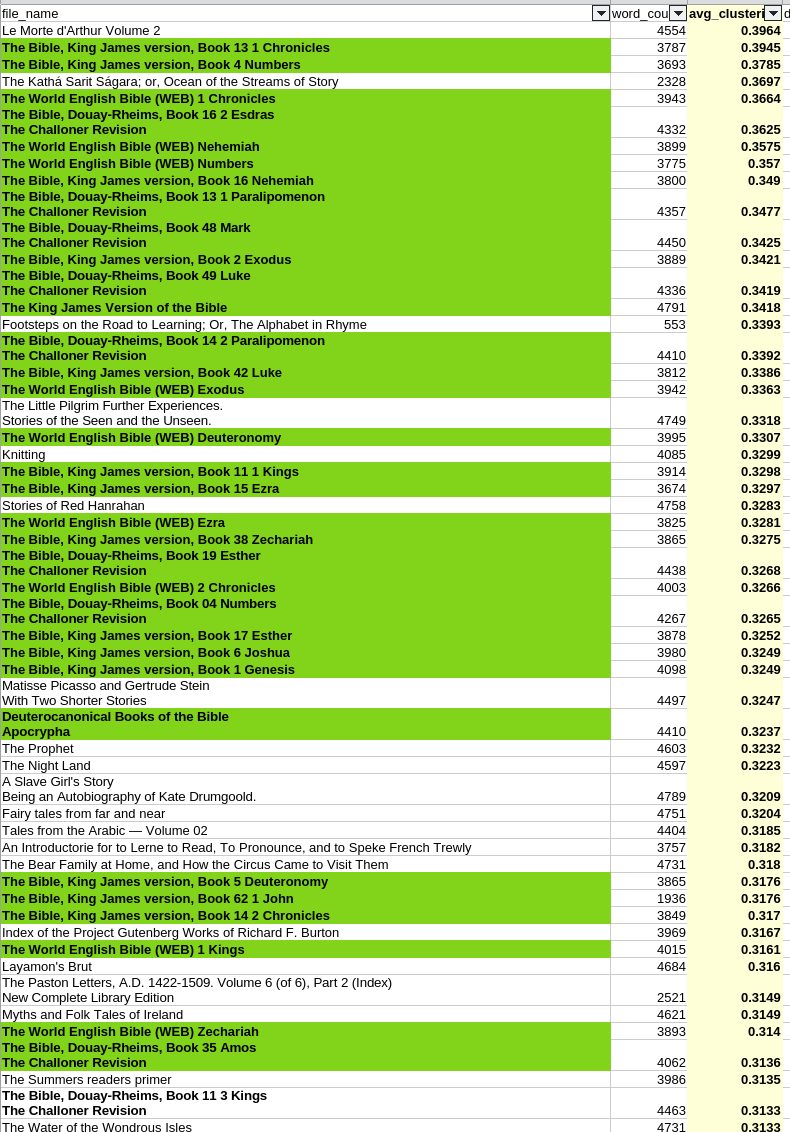
Интересно, что если взять 8000 книг из библиотеки Гутенберга, и по каждой построить по словам граф, чтобы посмотреть, насколько «дружны» слова — если слово А часто встречается с Б, а Б с В, то как часто А встречается с В — для этого есть метрика — средний коэфициент кластеризации, а затем просто отсортировать книги по уменьшению этого коэфициента, то процентов 70 топа будут составлять религиозные книги — библии, книга мормонов, Коран. Ну хорошо, часть из них являются дубликатами в каком-то смысле, потому что Библия в разных вариантах остается Библией. Но тут явно сгруппированы ее разные части, то есть, они явно имеют общность в этих треугольных словах.

Но что объединяет вообще все книги этого топа — это то, что они написаны много лет назад или, как в случае The Night Land, написаны относительно недавно в том же стиле, как много лет назад.

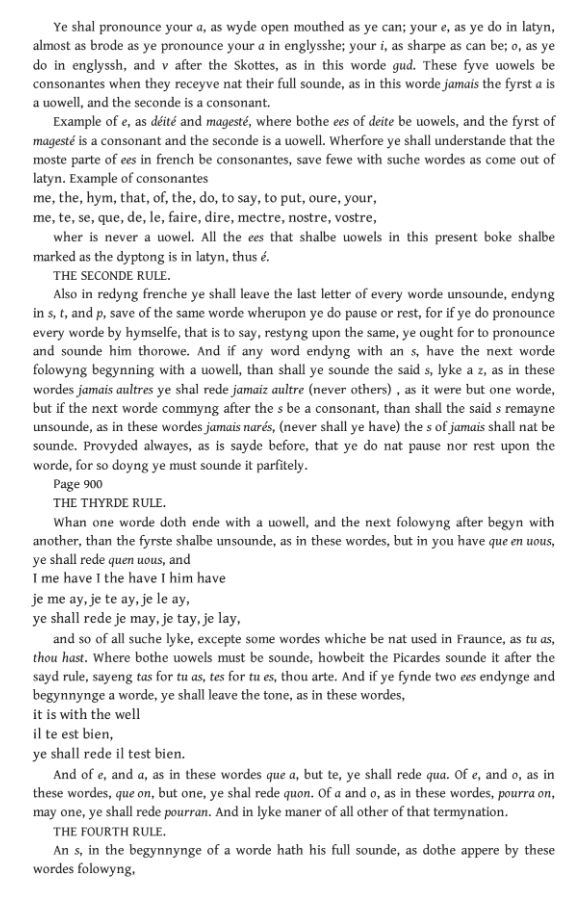
Кстати, среди этих книг светится An Introductorie for to Lerne to Read, To Pronounce, and to Speke French Trewly. Это учебник по французскому языку, написанный на английском языке времен Тюдоров (примерно 1530-е годы). Soverayn lorde kyng Henry the Eight. Написал его Жиль дю Гез (Gilles Du Guez) — учитель французского языка при английском дворе. Этот конкретный учебник был составлен для принцессы Марии (будущей королевы Марии I, известной как «Кровавая Мэри»), дочери Генриха VIII. Зацените страничку из учебника. Очень прикольный английский 🙂 …ye must pronounce it letyng your lippes jointe close, so that there be but a lyttell hole in the middes.

Так вот, я вчитался в этот учебник. Там упоминается фрукт под названием «openarses». Как вы понимаете, это «открытые задницы» по-английски. Так в тюдоровской Англии называли мушмулу (medlar). Если вы погуглите, как выглядит мушмула, у вас не будет вопросов почему это openarses 😉

В анатомическом разделе (MEMBRES LONGYNG TO MANNES BODY) автор рядом с глазами и ушами упоминает «the nether beerde» (дословно — «нижняя борода»).

Преобразование чата в семантический поиск вопрос-ответ | 2026-04-30T04:05:37

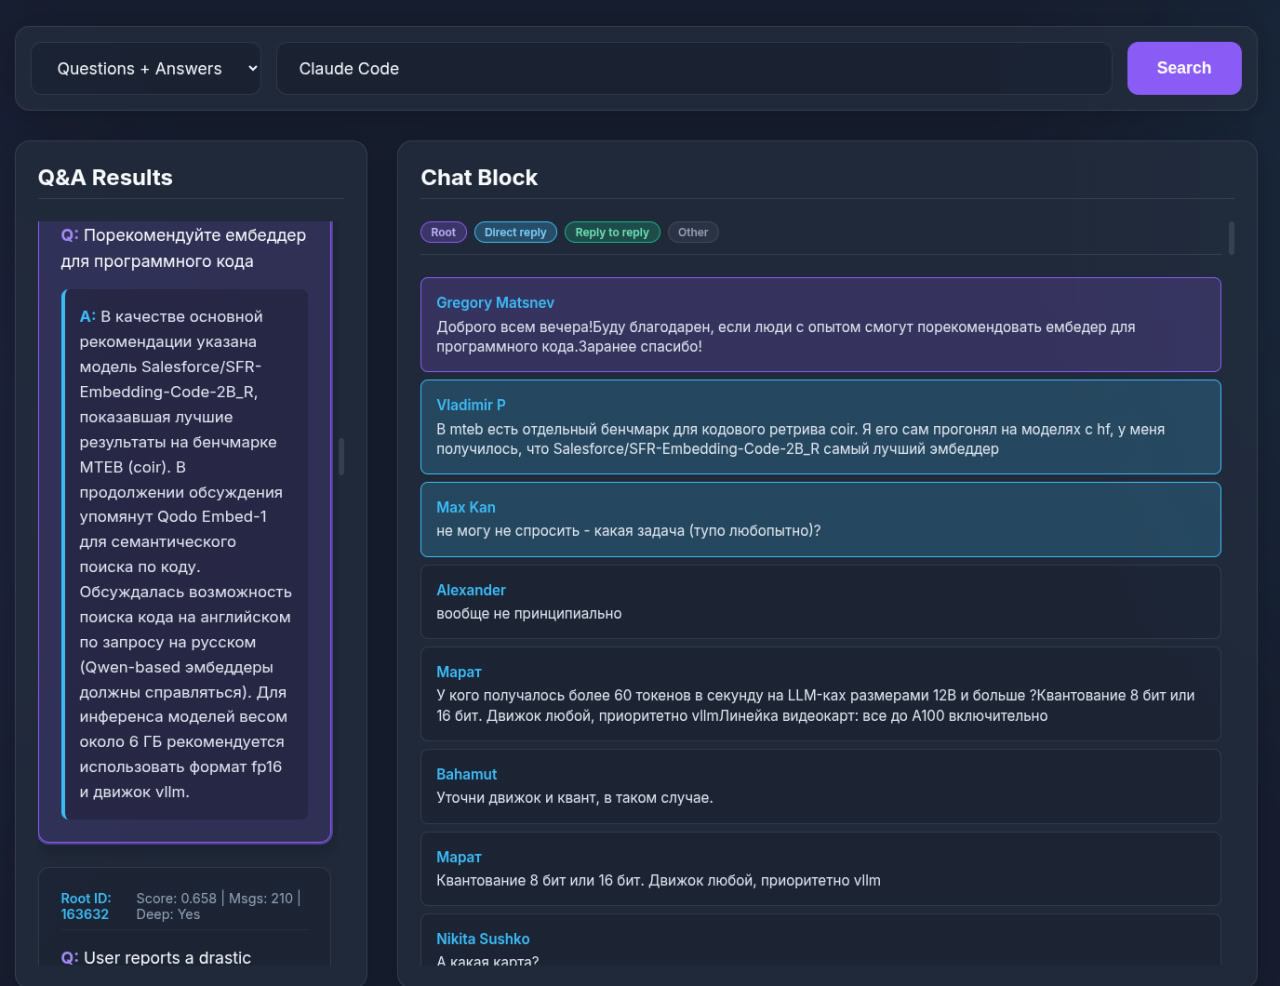
За вечер сделал простую утилитку, которая вытаскивает чат Natural Language Processing за полтора года — там 65 тысяч сообщений, и переводит его в пары вопрос-ответ, по которым есть семантический поиск. При клике на результат поиска (слева) открывается диалог в чате. Подсвечиваются те сообщения, которые являются ответами на вопрос. Ну и сверху подсвечивается вопрос а оригинальной формулировке.

Как работает: система предполагает, что люди в основном делают reply to на сообщения, находящиеся относительно близко в прошлом. Если на одно сообщение делается несколько reply-to, то наверняка оно полезное, и зацепило в чате других. Система берет сообщения, начиная с того, на которое многие отвечали, и заканчивая последним в цепочке reply-to — и среди таких берет те, которые имеют минимум 3 reply-to к оригинальному вопросу. То есть, по сути, она вырезает из чата кусок, начинающийся популярным вопросом так, что после нижнего отреза скорее всего уже идет нерелевантное. Такие блоки могут накладываться друг на друга — например, если кто-то спросил, пока другие отвечали на что-то еще.

То есть, если пользователь А спросил какая погода, и ему ответили «хорошая», «плохая», «дождь», и еще было пять сообщений без reply-to, а потом кто-то ответил на «дождь» вопросом «почему дождь», и на этот вопрос ответили еще пятеро, то в систему попадет первый вопрос про погоду — кусок будет заканчиваться 13 сообщениями.

Дальше эти куски суммаризуются в вопрос-ответ.

Получается прикольно.

П. С. На скриншоте поисковый запрос не имеет отношения к результату поиска, потому что я сдуру сделал скриншот, когда запрос ещё поменял, а отправить ещё не нажал

Иллюзия скрытой линии | 2026-04-29T17:56:08

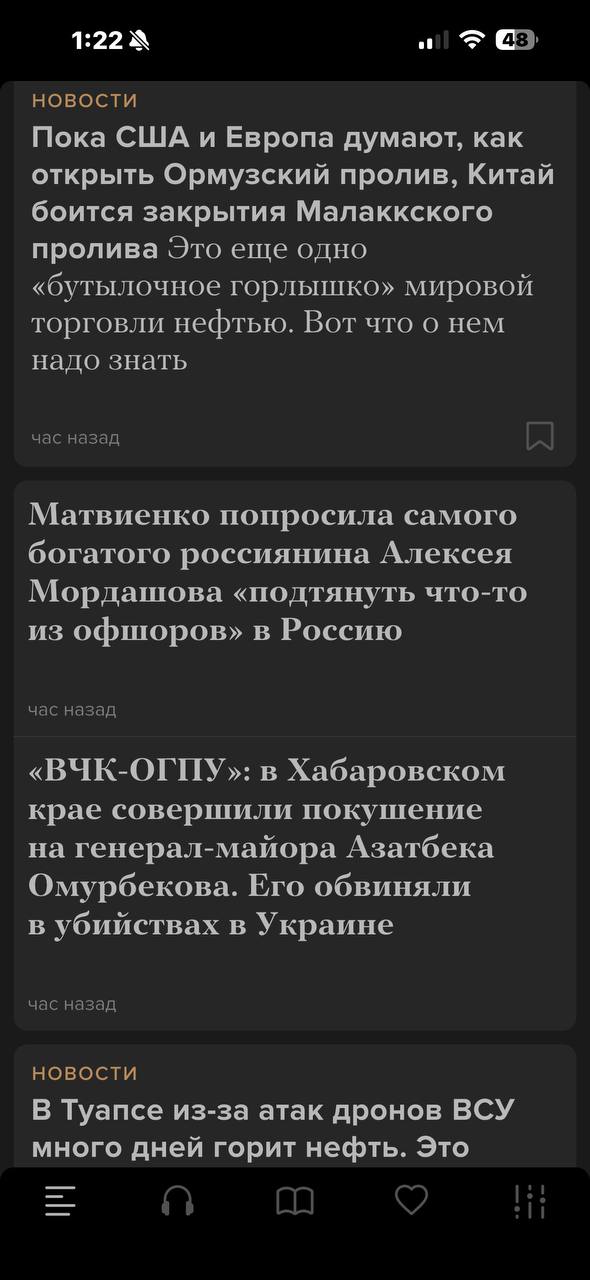
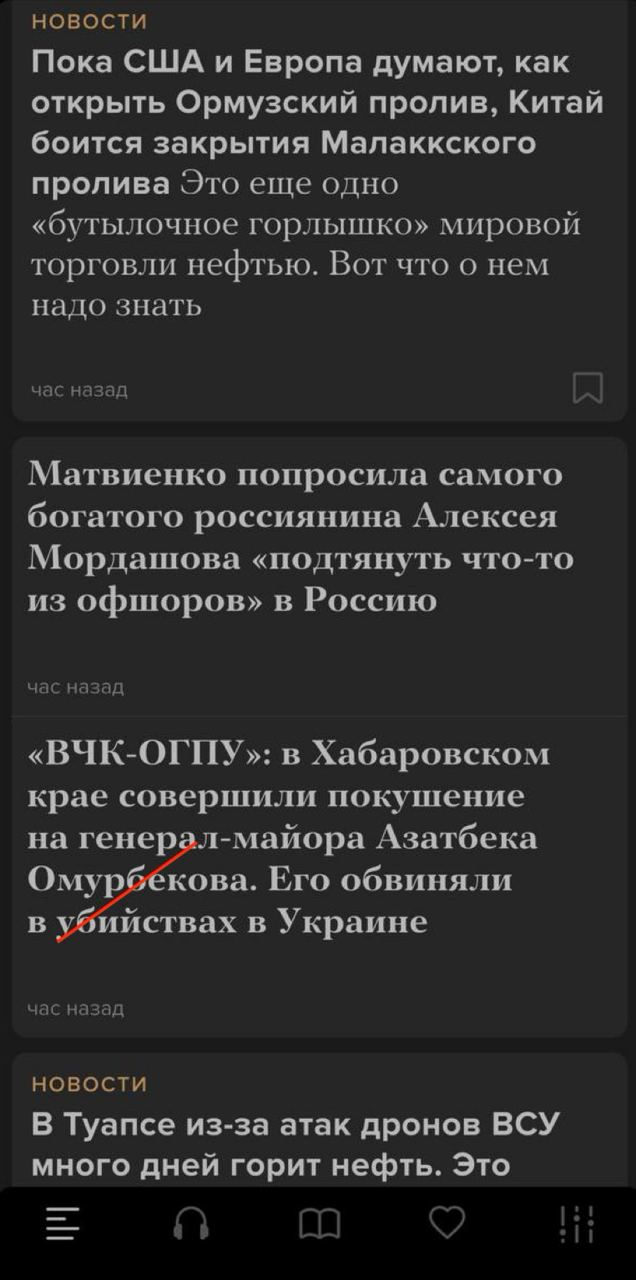
Пытаюсь понять, это у меня одного так глаза работают или нет 🙂 если смотреть на любое место, кроме слова «Омурбекова», то боковым зрением четко выделяется линия, показанная на втором скриншоте красным цветом (но конечно, она белая). Как только возвращаешь глаза на нее, линии нет. То есть, она видна только боковым зрением. Делитесь, как у вас 🙂

Синие лучи ядерной активности: Вавиловочеренковское излучение на САЭС | 2026-04-26T23:52:10

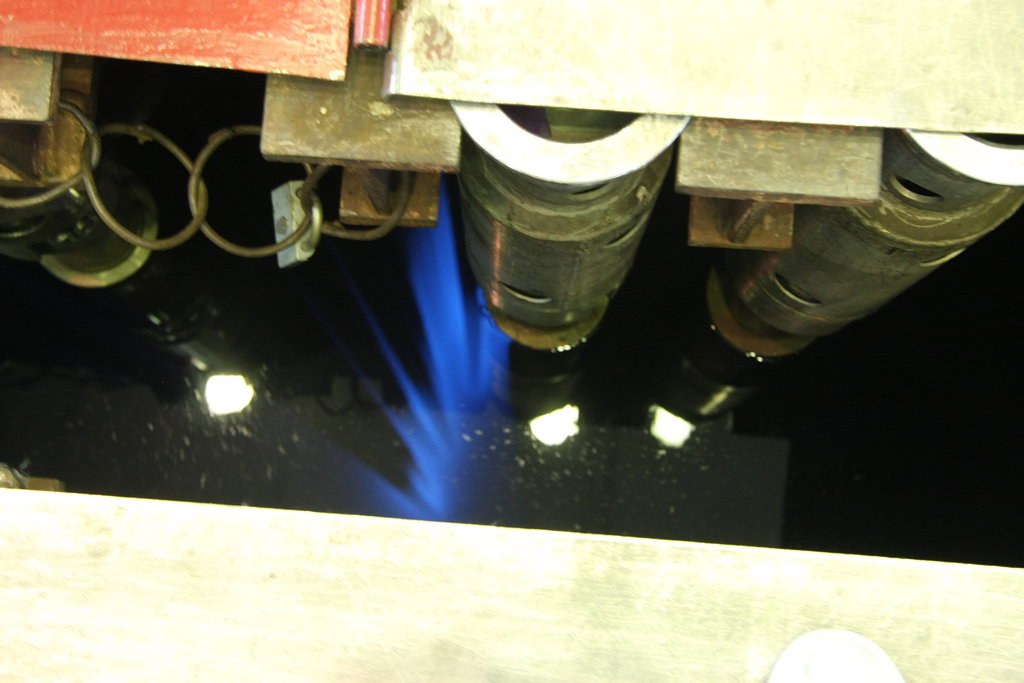
На картинке — вавиловочеренковское излучение. Это я в 2009 году был на САЭС, стою в зале с ядерным реактором. Вода на фото — для замедления нейтронов и охлаждения отработанных стержней с ядерным топливом. Свечение возникает, когда электроны вылетают из топлива со скоростью, превышающей фазовую скорость света в воде. Типа звукового барьера, только для света. По интенсивности этого свечения можно на глаз примерно определить, насколько «свежее» топливо находится в бассейне. Чем ярче и гуще синева, тем активнее идут процессы распада. Интересно, что черенковское излучение является причиной, по которой на многокилометровой глубине океанского дна не бывает абсолютной темноты.