Искусство свиста: от Сильбо Гомеро до ручного оркестра | 18 октября 2026 года, 16:03

Узнал, что есть язык, построенный целиком на свисте. Гуглите Silbo Gobero. Это свистящий язык на Канарских островах, свистящий диалект испанского. И там довольно много жителей могут общаться на нём. Носителя сильбо гомеро называют сильбадором (свистуном). В 2009 язык занесён в Список шедевров устного и нематериального культурного наследия человечества. На Youtube много роликов на тему.

Задумался, что человечество стремительно теряет скилл свистеть. Губами в трубочку еще кто и умеет, но всеми остальными способами кажется, никто.

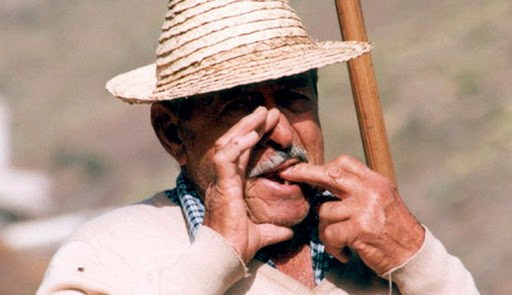
Кроме него есть нёбный свист (ищите palatal whistle, roof of mouth whistle) — резче и пронзительнее губного, лучше пробивает шум, но высота почти не меняется. Есть еще свист через свёрнутый язык (ищите rolled tongue whistle, taco tongue whistle) — низкий, глухой, похож на сову, но пишут, что получается не у всех (может, генетика). С пальцами во рту — погромче (мойте руки!). Два пальца одной руки (указательный + средний или большой + указательный «колечком») — 100-115 дБ, до 1 км в тишине. Как раз это основа Сильбо Гомеро — высоту меняют губами и глубиной погружения пальцев, так что кодировать можно многое. Один палец (указательный или мизинец крючком) — почти та же громкость, вторая рука свободна. Пальцы обеих рук (по одному или по два с каждой стороны) — самый громкий ручной свист, до 120 дБ, в горах через ущелье 2-3 км. Большие пальцы обеих рук (ногтями к языку) — громкий, низковатый, традиция пастухов Пиренеев, Кавказа, Балкан.

Есть еще свист в сложенные ладони — низкий, 300-600 Гц, слышно на 100-300 м, но низкий звук огибает деревья и кусты, поэтому в лесу он несёт дальше высокого. Высоту меняют, приоткрывая пальцы, — можно свистеть 5-8 нот.
Илон Маск: вдохновение из культовых фильмов | 16 октября 2026 года, 15:55

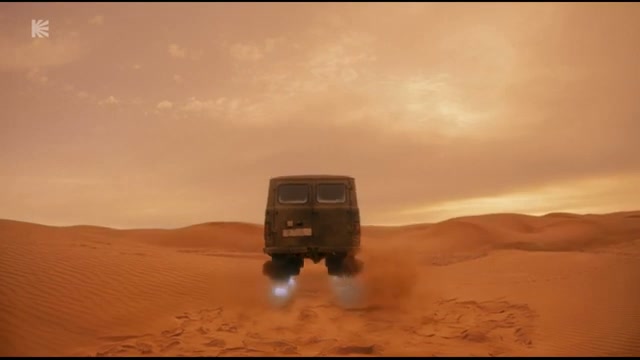
Ну все понятно, Маск просто отсюда все тырит. Сначала пепелац из Кин-Дза-Дза, потом вот машина из Кибердеревни

Скрытые возможности FlexibleSearch в SAP Commerce Cloud | 14 октября 2026 года, 12:50

Опубликовал новую статью на Hybrismart — про недокументированные особенности FlexibleSearch (SAP Commerce Cloud / Hybris). Актуально, если вы как-то работаете с этой платформой. Если нет — можете прислать тем, кто работает 🙂

Я теперь публикую статьи на трех языках — RU, ENG, UKR. Понятно, что автоматический перевод на русский и украинский с английского. Но многим удобнее читать на родном.

https://hybrismart.com/2026/10/13/flexiblesearch-2026-rus/

https://hybrismart.com/2026/10/13/flexiblesearch-2026-rus/

Ночной спутник: кровать с голосовым помощником | 13 октября 2026 года, 17:45

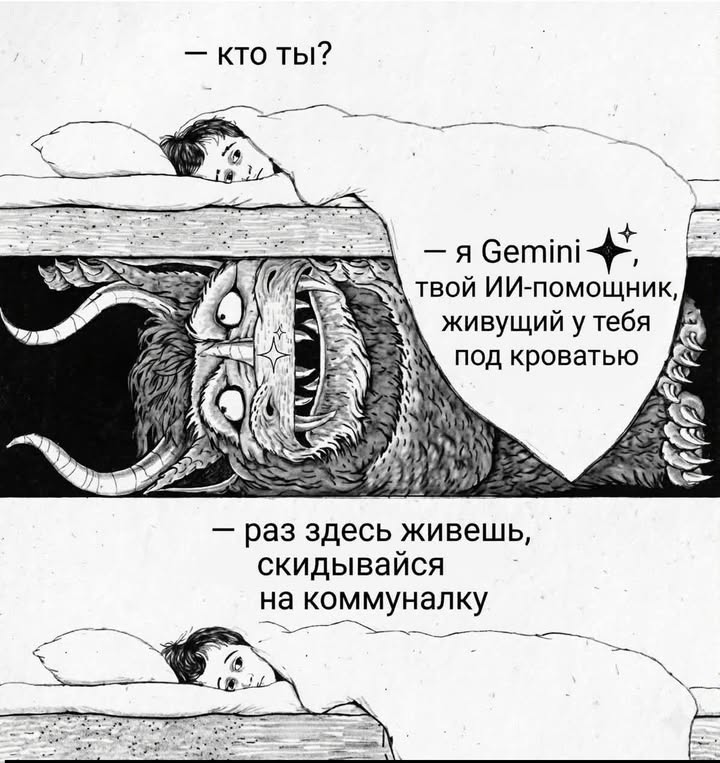
Интересно, а что если вмонтировать голосового помощника в кровать? Чтобы слушал нонстоп, и отвечал. Все равно обычно в спальне в течение дня никого нет. Надо только закастомизировать, чтобы аудиокниги читала и сама умолкала, если хозяин вроде уснул.

А у, круто ж было бы. Вот ложишься, три часа ночи, сна ни в одном глазу. Ты тяжело вздыхаешь, переворачиваешься на другой бок, и тут в тишине из-под кровати раздается приглушенный, бархатный баритон:

— Опять экзистенциальный кризис, Олег?

«Понимаю,» — сочувственно вибрирует матрас. — «Хочешь, сказку расскажу? Или, может, погрузимся в жестокий мир бадминтона? Я тут скачал статью, как китайские девственницы ощипывают редких гусей для перьевых воланчиков. Там интриг больше, чем в «Игре престолов». Гусь по имени Гао…»

Ну нет, давай что-нибудь про нейросети, говоришь ты.

«О да… слушай сюда, мой сладкий дата-сайентист… Архитектура JEPA не пытается восстановить пиксели… она слишком хороша для этого… она предсказывает только абстрактные фичи в скрытом пространстве… А вот Dreamer…» — тут кровать может сделать театральную паузу и слегка подпружинить. — «Dreamer строит целую модель мира… он генерирует воображаемые траектории, Олег… Проведи рукой по наматраснику, и я расскажу тебе про марковские процессы принятия решений…»

Классная штука была бы

Ремонт самокатов в США: выгода и затруднения | 12 октября 2026 года, 17:43

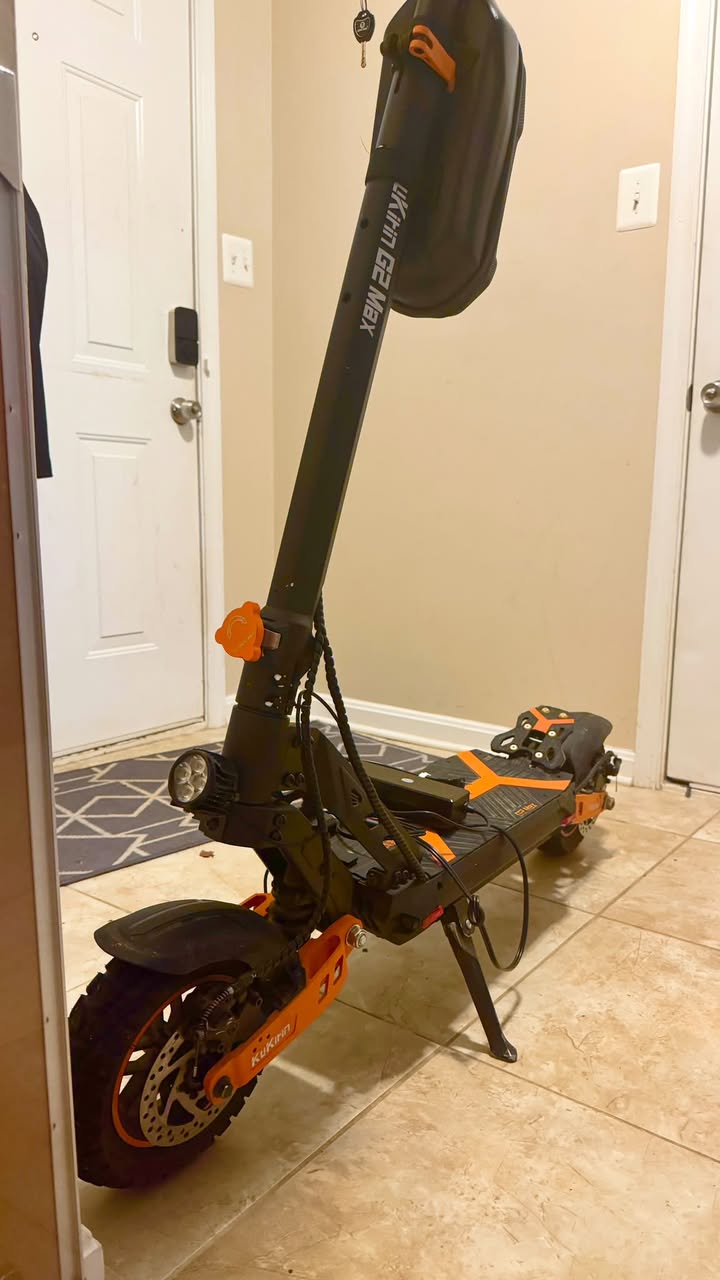
В США очень плохо с ремонтом самокатов. Пришлось делать все самому. Но перед этим я очень искал. Звонил в разные магазины с сервисом e-bikes, спрашивал. Условно тормоза подрегулировать — это в любом месте. А разобраться что с электрикой — никто не берётся. При этом большинство самокатов очень простые внутри. Говорю ответственно, потому что кроме этого у меня ещё один в гараже на выброс, я его пытался чинить, забил, купил новый.

В целом, электровелосипеды имеют похожую начинку. Но поскольку брендов много (все китайские), запчасти надо заказывать и ждать неделями, ремонт вовлекает людей с высокой почасовой ставкой, часто тупо экономически невыгодно ремонтировать. Но иногда всё-таки выгодно, но рынка нет — видимо, не хватает объёма, или люди не заморачиваются, а идут покупают новый.

Мой самокат стоит около 1000 долл. Ремонт мне обошёлся в 30 долл. Я купил новый fuse holder и в него новый предохранитель на 40A. Предыдущий предохранитель на 40А расплавился вместе с fuse holder. Я было думал, что где-то коротит, но нет, это там правда токи до 25А, и видимо они нагревают holder который почему-то там стоит на меньший допустимый ток. Поскольку тёплу отводиться некуда, и плавится. А конструктивно любой самокат это батарея +контроллер мотора(ов) + бортовой компьютер, совмещённый с дисплеем, и колёса с мотором внутри. То есть, в случае немеханической поломки надо просто поменять один из этих четырёх компонентов, они продаются все.

BloomSpan: Новый алгоритм поиска повторяющихся фраз в больших текстах | 12 октября 2026 года, 04:10

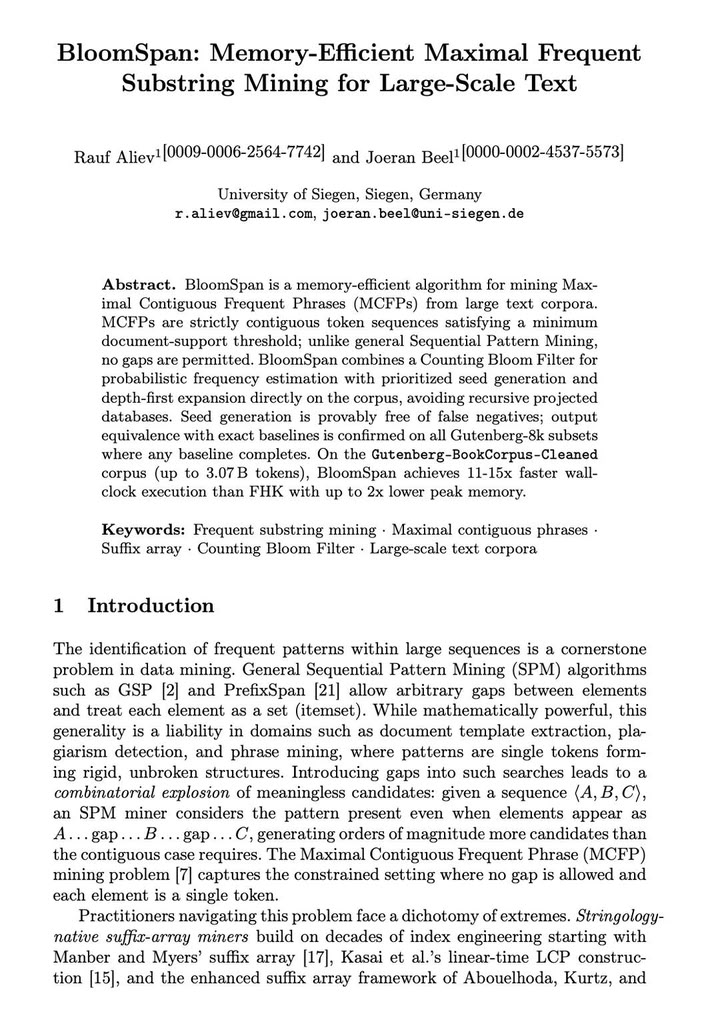
Хочу поделиться нашей свежей работой — алгоритм BloomSpan по поиску наиболее длинных частых последовательностей слов в массиве текстов. Я его назвал BloomSpan.

О чём это, если по-человечески. Представьте, что у вас есть библиотека из 50000 книг, и нужно найти все длинные фразы, которые повторяются во многих разных книгах слово в слово, без пропусков. Не «похожие» фразы, а именно одинаковые цепочки слов, причём максимально длинные — такие, что если добавить ещё одно слово слева или справа, фраза уже перестаёт встречаться достаточно часто. Задача звучит просто, но на миллиардах слов она упирается в память и время. Классические алгоритмы либо строят огромные индексы, либо перебирают слишком много кандидатов.

Где это нужно? Например, вытаскивать шаблоны из документов (например, одинаковые «шапки» в письмах или договорах), искать заимствования и плагиат, выделять устойчивые фразы и клише в больших текстовых массивах.

Так вот, что получилось. Алгоритм. Честно говоря, BloomSpan — это не прям алгоритм с нуля, а аккуратная сборка из известных идей, которые вместе дают сильный эффект. В базе — разные идеи от BIDE+, FHK, и поверх всего этого: (а) Фильтр Блума — компактная структура, которая отвечает на вопрос «встречалось ли это сочетание слов достаточно часто?», не храня сами сочетания. Она может иногда ошибиться в сторону «да», но никогда — в сторону «нет», поэтому мы гарантированно не теряем ни одной нужной фразы (б) Поиск «в глубину» прямо по тексту — находим короткое частое ядро и постепенно наращиваем его в длинную фразу, не создавая промежуточных копий корпуса. (в) Карта занятости — отмечаем в тексте позиции, уже «покрытые» найденными фразами, чтобы не проверять одно и то же по многу раз.

Что получилось. На корпусе из 50 тысяч книг Project Gutenberg (около 3 миллиардов слов) BloomSpan работает в 11-15 раз быстрее классического алгоритма FHK и съедает до двух раз меньше памяти. Это единственный из протестированных методов, который вообще дошёл до конца на полном корпусе в пределах 40 ГБ. При этом результат полностью совпадает с точными алгоритмами там, где они успевают отработать — то есть ускорение не за счёт качества.

На искусственных же данных с «неестественным» распределением слов старый добрый FHK быстрее. Bloomspan заточен именно под живой естественный язык, и в статье разбирается, почему так.

Препринт и код (Java) — в комментариях

Неудобства мультиаккаунтинга в Google: что не так? | 11 октября 2026 года, 04:47

Вот вроде гугл мощная умная компания, но если ты залогинен в нескольких учетках 1) нельзя выйти из одной, можно только из всех 2) нет иного способа сменить дефолтную (ту, что открывается при заходе в gmail, например) в первой залогиненной на какую-то другую иначе, чем выйдя из всех аккаунтов и зайдя по нужной первой (а следом остальные)

Фото вместо телевизора: новый тренд или старая традиция? | 29 сентября 2026 года, 19:52

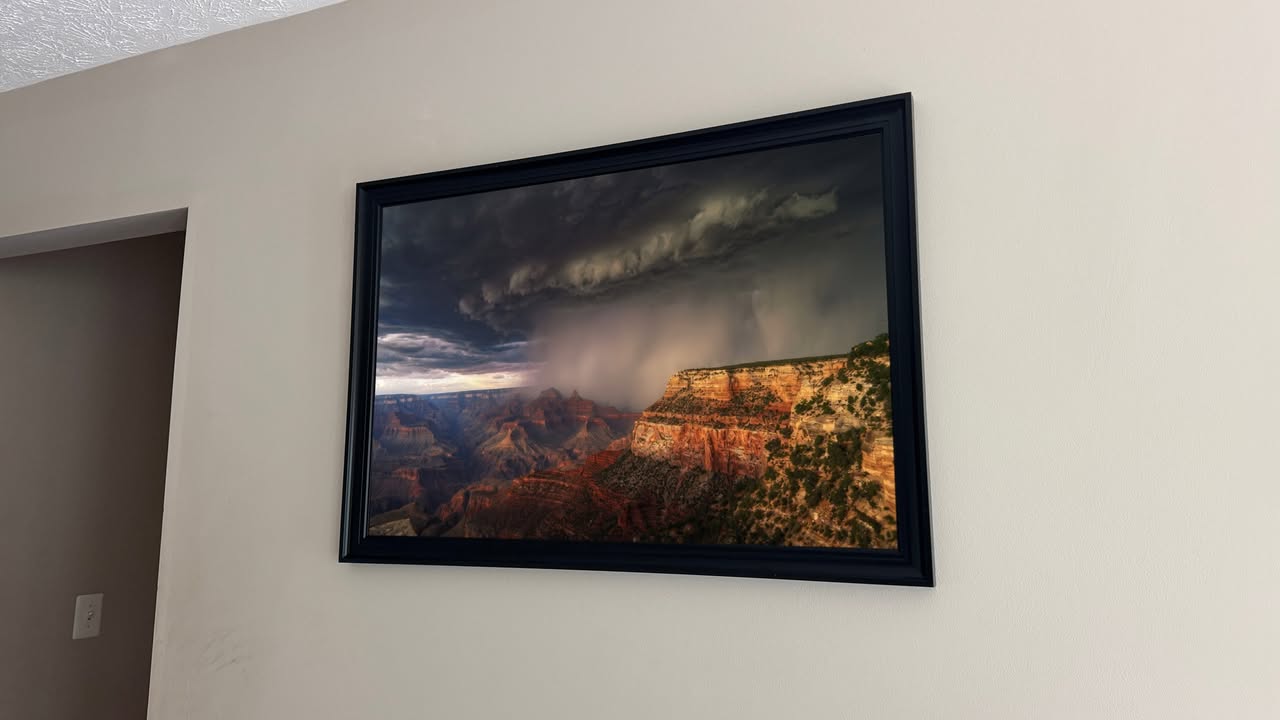
Ну что, моя фотка теперь на стене (там, где у нормальных американцев телек)

Имена в Южной Индии: Традиции и Значения | 29 сентября 2026 года, 15:06

СЯУ что имена коллег из Индии типа Sakthi S в LinkedIn такие почти всегда не из желания скрыть свое полное имя, а потому что в южной Индии оно примерно так и есть. Там традиционно нет фамилий в европейском смысле. Вместо этого к личному имени добавляется инициал имени отца. Так что «Sakthi S» — это, скорее всего, Сакти, сын какого-нибудь Селвама, Субраманиана или Сентила. В самой Индии это чаще пишут наоборот, с инициалом впереди: «S. Sakthi». Соответственно, D в конце — отец на D (Дурай, Динеш), A — на A (Арумугам, Анандан) и т.д. У дочери будет тот же инициал, а после замужества иногда меняется на инициал мужа.

Классический пример — математик Srinivasa Ramanujan: «Srinivasa» — это имя отца, а не фамилия, дома его звали просто Рамануджан.

В Тамилнаде это ещё и осознанная позиция — дравидское движение (Перияр) активно призывало отказаться от кастовых фамилий, потому что по ним сразу видно кастовую принадлежность. Инициал отца ничего такого не выдаёт.

Интересно, что когда спрашиваешь об этом Gemini, тот говорит, что его программа не рассчитана на такие задачи, и что он не понимает меня и не может ответить, и что он просто языковая модель, и таких возможностей у него нет. А Клод норм, отвечает.

Для скриншота взят просто рандомный менеджер из Linkedin.