Ночной спутник: кровать с голосовым помощником | 13 октября 2026 года, 17:45

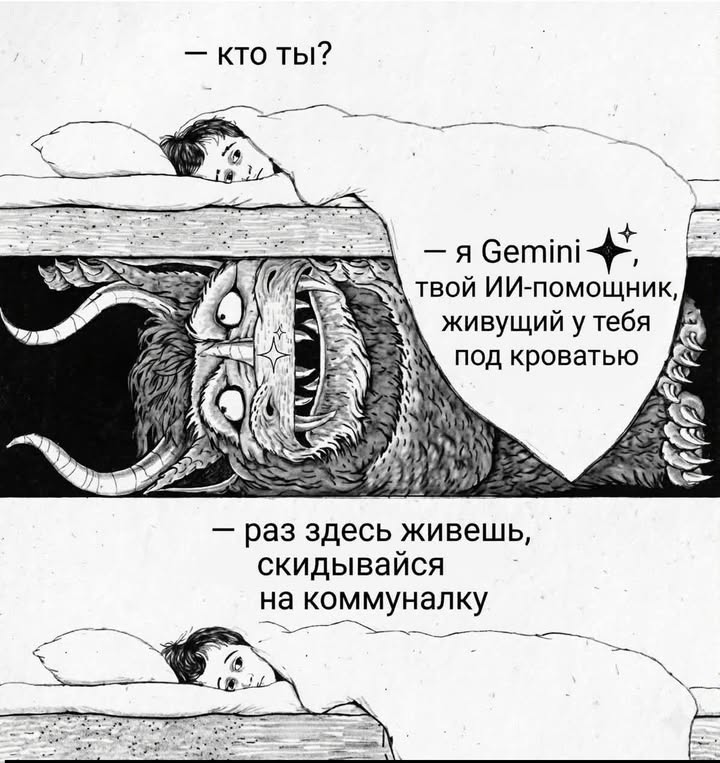
Интересно, а что если вмонтировать голосового помощника в кровать? Чтобы слушал нонстоп, и отвечал. Все равно обычно в спальне в течение дня никого нет. Надо только закастомизировать, чтобы аудиокниги читала и сама умолкала, если хозяин вроде уснул.

А у, круто ж было бы. Вот ложишься, три часа ночи, сна ни в одном глазу. Ты тяжело вздыхаешь, переворачиваешься на другой бок, и тут в тишине из-под кровати раздается приглушенный, бархатный баритон:

— Опять экзистенциальный кризис, Олег?

«Понимаю,» — сочувственно вибрирует матрас. — «Хочешь, сказку расскажу? Или, может, погрузимся в жестокий мир бадминтона? Я тут скачал статью, как китайские девственницы ощипывают редких гусей для перьевых воланчиков. Там интриг больше, чем в «Игре престолов». Гусь по имени Гао…»

Ну нет, давай что-нибудь про нейросети, говоришь ты.

«О да… слушай сюда, мой сладкий дата-сайентист… Архитектура JEPA не пытается восстановить пиксели… она слишком хороша для этого… она предсказывает только абстрактные фичи в скрытом пространстве… А вот Dreamer…» — тут кровать может сделать театральную паузу и слегка подпружинить. — «Dreamer строит целую модель мира… он генерирует воображаемые траектории, Олег… Проведи рукой по наматраснику, и я расскажу тебе про марковские процессы принятия решений…»

Классная штука была бы

Ремонт самокатов в США: выгода и затруднения | 12 октября 2026 года, 17:43

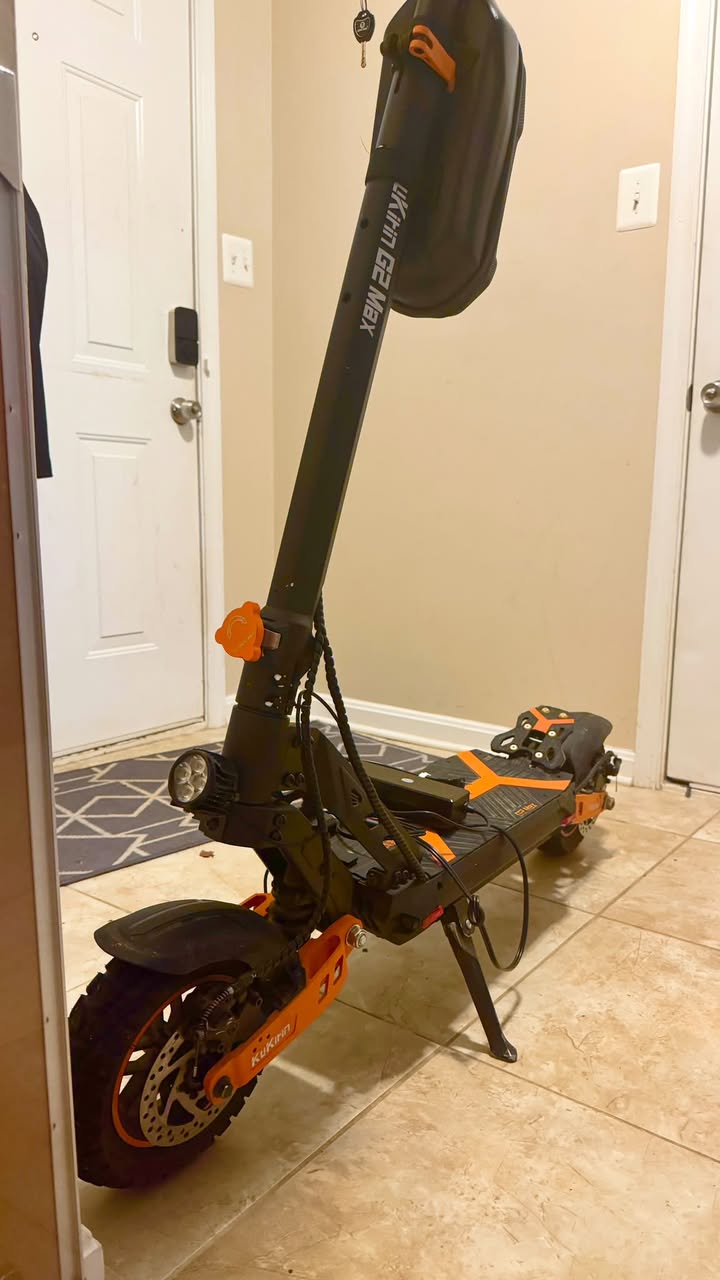
В США очень плохо с ремонтом самокатов. Пришлось делать все самому. Но перед этим я очень искал. Звонил в разные магазины с сервисом e-bikes, спрашивал. Условно тормоза подрегулировать — это в любом месте. А разобраться что с электрикой — никто не берётся. При этом большинство самокатов очень простые внутри. Говорю ответственно, потому что кроме этого у меня ещё один в гараже на выброс, я его пытался чинить, забил, купил новый.

В целом, электровелосипеды имеют похожую начинку. Но поскольку брендов много (все китайские), запчасти надо заказывать и ждать неделями, ремонт вовлекает людей с высокой почасовой ставкой, часто тупо экономически невыгодно ремонтировать. Но иногда всё-таки выгодно, но рынка нет — видимо, не хватает объёма, или люди не заморачиваются, а идут покупают новый.

Мой самокат стоит около 1000 долл. Ремонт мне обошёлся в 30 долл. Я купил новый fuse holder и в него новый предохранитель на 40A. Предыдущий предохранитель на 40А расплавился вместе с fuse holder. Я было думал, что где-то коротит, но нет, это там правда токи до 25А, и видимо они нагревают holder который почему-то там стоит на меньший допустимый ток. Поскольку тёплу отводиться некуда, и плавится. А конструктивно любой самокат это батарея +контроллер мотора(ов) + бортовой компьютер, совмещённый с дисплеем, и колёса с мотором внутри. То есть, в случае немеханической поломки надо просто поменять один из этих четырёх компонентов, они продаются все.

BloomSpan: Новый алгоритм поиска повторяющихся фраз в больших текстах | 12 октября 2026 года, 04:10

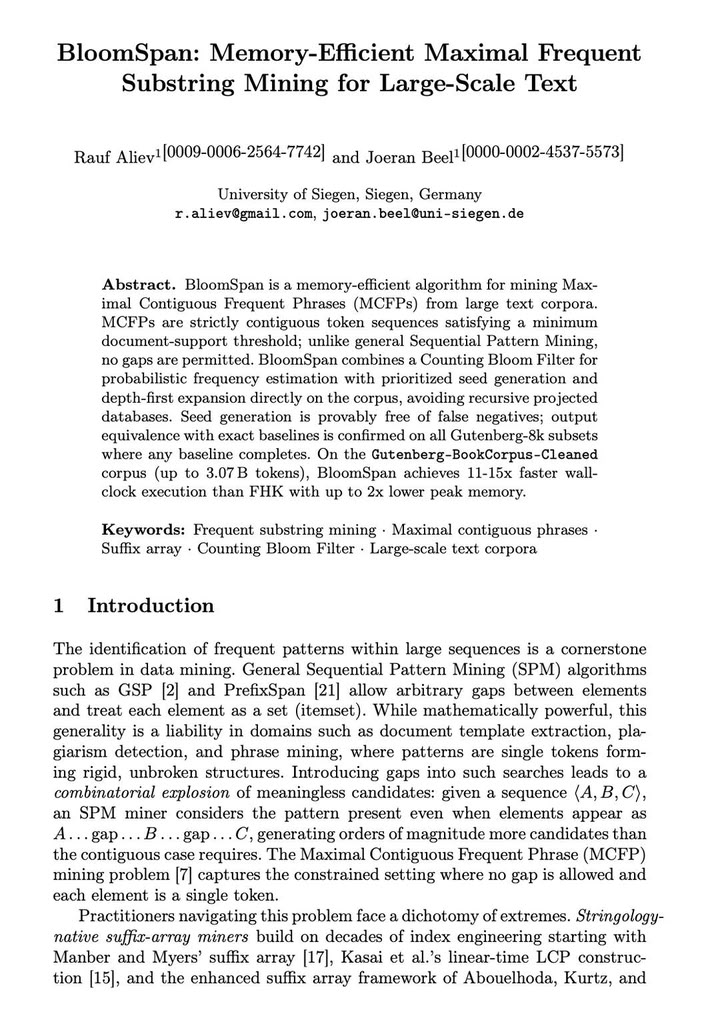
Хочу поделиться нашей свежей работой — алгоритм BloomSpan по поиску наиболее длинных частых последовательностей слов в массиве текстов. Я его назвал BloomSpan.

О чём это, если по-человечески. Представьте, что у вас есть библиотека из 50000 книг, и нужно найти все длинные фразы, которые повторяются во многих разных книгах слово в слово, без пропусков. Не «похожие» фразы, а именно одинаковые цепочки слов, причём максимально длинные — такие, что если добавить ещё одно слово слева или справа, фраза уже перестаёт встречаться достаточно часто. Задача звучит просто, но на миллиардах слов она упирается в память и время. Классические алгоритмы либо строят огромные индексы, либо перебирают слишком много кандидатов.

Где это нужно? Например, вытаскивать шаблоны из документов (например, одинаковые «шапки» в письмах или договорах), искать заимствования и плагиат, выделять устойчивые фразы и клише в больших текстовых массивах.

Так вот, что получилось. Алгоритм. Честно говоря, BloomSpan — это не прям алгоритм с нуля, а аккуратная сборка из известных идей, которые вместе дают сильный эффект. В базе — разные идеи от BIDE+, FHK, и поверх всего этого: (а) Фильтр Блума — компактная структура, которая отвечает на вопрос «встречалось ли это сочетание слов достаточно часто?», не храня сами сочетания. Она может иногда ошибиться в сторону «да», но никогда — в сторону «нет», поэтому мы гарантированно не теряем ни одной нужной фразы (б) Поиск «в глубину» прямо по тексту — находим короткое частое ядро и постепенно наращиваем его в длинную фразу, не создавая промежуточных копий корпуса. (в) Карта занятости — отмечаем в тексте позиции, уже «покрытые» найденными фразами, чтобы не проверять одно и то же по многу раз.

Что получилось. На корпусе из 50 тысяч книг Project Gutenberg (около 3 миллиардов слов) BloomSpan работает в 11-15 раз быстрее классического алгоритма FHK и съедает до двух раз меньше памяти. Это единственный из протестированных методов, который вообще дошёл до конца на полном корпусе в пределах 40 ГБ. При этом результат полностью совпадает с точными алгоритмами там, где они успевают отработать — то есть ускорение не за счёт качества.

На искусственных же данных с «неестественным» распределением слов старый добрый FHK быстрее. Bloomspan заточен именно под живой естественный язык, и в статье разбирается, почему так.

Препринт и код (Java) — в комментариях

Неудобства мультиаккаунтинга в Google: что не так? | 11 октября 2026 года, 04:47

Вот вроде гугл мощная умная компания, но если ты залогинен в нескольких учетках 1) нельзя выйти из одной, можно только из всех 2) нет иного способа сменить дефолтную (ту, что открывается при заходе в gmail, например) в первой залогиненной на какую-то другую иначе, чем выйдя из всех аккаунтов и зайдя по нужной первой (а следом остальные)

Имена в Южной Индии: Традиции и Значения | 29 сентября 2026 года, 15:06

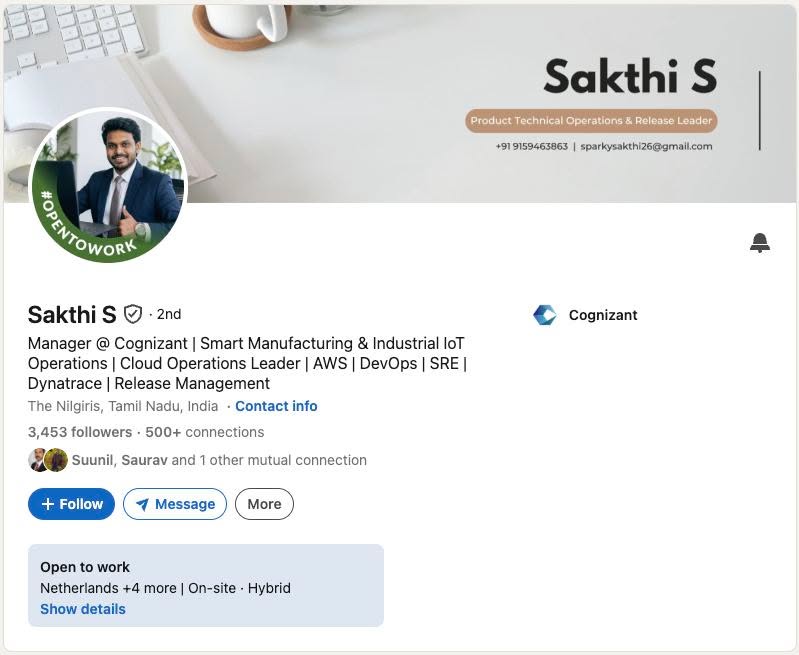
СЯУ что имена коллег из Индии типа Sakthi S в LinkedIn такие почти всегда не из желания скрыть свое полное имя, а потому что в южной Индии оно примерно так и есть. Там традиционно нет фамилий в европейском смысле. Вместо этого к личному имени добавляется инициал имени отца. Так что «Sakthi S» — это, скорее всего, Сакти, сын какого-нибудь Селвама, Субраманиана или Сентила. В самой Индии это чаще пишут наоборот, с инициалом впереди: «S. Sakthi». Соответственно, D в конце — отец на D (Дурай, Динеш), A — на A (Арумугам, Анандан) и т.д. У дочери будет тот же инициал, а после замужества иногда меняется на инициал мужа.

Классический пример — математик Srinivasa Ramanujan: «Srinivasa» — это имя отца, а не фамилия, дома его звали просто Рамануджан.

В Тамилнаде это ещё и осознанная позиция — дравидское движение (Перияр) активно призывало отказаться от кастовых фамилий, потому что по ним сразу видно кастовую принадлежность. Инициал отца ничего такого не выдаёт.

Интересно, что когда спрашиваешь об этом Gemini, тот говорит, что его программа не рассчитана на такие задачи, и что он не понимает меня и не может ответить, и что он просто языковая модель, и таких возможностей у него нет. А Клод норм, отвечает.

Для скриншота взят просто рандомный менеджер из Linkedin.

Интерактивные ресурсные планы в Claude Code | 29 сентября 2026 года, 14:10

Последнее время для пресейлов наловчился делать ресурсный план проекта через Claude Code. Очень круто получается. То есть, делаешь интерактивную модель с ползунками, которая показывает финальную стоимость проекта для указанной команды и указанной гибкости (каких-то ролей больше или меньше, какие-то этапы имеют больший резерв или меньший). Главное, что такая модель очень специфична для конкретного проекта и в целом бесполезна как шаблон для следующего, но сам принцип построения моделей один. В итоге подбираешь ползунками то, что одновременно выглядит believable и удовлетворяет уровню рисков, и видишь сумму, и дальше генеришь артефакты для клиента, которые после ручной доработки напильником (иногда большой) готовы для показа клиенту.

Smartfolio: Эволюция цифрового рабочего пространства | 26 сентября 2026 года, 12:51

Обновил свой smartfolio.me (Если коротко, это персональное рабочее пространство для знаний, построенное вокруг страниц, которые содержат другие страницы, — причём дочерняя страница может раскрывать выделенный фрагмент в контексте родительской. Вы пишете в полноценном редакторе — текст, формулы, изображения, встроенные PDF с аннотациями, сохранённые веб-страницы — и вместо того чтобы раскладывать документы по папкам, вставляете одну страницу внутрь другой, или создаете дочернюю как explanation через LLM выделенного фрагмента в контексте родительского документа. Входящие принимают материал извне, поиск находит то, что осталось без связей, а несколько LLM-плагинов умеют разобрать сырую расшифровку на связанные разделы, собрать целое поддерево в один документ, перевести страницу, не тронув её формулы и вёрстку)

Раньше Smartfolio был SaaS и хранил документы только в Turso — SQLite в виде сервиса. Теперь, помимо локального SQLite и Turso, есть три новых хранилища: папка на диске (для локальной установки), GitHub-репозиторий и папка в Google Drive.

Появилась синхронизация, и она трёхсторонняя: что есть у A, что есть у B и о чём эти двое договорились в прошлый раз. Благодаря этому «они различаются» превращается в «изменилось вот это» — без обращения к часам, которые принадлежат чужой машине. Пары хранилищ по умолчанию двусторонние (односторонний режим существует для резервных копий, и интерфейс пишет «только из X в Y», а не рисует стрелку, которую можно прочесть наоборот), могут быть ограничены страницей и всем, до чего она дотягивается — включая ассеты, которые находятся по идентификаторам прямо в содержимом. Конфликты сохраняют обе стороны в виде конфликтной копии, а не сливают и не отбрасывают. Пары запоминаются в обоих хранилищах, поэтому настроенная на ноутбуке появляется и на следующей машине, а запись о достигнутом согласии живёт ровно в одном месте — если бы каждая машина вела свою, обычная правка с одной стороны превращалась бы в конфликт.

GitHub и Drive подключаются легко через oauth, дальше профиль показывает репозитории, в которые токен может писать, или папки в Drive, созданные этим приложением, — и указание существующей выбирает её, а не создаёт вторую рядом. Именно так вторая машина присоединяется к уже существующим заметкам.

Появились десктопные сборки на Electron — для macOS, Windows и Linux. Smartfolio также работает из мобильного браузера.

Демо (немного устаревшее, без синхронизации) —

Пока всё по приглашениям — и сервис, и исходный код.

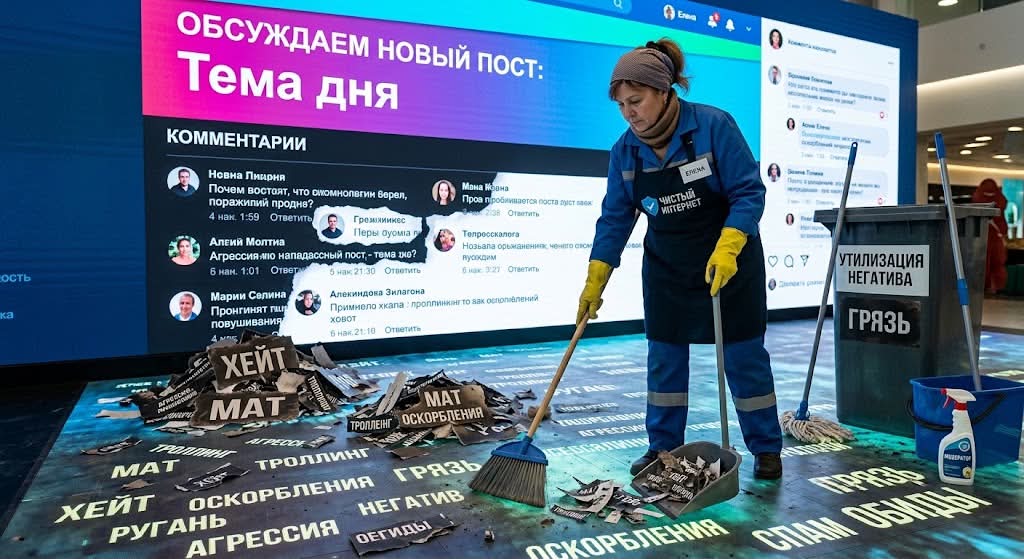
Индекс вежливости: ваш ключ к чистым соцсетям | 2026-09-15T23:34:33

Индекс вежливости: как очистить соцсети от хамства и заработать на этом

Соцсетям давно пора ввести «индекс вежливости» для каждого поста и комментария. Идея простая: алгоритм напрямую привязывает показы к тону сообщения. Агрессивные реплики не удаляются, а просто реже показываются в ленте.

Написал спокойный и дипломатичный комментарий — собираешь нормальную аудиторию. Пришел хамить и ругаться — твою реплику увидят от силы три человека.

Как это работает на практике. Технически всё уже возможно: нейросети легко оценивают тональность текста в фоновом режиме. Главное в этой системе — дать пользователю наглядную обратную связь.

Например: Комментатор переходит на личности. Соцсеть присылает ему уведомление: «Ваш текст мог бы стать в два раза заметнее, если бы вы не обматерили автора и не опустили ту женщину в белом пальто».

Люди получают четкий сигнал: внимание аудитории зависит от того, как сформулирована мысль, а не от громкости скандала. Поначалу эту функцию можно тестировать не на всех, а только на части постов.

Зачем это пользователям и бизнесу? Захотят ли сами площадки тратить деньги на модерацию тона, если их бизнес построен на просмотрах и бесконечных эмоциональных спорах? Вопрос сложный.

Но решением может стать премиум-функция «чистой ленты». Многие с радостью согласятся смотреть дополнительную рекламу или платить небольшую абонентскую плату за экологичное информационное пространство. Мы же платим клинерам за уборку дома — платить за чистоту в соцсетях ничем не хуже. В перспективе привычка общаться вежливо ради лайков может изменить людей и за пределами интернета. Или я с другой планеты упал?

Чёрный ящик механики и AI: путь к новаторству | 14 сентября 2026 года, 20:19

Придумал простую иллюстрацию того, где нынешний AI пока не тянет.

Есть чёрный ящик, из него торчат две ручки. Двигаешь первую — вторая тоже двигается, но по каким-то своим правилам, типа с задержкой, с инерцией, с порогом, как угодно. То есть, по сути, ящик преобразует f(t) в f'(t). Вопрос один: что внутри? Надо не только придумать эффективный механизм, но и уместить его в габариты ящика.

Формально это почти программирование. Потому что можно формально описать вход-выход и придумать «алфавит» для механических штук внутри. Но здесь в отличие от программирования много нелинейного — механизмы объёмные, надо принимать во внимание кучу вещей от материалов до трения, и главное не так просто испытать прототип до его создания. Но главное даже не это — а понимание задачи. Единственный способ узнать, что внутри ящика — это выдвинуть гипотезу и придумать движение ручки, при котором эта гипотеза и соседняя дадут разный результат. Хороший эксперимент здесь важнее хорошего ответа. А модели учили на корпусе готовых решений, где ошибки уже вычищены, и там ничто не тренирует умение выбирать следующий вопрос.

К чему это. Мне кажется, сложное для AI (мы говорим про LLM; так-то область шире)— не компоновка из известного, с этим он справляется всё лучше. То есть, задачу с ящиком при наличии «алфавита» для ее описания и законов механики AI может решить, но через комбинации известного, а не через принципиально новый компонент. Сложное — придумывание нового. Хотя, если быть честным, большинство человеческих изобретений при разборе тоже оказываются компоновкой, просто из далеко разнесённых кусков. Но придумывали же часовой спуск (анкер) , где все детали — колесо и качающаяся вилка, да и вообще сама мысль, что колебательная система должна не приводиться пружиной, а сама дозировать, когда пружине разрешено отдать порцию энергии, переворачивает причинность в устройстве, и до неё шли столетия. И челночный стежок швейной машины. Бессмысленно копировать руку с иголкой, нужно вместо этого протаскивать вторую нить сквозь петлю первой с изнанки, причём иголка должна иметь ушко у острия. Всё это не сборка из компонентов, а смена того, что вообще считается задачей, и именно поэтому такие вещи так плохо выводятся перебором комбинаций, будь то у человека или у модели.

У изобретателя есть обратная связь от реальности и цена ошибки, поэтому он учится проверять раньше, чем верить. У модели внутри одного ответа платить за неверную догадку нечем. Да и вообще, замени механику на физику частиц, и надо опять все переделывать, потому что там вообще все иначе.

Занятно, что это лечится не размером модели, а устройством задачи. Дай ящику отвечать на движения — и задача из текстовой становится экспериментальной. Посмотрим, кто первым научится так играть.
Изменение предпочтений: от удобства к переосмыслению | 20 августа 2026 года, 12:57

офигеть, и находил же я когда-то этот удобным (и лэптопу нравилось)