Опубликовал на Hybrismart новую статью из серии про OMS (Order Mgmt). По ходу сделал полный эмулятор OMS на котором можно проверять всякие «а что будет если» — (например, что поменяется, если мы уберем резервирование товара), и у уже много что накопилось (для следующих статей). В этой же статье про имплементацию wait-шагов в order workflow и особенностей (довольно специфично про SAP Commerce)
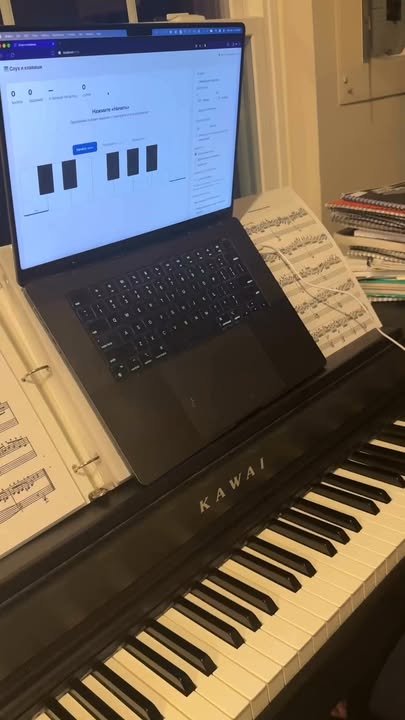
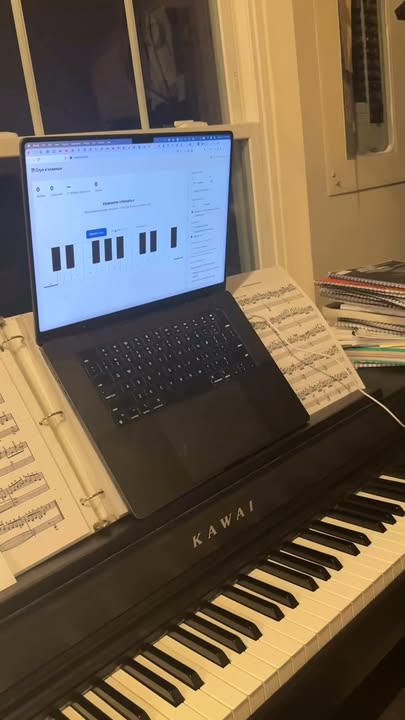
Доделал программу, теперь она учит адаптивно, постепенно вводя новые аккорды и снижая частоту встречаемости тех, с которыми я меньше ошибаюсь. Ноты тоже так умеет, но м нотами мне меньше интересно, так как я там почти не ошибаюсь. А с аккордами сложнее и интереснее.
Смотрите какую штуку навайбкодил за 10 минут — тренажёр слуха. Следующий шаг — повторение мелодии, потом повторение в указанной тональности (от другой ноты). В какое время живем! Многие идеи быстрее сделать, чем искать что-то готовое 😉
Опубликовал новую статью на Hybrismart — про недокументированные особенности FlexibleSearch (SAP Commerce Cloud / Hybris). Актуально, если вы как-то работаете с этой платформой. Если нет — можете прислать тем, кто работает 🙂
Я теперь публикую статьи на трех языках — RU, ENG, UKR. Понятно, что автоматический перевод на русский и украинский с английского. Но многим удобнее читать на родном.
Последнее время для пресейлов наловчился делать ресурсный план проекта через Claude Code. Очень круто получается. То есть, делаешь интерактивную модель с ползунками, которая показывает финальную стоимость проекта для указанной команды и указанной гибкости (каких-то ролей больше или меньше, какие-то этапы имеют больший резерв или меньший). Главное, что такая модель очень специфична для конкретного проекта и в целом бесполезна как шаблон для следующего, но сам принцип построения моделей один. В итоге подбираешь ползунками то, что одновременно выглядит believable и удовлетворяет уровню рисков, и видишь сумму, и дальше генеришь артефакты для клиента, которые после ручной доработки напильником (иногда большой) готовы для показа клиенту.
Обновил свой smartfolio.me (Если коротко, это персональное рабочее пространство для знаний, построенное вокруг страниц, которые содержат другие страницы, — причём дочерняя страница может раскрывать выделенный фрагмент в контексте родительской. Вы пишете в полноценном редакторе — текст, формулы, изображения, встроенные PDF с аннотациями, сохранённые веб-страницы — и вместо того чтобы раскладывать документы по папкам, вставляете одну страницу внутрь другой, или создаете дочернюю как explanation через LLM выделенного фрагмента в контексте родительского документа. Входящие принимают материал извне, поиск находит то, что осталось без связей, а несколько LLM-плагинов умеют разобрать сырую расшифровку на связанные разделы, собрать целое поддерево в один документ, перевести страницу, не тронув её формулы и вёрстку)
Раньше Smartfolio был SaaS и хранил документы только в Turso — SQLite в виде сервиса. Теперь, помимо локального SQLite и Turso, есть три новых хранилища: папка на диске (для локальной установки), GitHub-репозиторий и папка в Google Drive.
Появилась синхронизация, и она трёхсторонняя: что есть у A, что есть у B и о чём эти двое договорились в прошлый раз. Благодаря этому «они различаются» превращается в «изменилось вот это» — без обращения к часам, которые принадлежат чужой машине. Пары хранилищ по умолчанию двусторонние (односторонний режим существует для резервных копий, и интерфейс пишет «только из X в Y», а не рисует стрелку, которую можно прочесть наоборот), могут быть ограничены страницей и всем, до чего она дотягивается — включая ассеты, которые находятся по идентификаторам прямо в содержимом. Конфликты сохраняют обе стороны в виде конфликтной копии, а не сливают и не отбрасывают. Пары запоминаются в обоих хранилищах, поэтому настроенная на ноутбуке появляется и на следующей машине, а запись о достигнутом согласии живёт ровно в одном месте — если бы каждая машина вела свою, обычная правка с одной стороны превращалась бы в конфликт.
GitHub и Drive подключаются легко через oauth, дальше профиль показывает репозитории, в которые токен может писать, или папки в Drive, созданные этим приложением, — и указание существующей выбирает её, а не создаёт вторую рядом. Именно так вторая машина присоединяется к уже существующим заметкам.
Появились десктопные сборки на Electron — для macOS, Windows и Linux. Smartfolio также работает из мобильного браузера.
У меня когда-то в начале 2000-х был «бизнес» по торговле интернетом в розницу — на CD-дисках. Я договаривался с поставщиками контента — сайтами типа algolist, openbsd и кулинарными рецептами, чтобы они ставили на все страницы по баннеру «купи этот сайт на CD», а я за это инвестировал время в создание статической версии с поиском и запись на диски. Ссылка со страниц вела на <проект>.nadiske.ru, где была большая кнопка заказать и апселл с других проектов, по теме и не очень. Процент с каждого диска уходил владельцу контента. Доставка шла наложенным платежом через почту России (то есть, я отправлял диски без предварительной оплаты), и получал деньги на почте. На сайте фактически было две страницы — список товаров с чекбоксами и форма заказа. Но подсайтов было столько, сколько партнеров — на каждом из них главный товар стоял первым, а остальное шло как апселл. Расчёт был на то, что «раз уж заказываем давай что-то ещё».
Так вот, возникало тогда несколько интересных проблем. Как сопоставлять деньги с посты с заказами? У меня для каждого заказа динамически формировалась цена — добавлялись копейки, чтобы цена была уникальной. Для конечного покупателя разницы на какую цену соглашаться, 150 рублей или 150 рублей 12 копеек не было, а мне было удобно сопоставлять. Вместе с датой это было довольно надежно.
Вторая проблема была где вести заказы со статусами и прочим. В итоге, я выбрал Microsoft Access. Он тянул с сайта XML c новыми заказами. Всю систему на аксессуар я разработал за пару часов. Она была идеальна. Кстати, а Access умер уже?
Что интересно, так это то, что лидерами продаж были диски, которые я наштамповал просто чтобы расширить ассортимент — юниксы и линуксы. Понятно, что на них не шло ни одной ссылки с партнёрских сайтов, но их покупали в нагрузку, и в итоге они держали топ;) и были проще всего и дешевле в производстве.
А еще я разработал поисковый движок для CD чтобы искать по этому контенту. Я не помню как, но тогда в браузер, открывавший index.html с диска, можно было встроить запускаемый код. То ли ASP-вставки были и DLL, то ли что-то типа.
Проект я закрыл, когда стало понятно, что в регионы нормальный интернет всё-таки проведут и спрос на диски когда-нибудь стухнет. Ну и все к этому шло. Плюс диски требовали обновления, и на это нужно было инвестировать силы и время, их было жалко (особенно с учетом первого пункта)
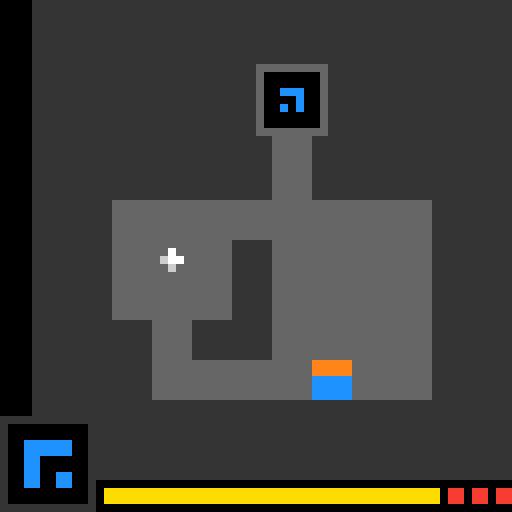
Сегодня наткнулся на тесты ARC-AGI-3 для моделей AI. То есть, если вам кажется, что AI может за вас сделать что угодно, то считайте, что вы заработали уже большую часть из $850,000 призового фонда — просто сабмитьте ваш прекрасный код, и пусть он будет лучшим. Но так не работает. Кожаные мешки справляются с 100% задач, а вот программы пока не преодолели планку в 2.5-3%. Что там за задачи такие?
Программе дается не текстовое задание, а мини-игра. Нет ни инструкций, ни описания правил. На каждом шаге программа получает «кадр» — JSON-объект с текущим состоянием поля. Это сетка размером до 64×64 клетки, где ячейки закодированы числами от 0 до 15 (обозначающими разные цвета или типы блоков). У агента есть стандартизированный интерфейс (действия 1–7), включающий базовые шаги и возможность указывать конкретные координаты (X, Y). Но ИИ заранее не знает, что делают эти действия! В одной задаче «Действие 1» может сдвигать блок вправо, в другой — перекрашивать его, в третьей — включать гравитацию. Чтобы понять логику, ИИ должен активно «тыкать палочкой» в среду. Он совершает экспериментальное действие, среда реагирует и возвращает новый кадр. Агент должен проанализировать изменения, обновить свою теорию о физике этого конкретного мира и сделать следующий осознанный шаг. Игра может завершиться статусом WIN, GAME_OVER или продолжаться дальше.
Еще раз — люди набирают 100%, машины — 2-3%. На сайте ARC PRIZE можете попробовать, там есть сэмпл-задачки.
Интересно, что кажется не существует инструментов, позволяющих проверить, как работает Social Sharing Previews для Facebook, LinkedIn, Twitter для сайта, который еще не в паблике. Я могу представить два решения для этого: симуляция поведения соцсети и создание страницы с вырезанным контентом, но корректными заголовками, которая на минуту открывается в паблик, дальше выполняется генерация превью через сами инструменты FB, LI, Twitter, делаются выводы что подправить, а страница исчезает. Симуляцию тоже вполне можно сделать, вроде несложно.
Задумываюсь о создании программки, которая будет сканировать диск и анализировать все папки и файлы, заглядывая внутрь файлов только если надо — в основном будет смотреть на их названия, и через LLM ставить метки и короткие описания на целые иерархии, и что важнее, делать классификацию, сохранять объем файлов в иерархии. Предполагается, что такая штука запускается вечером и результат обнаруживается утром, потому что очевидно все это медленно. Зато утром я получаю подробный, структурированный, относительно небольшой сводный отчет, что нужно бэкапть, что вероятно можно удалить (например, клон какого-то репозитория из публичных), с сортировкой по влиянию (место освободить, помойка меньше и т.д.).
Конечно, бросать в LLM десятки тысяч файлов — неразумная трата токенов. Предполагается агентская схема — система берет верхний уровень, делает предположения, проверяет предположения, смотрит время изменения файлов, проверяет, вносились ли туда изменения с момента создания всей иерархии и спрашивает у LLM очень компактно, выставляя процент уверенности в суждении о нужности/ненужности той или иной папки. Дальше уже пользователь может что-то проверить руками, а на что-то попросить посмотреть детальнее.
Интересно, была бы такая штука полезной кому-то еще?