Надин волейбольный клуб даёт тренерам возможность сеять что-то разумное, доброе, вечное, в том числе и в формате видеовизитки!
Метка: Education
Локальные транскрипты со скриншотами | 26 октября 2026 года, 03:48
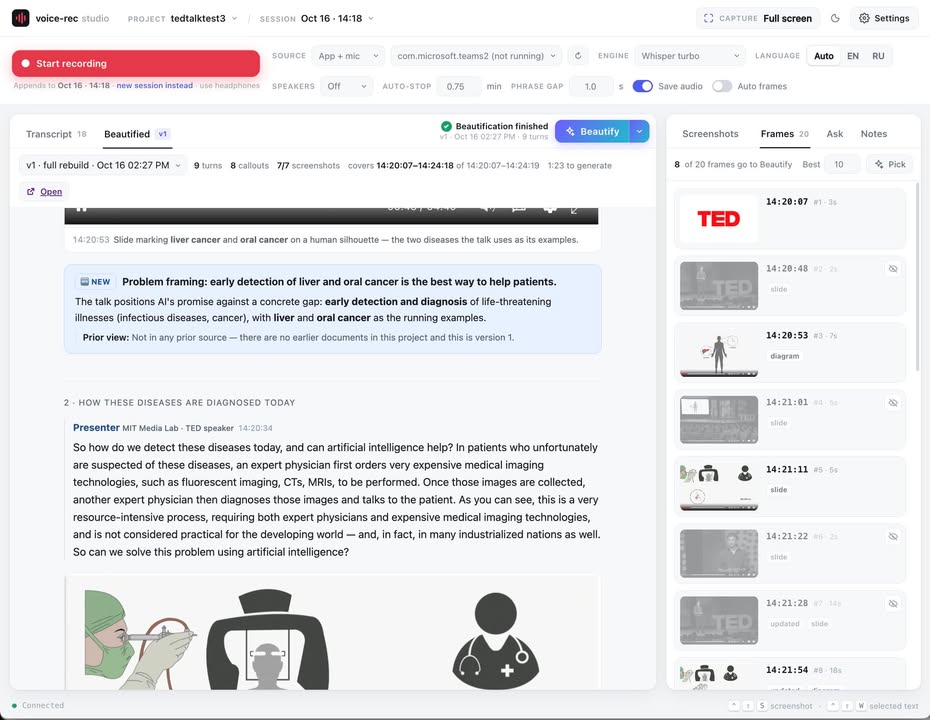
Выложил в open source программу для создания транскриптов встреч (например в Teams), звонков, лекций с автоматическим скриншотированием. И статью о ней (RUS/UKR/EN). Ссылка в комментариях.
Началось всё не с встреч. Хотел инструмент, который слушает, как я вслух комментирую тестирование приложения, и потом вместе со скриншотами превращает это в документ или почти готовые баг-репорты. Но в итоге мои 9 из 10 запусков — это транскрипты звонков и помощник прямо во время разговора. Ну и лекции с YouTube в читаемые статьи со слайдами превращает отлично.
Распознавание полностью локальное. Аудио звонков и скриншоты экрана никуда не уходят. Три движка на выбор — faster-whisper, GigaAM (для русского, в 20 раз быстрее Whisper и без галлюцинаций вроде «Продолжение следует…») и Parakeet для смеси русского с английским.
Что умеет:
— Текст появляется практически в реальном времени, с таймкодами, в процессе дописывается обычный .txt на диске.
— По Ctrl-Shift-S делается скриншот и из него текст через OCR суется прямо в нужное место транскрипта. Есть автоматический режим — скриншотирование каждую секунду, а дальше каскад фильтров оставляет только новые слайды. На тестовом 11-минутном докладе 692 кадра → 10 сцен, ни одного слайда не потеряно.
— Звук звонка можно брать с микрофона, а можно напрямую из приложения (например, Teams или Chrome/Youtube)
— Диаризация по голосу и контексту. Если человек с голосом А назвал человека с голосом Б Васей, то все реплики Б в результирующем транскрипте будут подписаны Васей. Транскрипт самого Teams можно подгрузить вторым источником, тогда оттуда может браться уточненная информация кто говорил что.
— Кнопка Beautify собирает из сырого транскрипта документ: решения, задачи, чистый диалог. Пока запись идёт, можно спрашивать чат — что мы ещё забыли обсудить, например.
Приложение точно работает на MacOS (DMG в релизах, macOS 14+, модели качаются при первом запуске). На остальных платформах многое не заработает, только база.
Двойная радость | 22 октября 2026 года, 12:35
Почти в один день пришло два письма: меня приняли на PhD в университет Siegen (Германия) и маме одобрили петицию на переезд в США. По обеим темам настоящие события для поздравлений меня (и мамы) ещё впереди, но оба этих события ждал много месяцев (22 и 10 соответственно). Хороший день сегодня)
Искусство свиста: от Сильбо Гомеро до ручного оркестра | 18 октября 2026 года, 16:03
Узнал, что есть язык, построенный целиком на свисте. Гуглите Silbo Gobero. Это свистящий язык на Канарских островах, свистящий диалект испанского. И там довольно много жителей могут общаться на нём. Носителя сильбо гомеро называют сильбадором (свистуном). В 2009 язык занесён в Список шедевров устного и нематериального культурного наследия человечества. На Youtube много роликов на тему.
Задумался, что человечество стремительно теряет скилл свистеть. Губами в трубочку еще кто и умеет, но всеми остальными способами кажется, никто.
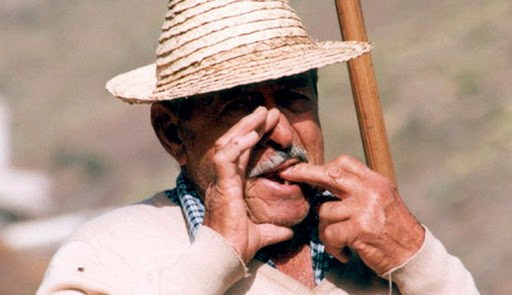
Кроме него есть нёбный свист (ищите palatal whistle, roof of mouth whistle) — резче и пронзительнее губного, лучше пробивает шум, но высота почти не меняется. Есть еще свист через свёрнутый язык (ищите rolled tongue whistle, taco tongue whistle) — низкий, глухой, похож на сову, но пишут, что получается не у всех (может, генетика). С пальцами во рту — погромче (мойте руки!). Два пальца одной руки (указательный + средний или большой + указательный «колечком») — 100-115 дБ, до 1 км в тишине. Как раз это основа Сильбо Гомеро — высоту меняют губами и глубиной погружения пальцев, так что кодировать можно многое. Один палец (указательный или мизинец крючком) — почти та же громкость, вторая рука свободна. Пальцы обеих рук (по одному или по два с каждой стороны) — самый громкий ручной свист, до 120 дБ, в горах через ущелье 2-3 км. Большие пальцы обеих рук (ногтями к языку) — громкий, низковатый, традиция пастухов Пиренеев, Кавказа, Балкан.
Есть еще свист в сложенные ладони — низкий, 300-600 Гц, слышно на 100-300 м, но низкий звук огибает деревья и кусты, поэтому в лесу он несёт дальше высокого. Высоту меняют, приоткрывая пальцы, — можно свистеть 5-8 нот.
BloomSpan: Новый алгоритм поиска повторяющихся фраз в больших текстах | 12 октября 2026 года, 04:10
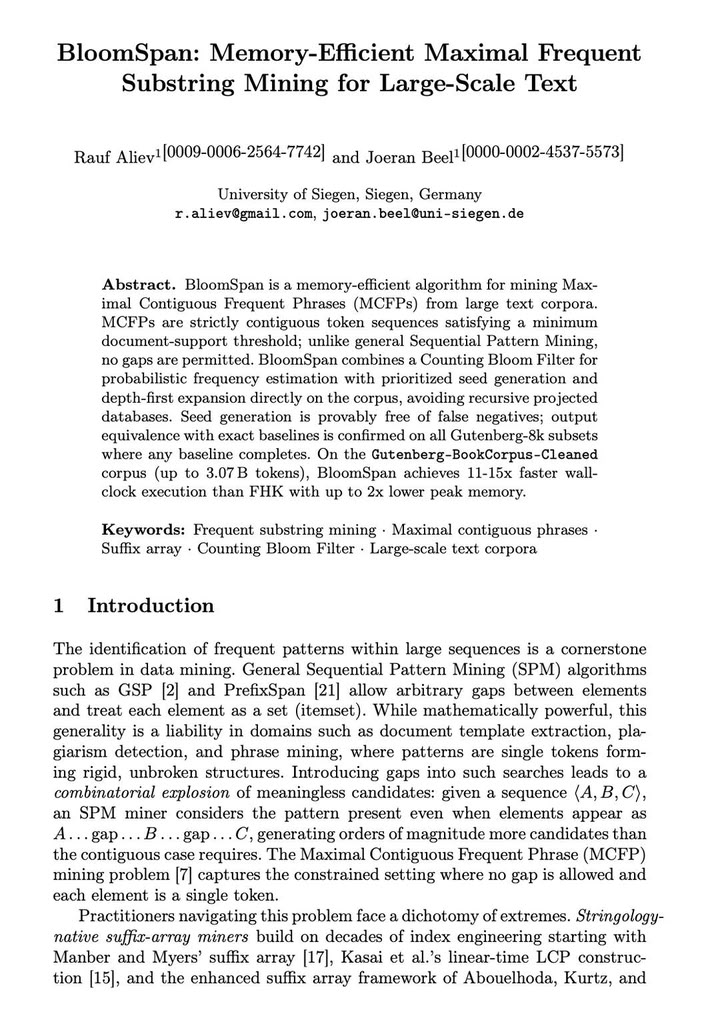
Хочу поделиться нашей свежей работой — алгоритм BloomSpan по поиску наиболее длинных частых последовательностей слов в массиве текстов. Я его назвал BloomSpan.
О чём это, если по-человечески. Представьте, что у вас есть библиотека из 50000 книг, и нужно найти все длинные фразы, которые повторяются во многих разных книгах слово в слово, без пропусков. Не «похожие» фразы, а именно одинаковые цепочки слов, причём максимально длинные — такие, что если добавить ещё одно слово слева или справа, фраза уже перестаёт встречаться достаточно часто. Задача звучит просто, но на миллиардах слов она упирается в память и время. Классические алгоритмы либо строят огромные индексы, либо перебирают слишком много кандидатов.
Где это нужно? Например, вытаскивать шаблоны из документов (например, одинаковые «шапки» в письмах или договорах), искать заимствования и плагиат, выделять устойчивые фразы и клише в больших текстовых массивах.
Так вот, что получилось. Алгоритм. Честно говоря, BloomSpan — это не прям алгоритм с нуля, а аккуратная сборка из известных идей, которые вместе дают сильный эффект. В базе — разные идеи от BIDE+, FHK, и поверх всего этого: (а) Фильтр Блума — компактная структура, которая отвечает на вопрос «встречалось ли это сочетание слов достаточно часто?», не храня сами сочетания. Она может иногда ошибиться в сторону «да», но никогда — в сторону «нет», поэтому мы гарантированно не теряем ни одной нужной фразы (б) Поиск «в глубину» прямо по тексту — находим короткое частое ядро и постепенно наращиваем его в длинную фразу, не создавая промежуточных копий корпуса. (в) Карта занятости — отмечаем в тексте позиции, уже «покрытые» найденными фразами, чтобы не проверять одно и то же по многу раз.
Что получилось. На корпусе из 50 тысяч книг Project Gutenberg (около 3 миллиардов слов) BloomSpan работает в 11-15 раз быстрее классического алгоритма FHK и съедает до двух раз меньше памяти. Это единственный из протестированных методов, который вообще дошёл до конца на полном корпусе в пределах 40 ГБ. При этом результат полностью совпадает с точными алгоритмами там, где они успевают отработать — то есть ускорение не за счёт качества.
На искусственных же данных с «неестественным» распределением слов старый добрый FHK быстрее. Bloomspan заточен именно под живой естественный язык, и в статье разбирается, почему так.
Препринт и код (Java) — в комментариях
Smartfolio: Эволюция цифрового рабочего пространства | 26 сентября 2026 года, 12:51
Обновил свой smartfolio.me (Если коротко, это персональное рабочее пространство для знаний, построенное вокруг страниц, которые содержат другие страницы, — причём дочерняя страница может раскрывать выделенный фрагмент в контексте родительской. Вы пишете в полноценном редакторе — текст, формулы, изображения, встроенные PDF с аннотациями, сохранённые веб-страницы — и вместо того чтобы раскладывать документы по папкам, вставляете одну страницу внутрь другой, или создаете дочернюю как explanation через LLM выделенного фрагмента в контексте родительского документа. Входящие принимают материал извне, поиск находит то, что осталось без связей, а несколько LLM-плагинов умеют разобрать сырую расшифровку на связанные разделы, собрать целое поддерево в один документ, перевести страницу, не тронув её формулы и вёрстку)
Раньше Smartfolio был SaaS и хранил документы только в Turso — SQLite в виде сервиса. Теперь, помимо локального SQLite и Turso, есть три новых хранилища: папка на диске (для локальной установки), GitHub-репозиторий и папка в Google Drive.
Появилась синхронизация, и она трёхсторонняя: что есть у A, что есть у B и о чём эти двое договорились в прошлый раз. Благодаря этому «они различаются» превращается в «изменилось вот это» — без обращения к часам, которые принадлежат чужой машине. Пары хранилищ по умолчанию двусторонние (односторонний режим существует для резервных копий, и интерфейс пишет «только из X в Y», а не рисует стрелку, которую можно прочесть наоборот), могут быть ограничены страницей и всем, до чего она дотягивается — включая ассеты, которые находятся по идентификаторам прямо в содержимом. Конфликты сохраняют обе стороны в виде конфликтной копии, а не сливают и не отбрасывают. Пары запоминаются в обоих хранилищах, поэтому настроенная на ноутбуке появляется и на следующей машине, а запись о достигнутом согласии живёт ровно в одном месте — если бы каждая машина вела свою, обычная правка с одной стороны превращалась бы в конфликт.
GitHub и Drive подключаются легко через oauth, дальше профиль показывает репозитории, в которые токен может писать, или папки в Drive, созданные этим приложением, — и указание существующей выбирает её, а не создаёт вторую рядом. Именно так вторая машина присоединяется к уже существующим заметкам.
Появились десктопные сборки на Electron — для macOS, Windows и Linux. Smartfolio также работает из мобильного браузера.
Демо (немного устаревшее, без синхронизации) —

Пока всё по приглашениям — и сервис, и исходный код.
Марк Солонин: Титулы в науке как красный флаг | 2026-09-19T04:18:26
Марк Солонин делился в своем последнем видео некоторой информацией и размышлизмами, которые заставили задуматься. Первая его мысль в том, что, мол, настоящий специалист подписывается просто своим именем; неспециалисты обязательно сопровождают фамилию титулами вроде «академик Российской академии естественных наук», «член-корреспондент Международной академии информатизации», «старший научный сотрудник Международного института изучения глобальных угроз всеобщей безопасности» и что такая длинная подпись — «красный флаг».
Для подтверждения тезиса он приводит интересные цифры и факты. Закон «О науке» 1996 года разрешил научным работникам создавать «общественные академии наук» — то есть по сути любое объединение граждан может назваться академией и раздавать звания. Ещё в 2013 году Коммерсант насчитал в стране более 80 академий наук, из них государственных — шесть. Остальные семьдесят с лишним — общественные организации, у которых членство продаётся или раздаётся по собственным правилам.
Среди них абсолютный рекордсмен — бывшая справочная контора. «Международная академия информатизации» выросла из Мосгорсправки. В её учредители вошло руководство Мосгорсправки, а первым президентом стал её директор. В 1990 году «Академия информатизации СССР» была зарегистрирована как малое предприятие. Сегодня она сама гордо сообщает на сайте: более 19 000 действительных членов. Девятнадцать тысяч академиков из одной конторы. Председатель комиссии РАН по борьбе с лженаукой Эдуард Кругляков писал, что МАИ штампует специалистов по 101 специальности, включая астрологию, уфологию, телепатию и телекинез. Бонус — с 1995 года у МАИ консультативный статус при ЭКОСОС ООН (не ржите, это экономический и социальный совет при ООН), так что теперь бывают и «академики при ООН».
Самая опасная — та, что звучит солиднее всех. Российская академия естественных наук (РАЕН) — к 2003 году около 4000 членов. Название почти неотличимо от РАН, а в ней действительно состоят настоящие академики — потому подпись «член-корреспондент РАЕН» так хорошо работает на неподготовленного читателя (например, ««Победим буквально всех»: гениальный ученый-пророк предсказал триумф России» — это заголовок про Квашу, ч.-а. этого РАЕН). Президент РАН Юрий Осипов на заседании Президиума РАН прямо спрашивал — кто проповедует торсионные поля? — и сам отвечал: РАЕН. В 2006 году почётным членом РАЕН стал 29-летний Рамзан Кадыров. Президент РАЕН впоследствии подтвердил, что звание присвоено за спасение жизней военнослужащих в Чечне.
Была еще Академия проблем безопасности, обороны и правопорядка (2000–2008). По данным Генпрокуратуры, она вместе со своим «Национальным комитетом общественных наград» учредила 73 вида наград, идентичных государственным, ввела учёные степени, собственную военную форму и воинские звания. Выдавала удостоверения профессора, члена-корреспондента и академика, внешне похожие на государственные. Годовой бюджет — около миллиона долларов. Это единственная «академия», которую в итоге закрыли (10 декабря 2008 года; Верховный суд ликвидировал её по иску Генпрокурора — не за торговлю званиями, а за имитацию государственных наград). Экс-президента оштрафовали на 500 рублей.
В 2013 году в РАН было 500 академиков. После реформы и присоединения медицинской и сельхозакадемии их стало 941 к 2025 году — рост на 71%. Это не оценка «врагов науки»: так пишет главный научный сотрудник Института проблем развития науки РАН в журнале «Экономика науки», отдельно отмечая избрание в академики чиновников, политиков и бизнесменов и случаи непотизма.
Чтобы защитить диссертацию, нужны публикации в «ваковских» журналах. Таких журналов в перечне на сегодня — больше трёх тысяч. Прикиньте, в России есть несколько тысяч научных журналов, которые никто не читает 🙂
В общем, мысль довольно оригинальная — когда вы видите подпись «академик такой-то академии, член-корреспондент такой-то, старший научный сотрудник международного института чего-то», — это не удостоверение, а красный флаг. У настоящего специалиста есть имя. И ему этого достаточно.
Тайны завещания Изабеллы Стюарт Гарднер | 2026-09-18T22:26:33
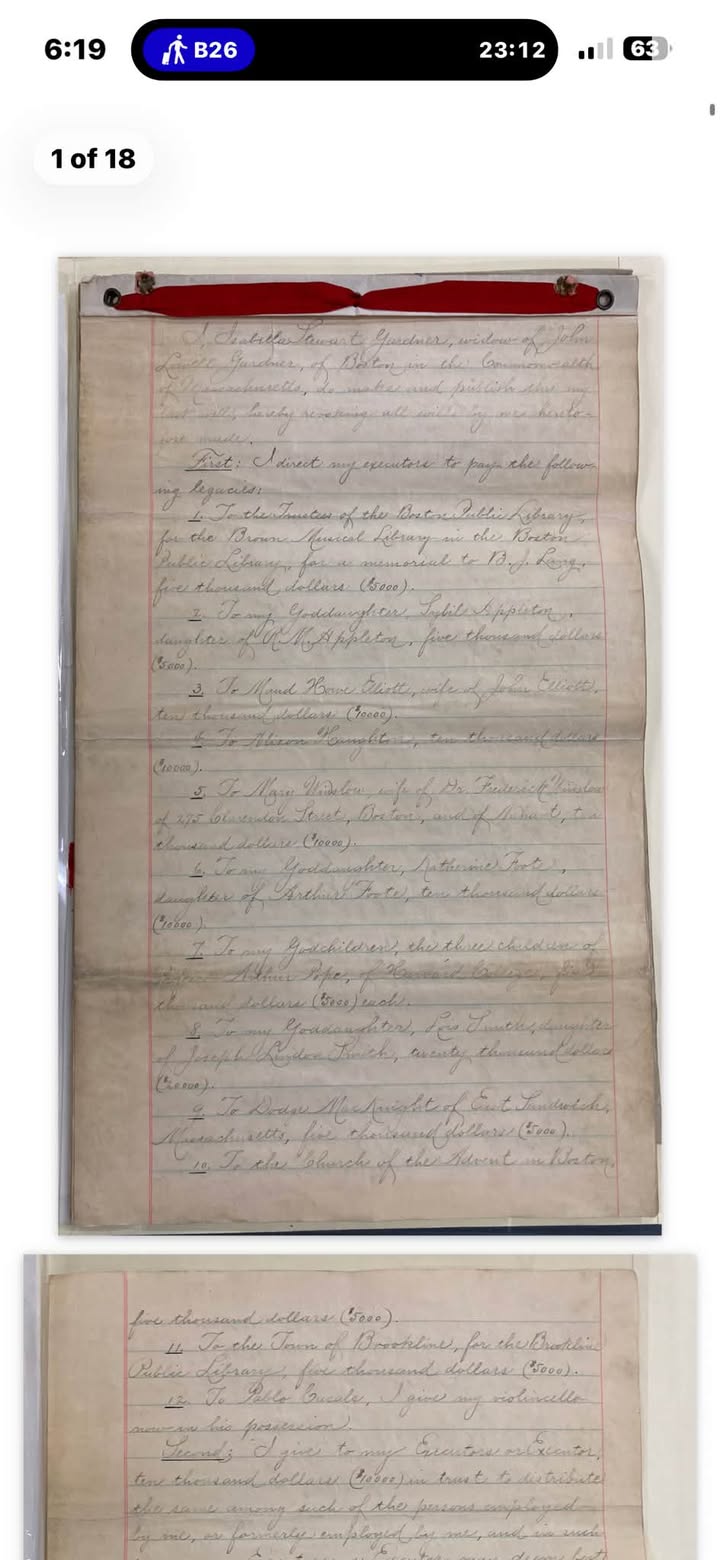
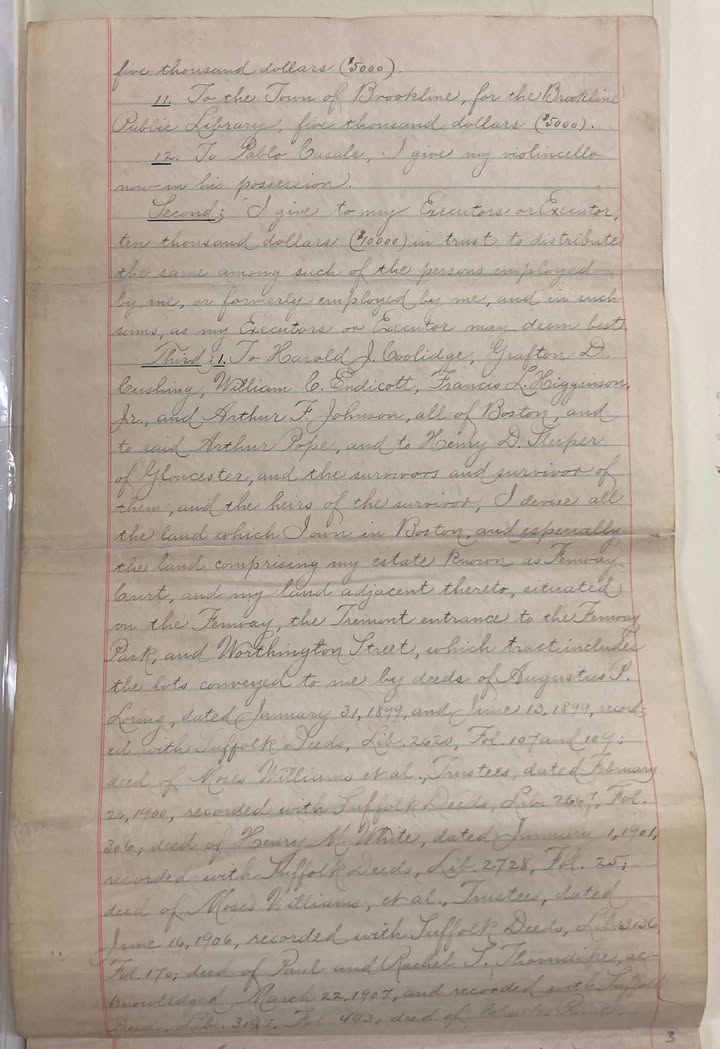
Ранее сегодня я написал пост про музей Изабеллы Стюарт Гарднер и, как все, сослался на её завещание: мол, если трасти изменят планировку, музей со всей коллекцией уходит Гарварду. Эту фразу цитируют в каждой статье, каждом путеводителе и каждом подкасте про ограбление 1990 года. И тут мне стало интересно: а что там ещё, в самом документе? Пошёл искать — и с удивлением обнаружил, что завещания в паблике нет. Все на него ссылаются, но оно не гуглится: ни на сайте музея, ни в архивах, ни в юридических базах. Единственное, что нашлось, — обрывочное нечто на Scribd, где как раз нужных страниц и не хватало.
Тогда я просто написал письмо в архив музея. Отправил в 3:54 pm. В 3:58 pm пришёл ответ — с фотографиями оригинала: семнадцать рукописных страниц на линованной бумаге с красными полями, красная лента, сургучная печать и подпись «Isabella Stewart Gardner» от 9 мая 1921 года, плюс машинописный кодицил 1924-го.
Самое любопытное — знаменитый пункт про Гарвард на самом деле куда конкретнее, чем его пересказывают. Условие срабатывает, если трасти выставят что-то, чем она не владела на момент смерти, или изменят «общее расположение» предметов на первом, втором и третьем этажах — «кроме кухни и прилегающих спален на первом этаже». Тогда всё — землю, здание, картины, статуи, безделушки, мебель, книги и фонд в 1,2 миллиона долларов — Гарвард обязан продать, причём не в Бостоне, а в Париже, а доход тратить на прибавки профессорам или на стипендии не меньше 1 200 долларов в год каждая. Четвёртый этаж и мансарда в запрет не входят — там жил директор, которому она отписала квартиру бесплатно, пять тысяч в год, месяц отпуска и до двух слуг за счёт музея.
В завещании нет бесплатного входа для всех, кого зовут Изабелла — некоторые источники в сети ссылаются на завещание, но нет, это придумка маркетологов. Более того, там написано ровно противоположное: сам директор чуть ли не лично должен брать с посетителей деньги, «поскольку наибольшее благо для публики будет достигнуто именно взиманием такой платы», а открывать музей — только по определённым дням. Так что двадцать пять долларов за билет — это буквально её воля. Ещё она запретила «экстравагантные расходы» на содержание, а излишек велела каждые пять лет отдавать двум бостонским больницам, одной — на бесплатную койку.
Каждый год 14 апреля, в день её рождения, трасти обязаны проводить поминальную службу в капелле в конце Длинной галереи — музей делает это до сих пор. Остаток состояния разделила между детской больницей, обществами защиты детей и животных, причём общество защиты животных получает деньги при условии тратить $75 в год на свободное стойло в память лошадей Долли, Плуто и Леди Бетти и 35 долларов на конуру в память собак Китти Уинк и Патти Бой.
Чёрный ящик механики и AI: путь к новаторству | 14 сентября 2026 года, 20:19
Придумал простую иллюстрацию того, где нынешний AI пока не тянет.
Есть чёрный ящик, из него торчат две ручки. Двигаешь первую — вторая тоже двигается, но по каким-то своим правилам, типа с задержкой, с инерцией, с порогом, как угодно. То есть, по сути, ящик преобразует f(t) в f'(t). Вопрос один: что внутри? Надо не только придумать эффективный механизм, но и уместить его в габариты ящика.
Формально это почти программирование. Потому что можно формально описать вход-выход и придумать «алфавит» для механических штук внутри. Но здесь в отличие от программирования много нелинейного — механизмы объёмные, надо принимать во внимание кучу вещей от материалов до трения, и главное не так просто испытать прототип до его создания. Но главное даже не это — а понимание задачи. Единственный способ узнать, что внутри ящика — это выдвинуть гипотезу и придумать движение ручки, при котором эта гипотеза и соседняя дадут разный результат. Хороший эксперимент здесь важнее хорошего ответа. А модели учили на корпусе готовых решений, где ошибки уже вычищены, и там ничто не тренирует умение выбирать следующий вопрос.
К чему это. Мне кажется, сложное для AI (мы говорим про LLM; так-то область шире)— не компоновка из известного, с этим он справляется всё лучше. То есть, задачу с ящиком при наличии «алфавита» для ее описания и законов механики AI может решить, но через комбинации известного, а не через принципиально новый компонент. Сложное — придумывание нового. Хотя, если быть честным, большинство человеческих изобретений при разборе тоже оказываются компоновкой, просто из далеко разнесённых кусков. Но придумывали же часовой спуск (анкер) , где все детали — колесо и качающаяся вилка, да и вообще сама мысль, что колебательная система должна не приводиться пружиной, а сама дозировать, когда пружине разрешено отдать порцию энергии, переворачивает причинность в устройстве, и до неё шли столетия. И челночный стежок швейной машины. Бессмысленно копировать руку с иголкой, нужно вместо этого протаскивать вторую нить сквозь петлю первой с изнанки, причём иголка должна иметь ушко у острия. Всё это не сборка из компонентов, а смена того, что вообще считается задачей, и именно поэтому такие вещи так плохо выводятся перебором комбинаций, будь то у человека или у модели.
У изобретателя есть обратная связь от реальности и цена ошибки, поэтому он учится проверять раньше, чем верить. У модели внутри одного ответа платить за неверную догадку нечем. Да и вообще, замени механику на физику частиц, и надо опять все переделывать, потому что там вообще все иначе.
Занятно, что это лечится не размером модели, а устройством задачи. Дай ящику отвечать на движения — и задача из текстовой становится экспериментальной. Посмотрим, кто первым научится так играть.
Ключевые деятели в области поиска и рекомендательных систем: полный гайд | 10 августа 2026 года, 03:56
84 исследователя, 40+ лабораторий — кто есть кто в Search & RecSys, на одной странице.

Google, Meta, Netflix, Spotify, Amazon, CMU, UMass, UCSD и другие — для каждого человека ссылки на сайт, Google Scholar, LinkedIn, ключевые статьи. Плюс h-index и число цитирований из Semantic Scholar.
Сделал для себя, потому что так удобнее быстро смотреть кто что публикует. Готового ничего не нашёл — пришлось собрать самому. Вроде получилось полезно, надеюсь, не только мне.

