BloomSpan: Новый алгоритм поиска повторяющихся фраз в больших текстах | 12 октября 2026 года, 04:10

Хочу поделиться нашей свежей работой — алгоритм BloomSpan по поиску наиболее длинных частых последовательностей слов в массиве текстов. Я его назвал BloomSpan.

О чём это, если по-человечески. Представьте, что у вас есть библиотека из 50000 книг, и нужно найти все длинные фразы, которые повторяются во многих разных книгах слово в слово, без пропусков. Не «похожие» фразы, а именно одинаковые цепочки слов, причём максимально длинные — такие, что если добавить ещё одно слово слева или справа, фраза уже перестаёт встречаться достаточно часто. Задача звучит просто, но на миллиардах слов она упирается в память и время. Классические алгоритмы либо строят огромные индексы, либо перебирают слишком много кандидатов.

Где это нужно? Например, вытаскивать шаблоны из документов (например, одинаковые «шапки» в письмах или договорах), искать заимствования и плагиат, выделять устойчивые фразы и клише в больших текстовых массивах.

Так вот, что получилось. Алгоритм. Честно говоря, BloomSpan — это не прям алгоритм с нуля, а аккуратная сборка из известных идей, которые вместе дают сильный эффект. В базе — разные идеи от BIDE+, FHK, и поверх всего этого: (а) Фильтр Блума — компактная структура, которая отвечает на вопрос «встречалось ли это сочетание слов достаточно часто?», не храня сами сочетания. Она может иногда ошибиться в сторону «да», но никогда — в сторону «нет», поэтому мы гарантированно не теряем ни одной нужной фразы (б) Поиск «в глубину» прямо по тексту — находим короткое частое ядро и постепенно наращиваем его в длинную фразу, не создавая промежуточных копий корпуса. (в) Карта занятости — отмечаем в тексте позиции, уже «покрытые» найденными фразами, чтобы не проверять одно и то же по многу раз.

Что получилось. На корпусе из 50 тысяч книг Project Gutenberg (около 3 миллиардов слов) BloomSpan работает в 11-15 раз быстрее классического алгоритма FHK и съедает до двух раз меньше памяти. Это единственный из протестированных методов, который вообще дошёл до конца на полном корпусе в пределах 40 ГБ. При этом результат полностью совпадает с точными алгоритмами там, где они успевают отработать — то есть ускорение не за счёт качества.

На искусственных же данных с «неестественным» распределением слов старый добрый FHK быстрее. Bloomspan заточен именно под живой естественный язык, и в статье разбирается, почему так.

Препринт и код (Java) — в комментариях
Перевод Excel-организма в код: стратегия и исполнение | 2025-12-17T18:56:17

Все мы с этим сталкивались — «Главная Excel-Таблица, Управляющая Бизнесом». Та самая, которую B2B-компании используют, чтобы считать котировки на миллионы долларов. В ней 12 вкладок, 1000+ вложенных формул и ноль документации. Десять лет туда лепили «быстрые фиксы» и прятали константы. Это уже не файл, а живой организм, который уже никто до конца не понимает кроме того чела, уволившегося годы назад. Вот такой я был озадачен. Более того, там еще была неопределенность нужна ли вообще половина формул, или это рудименты прошлого.

Типичная ячейка:

=IF($D11=$D10,»», IF(ISNUMBER( INDEX(Data!$T$10:$U$17,

MATCH(TabCalc!$F11,Data!$T$10:$T$17,0),2)),

INDEX(Data!$T$10:$U$17, MATCH(TabCalc!$F11,Data!$T$10:$T$17,0),2),

INDEX(TabProd!$C$8:$U$112,TabCalc!$D11,I$1)))

Мне поручили перенести эту логику в код, чтобы все считалось софтом. Excel-файл как бы все имел что надо, но по факту — это был сложнораспутываемый черный ящик. 1069 формул.

Челлендж был в том, как перевести тысячу взаимозависимых формул в чистый код и не потерять ни одного пограничного случая (edge case).

В итоге вот что я сделал.

Вместо того чтобы переписывать всё с нуля одним махом с неопределенными перспективыми наплодить багов, я использовал стратегию ленивых вычислений и моков.

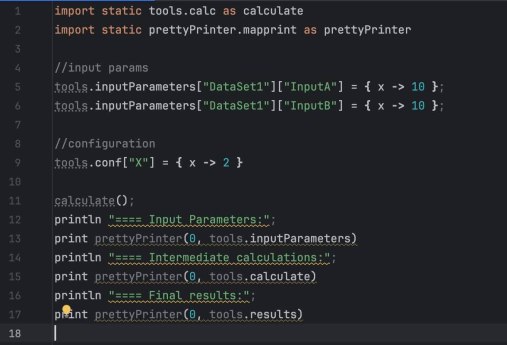
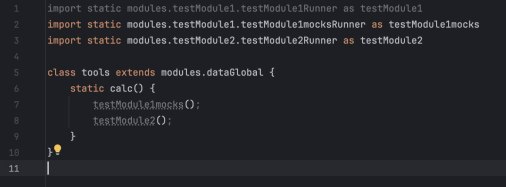
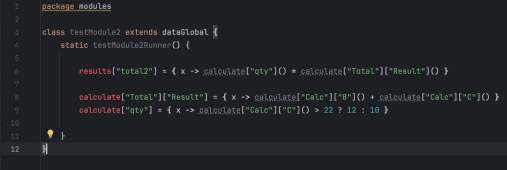
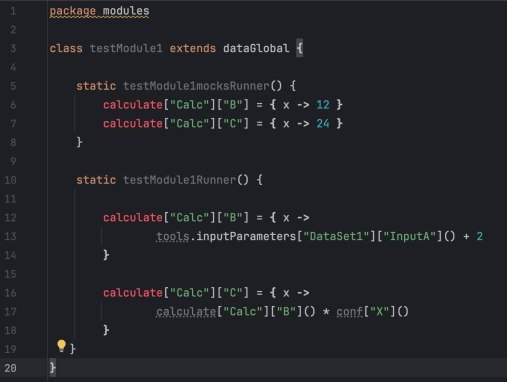
Я построил структуру на Groovy, которая имитировала поведение Экселя. Каждое вычисление (из ячейки) я определил как функцию, которая выполняется только тогда, когда её вызывают. А функциями был многомерный dictionary.

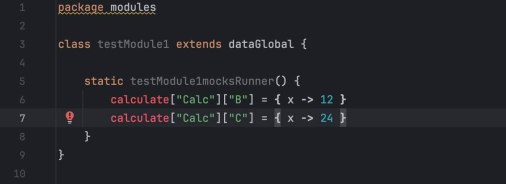
Я пошел с конца графа вычислений: от результатов к входным данным. Если формула зависела от чего-то, что я еще не написал, я «мокал» это в коде, просто подставляя значение из Excel-листа.

Кусок за куском я заменял эти моки на реальную логику. Сравнивая выхлоп моего кода с экселькой на каждом шаге, я точно видел, где моя логика расходится.

Другими словами, движение шло от результата к исходным данным. На каждом шаге было ясно, какие моки надо превратить в код, и можно было сравнить версию +1 с версией -1 — результат должен был совпадать. Как только все моки заменились на вызовы — задача была готова.

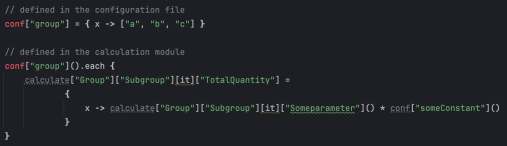
Настоящим «секретным ингредиентом» стала динамическая природа Groovy для создания многомерной карты функций. Вместо статических переменных я использовал глубоко вложенную структуру, где каждый «лист» был замыканием (closure). Это позволило обращаться к любой части таблицы — будь то входной параметр, константа конфига или сложный промежуточный результат — через простой, унифицированный синтаксис, причем некоторые компоненты были динамическими.

Вот пример:

conf[«group»] = { x -> [«a», «b», «c»] }

conf[«group»]().each {

calculate[«Group»][«Subgroup»][it][«TotalQuantity»] =

{

x -> calculate[«Group»][«Subgroup»][it][«Someparameter»]() * conf[«someConstant»]()

}

}

Используя динамические ключи и замыкания, я мог итерироваться по группам продуктов или наборам данных. Поскольку это были динамические функции, а не сохраненные значения, вся система работала как живой граф зависимостей.

Тестировать можно было прямо сразу после начала переноса формул. Прелесть была в том, что ты вроде как как бы к ячейке обращаешься через синтаксис типа calculate[«Totals»][«A»](), а на самом деле запускаешь целое дерево вычислений в этот момент. И это дико удобно в отладке.

Через две недели «Черный ящик» превратился в прозрачную, модульную библиотеку с понятной логикой, которая выдавала ровно тот же результат, что и оригинальная таблица.

P.S. Ну и конечно, все данные на всех скриншотах тщательно обфусцированы, а точнее сказать, написаны с нуля для этого текста.

Искусственный интеллект Starchat.ru: как бот стал частью сообщества | 2025-12-09T23:41:34

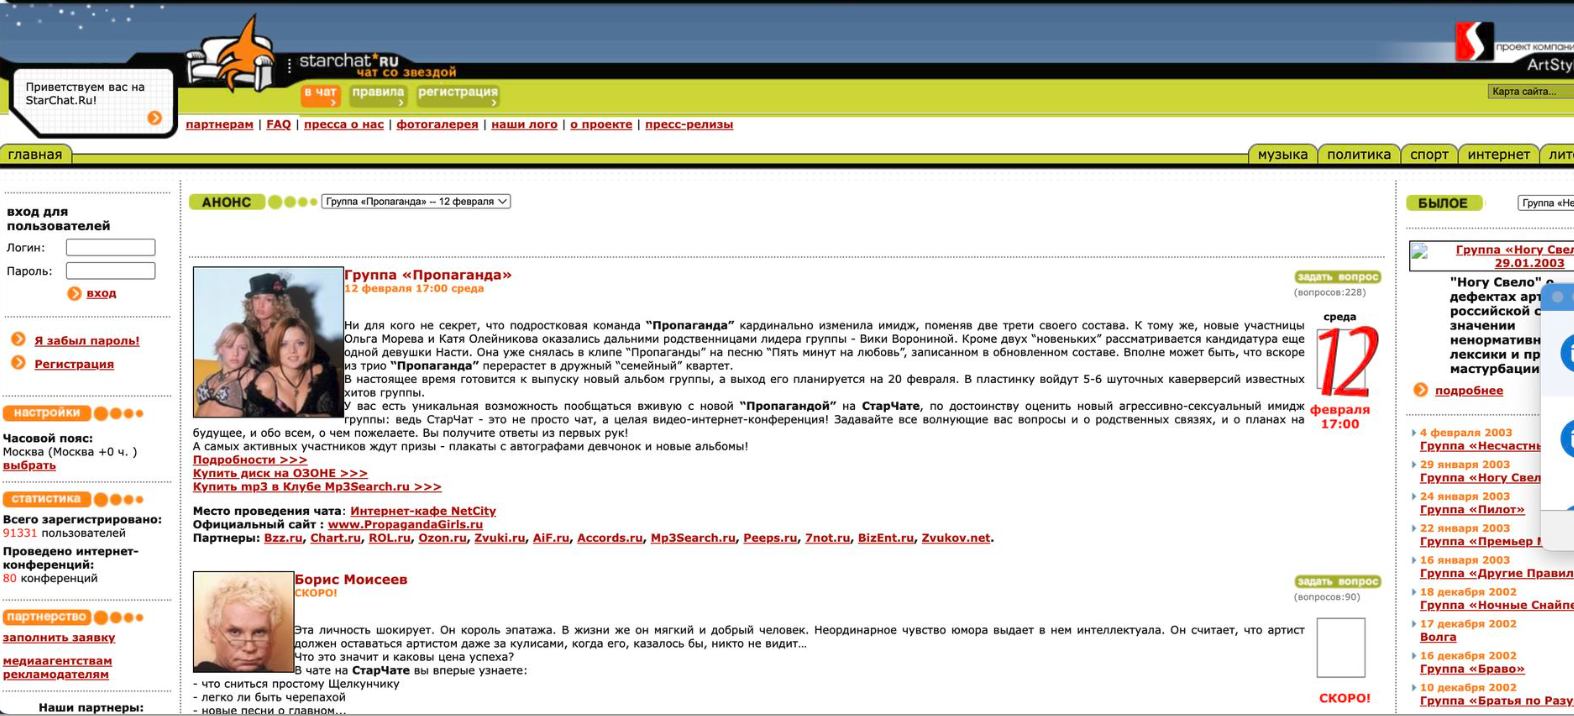
2003 год. У нас был чат, мое детище, Starchat.ru, где постоянно тусил народ и друг с другом общался. Там был джава-апплет! Никто сейчас и не помнит что это такое, наверное. Изначально писал эту штуку какой-то программист, которого я нашёл на просторах интернета, который потом пропал, и поддерживал уже я.

Ради гыгы сделал бота, с которым можно было пообщаться, просто кинув ему личное сообщение. Он постоянно висел в онлайне, и не все еще понимали, что это бот. Когда робот получал сообщение, он искал в огромных чат-логах сообщения, содержащие максимум слов из запроса, и при этом имеющие какой-то ответ. Ответом называется следующее сообщение, направленное пользователю кем-то (типа «Вася: да иди ты знаешь куда!» является ответом на сообщение Васи). Там в интерфейсе чата надо было кликнуть на сообщение, а потом на него отвечать. При наличии нескольких вариантов (а всегда было несколько вариантов, трафик болтающих большой), выбирался случайный.

Получился такой робот, который очень забавно отвечает на вопросы. Если его спросить, как его зовут, он всегда будет отвечать разными именами, но отвечать в тему, со смайликами и приписками, часто матерясь. Также бот всегда давал адекватные ответы на стандартные вопросы вида «где живешь» или «сколько лет». Поскольку история накопилась огромная, и говорили там о всем вообще, было сложно найти вопрос, на который система не давала интересный/правильный/забавный ответ.

Так вот, у бота был интересный сайд-эффект. Если начать на него обидно материться, он начинает материться взад еще более обидно. Ну и вообще часто неадекватно реагирует на наезды и упреки. Ну просто потому, что в реальных диалогах на вежливый вопрос отвечают вежливо, а на невежливый — разумеется, грубо. Аудитория там с этим ботом очень развлекалась.

Особенно было интересно читать логи самого бота потом. Там же народ не понимал, что это робот. Его что-то спрашивали, с ним ругались и мирились. Было весело)