Навыки программиста для работы с AI в генерации кода | 2025-08-04T14:28:45

Я сейчас ну очень много использую Gemini для генерации кода, и вижу скилл, который нужно иметь программистам, чтобы быть успешными на этом поприще. Это умение быстро читать и понимать чужой код, а также умение объяснить, почему генерацию AI нужно переделать и как. Для первого нужно просто очень хорошо знать язык и читать «с листа», потому что времени вдумываться будет мало. Для второго нужно хорошо знать паттерны и понимать, где они применимы, а где — нет. AI еще долго будет лажать с использованием паттернов не к месту.

Кроме этого, человеку все еще нужно будет понимать «как единое целое» на 90% код, который сгенерировал AI, и также успевать находить время на осознание каждой сгенерированной строки кода. Если расслабиться и упустить, то система может родить даже работающий, но очень плохо поддерживаемый код. Например, есть негласное правило, что отдельные файлы должны содержать не так много кода, и если он растет, то нужно делать рефакторинг, разбивая один большой на два или три. Иногда это требует переписывания логики, но это переписывание всегда направлено на одну задачу — упростить поддержку. А AI при переписывании еще и «улучшает» код заодно. И это довольно сложно запретить.

Кроме этого, сама концепция LLM предполагает ограниченность контекстного окна. Которое кодом забивается очень быстро. Чтобы была иллюзия у пользователя, что все работает даже при большом объеме кода, LLM умеют делать предварительную обработку, вытаскивая для процессинга только релевантные куски и откладывая в сторону нерелевантные, чтобы релевантные поместились в реальное контекстное окно. Но этот процесс очень ненадежный, и один раз он срабатывает, а во втором оказывается, что отложили в сторону важное, и в итоге система не увидела всю картину и сгенерировала код, в котором есть функция, очень похожая функции, отложенной в сторону, и вот у нас теперь есть две почти одинаковые.

Кроме этого, сейчас логика распределена между БД и кодом. То есть, данные часто управляют кодом. А данные в LLM просто часто не помещаются. Их слишком много. В итоге, без программистов пока с текущими архитектурами LLM не обойтись. Но вот требования к квалификации программистов только вырастут с LLM, а не упадут. Так что да, джуниорам надо волноваться, но лидам не очень 🙂
Технологическая утопия под контролем: цифровой мир Северной Кореи | 2025-07-13T00:58:24

В последнем видео о Северной Кореи от Ланькова услышал интересное: владелец устройства не может открыть ни на компьютере, ни на телефоне чужой файл, если тот не подписан специальной электронной подписью от государства. Заинтересовался деталями, накопал для себя и для вас детали.

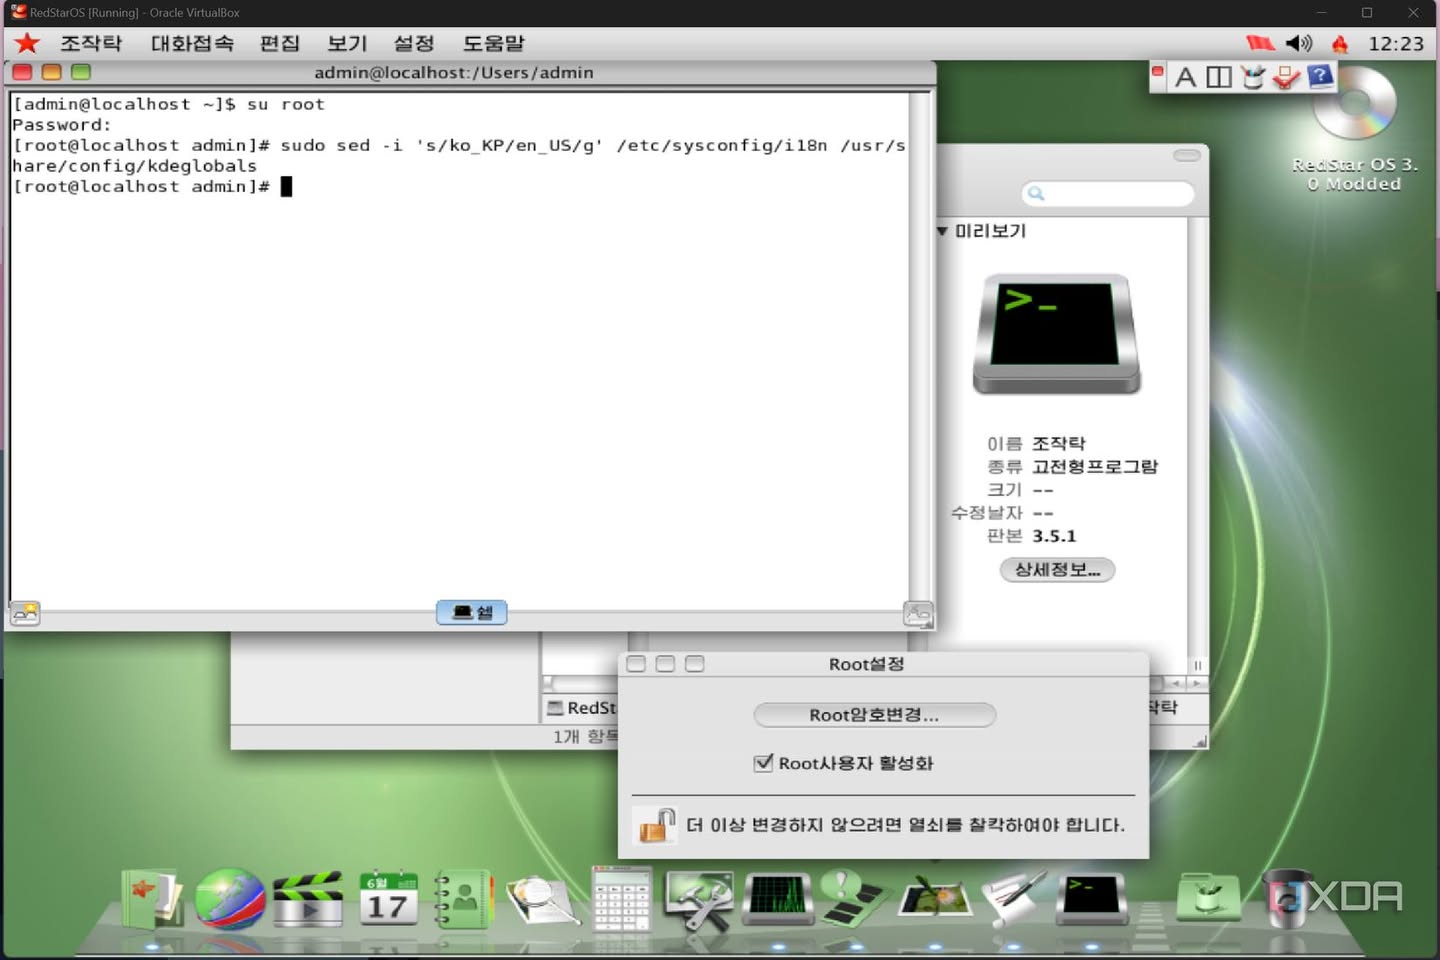
На телефонах у них модифицированный старый «KitKat» Android (2013), а на компах — модифицированный Fedora линукс, Red Star OS 3, с оболочкой, имитирующей интерфейс macOS от Apple (предыдущая косила под Windows XP). Пишут, что этот выбор дизайна, возможно, был сделан под влиянием того, что лидер Ким Чен Ын был замечен с iMac на своем столе, и видимо, сказал сделайте так же.

Северокорейские смартфоны оснащены скрытыми функциями слежки, которые автоматически делают скриншоты каждые пять минут, сохраняя их в секретной папке, доступной только властям, а не пользователю. По другим данным, скриншоты делаются при старте приложений, видимо, псевдослучайно. Еще есть цензура: если вводишь в любом приложении “Южная Корея” (남조선), система автоматически заменяет это на “марионеточное государство” (괴뢰국가). Сто процентов телефонов, очевидно, китайские, доработанные Китаем под Корею. Кстати, собираемые скриншоты доступны пользователям, но удалить их нельзя. Это приложение Trace Viewer явно создано для того, чтобы напоминать пользователям: всё, что они делают на планшете или телефоне, может быть известно правительству,

Весь медиаконтент в Red Star OS, включая документы, изображения, аудио- и видеофайлы, автоматически помечается водяным знаком с уникальным серийным номером жесткого диска, что позволяет властям отслеживать его происхождение и распространение. То есть, вы не можете сделать фотку и кинуть ее кому-нибудь, потому что она либо просто не откроется на том телефоне, либо, видимо, в редких ситуациях, если шаринг разрешен, в новом месте будут следы как того, кто является автором фотки, так и того, кто является следующим владельцем. Но это недоработано, и прямой обмен файлов все-таки ограничен. Вы можете только использовать ее сами. Разумеется, ничего нельзя удалить с телефона бесследно. Не разрешено иметь более одного устройства на человека (кажется, распространяется на отдельно планшет и отдельно телефон).

Северокорейские мобильные устройства используют строгую систему цифровых подписей (NATISIGN для одобренного правительством контента и SELFSIGN для контента, созданного на устройстве), что означает, что любой файл без этих подписей не может быть открыт в принципе. Система подписи и проверки подписи находится на уровне операционной системы, а не приложений. Это относится вообще ко всем файлам, которые люди создают что на телефонах, что на компах. Я вижу тут огромное число edge cases, но информации мало, а спросить не у кого.

Наказания за доступ к несанкционированным иностранным медиа, таким как K-pop или южнокорейские драмы, исключительно суровы. Если на компакт-диске, вставленном в компьютер с Red Star OS, обнаружен «нежелательный файл», система извлечет компакт-диск, запишет путь к файлу, отобразит графическое предупреждение, сделает скриншоты, а затем принудительно перезагрузит систему через 1000 секунд.

Северная Корея управляет национальной интранет-сетью под названием Кванмён, «огороженным садом», который полностью изолирован от глобального интернета и доступен большинству граждан только для одобренных правительством веб-сайтов и систем электронной почты.

При первом запуске браузера Naenara (основан на Firefox 3.5) домашней страницей по умолчанию является IP-адрес «10.76.1.11». То есть их интернет — это по сути интранет.

Как редко я перезагружаю свой Mac: всего четыре раза в год | 2025-07-11T20:18:22

На маке есть команда last reboot, из которой выходит, что я перегружал комп за последний год всего четыре раза.

Оптимизация полнотекстового поиска: платформа для анализа и улучшения результатов | 2025-07-06T04:35:44

У меня есть наработки в области тестирования полнотекстового поиска. Прямо готовая рабочая многопользовательская платформа, которой даёшь условно 1000 запросов, несколько конфигураций поисковой машины, и к утру она выдаёт отчёты с графиками, метриками, и заключением, что конфигурация A перформит лучше, чем B, и вот почему. Рассчитывает все эти NDCG@k, MAP, precision, recall, и ещё с десятка два разного. Использует LLM, но уже на последней стадии, после того, как вся математика закончилась.

Так вот, в чем вопрос. Я ищу кого-нибудь, кто задавался такой же проблемой на своём проекте, чтобы понять деманд и аск.

Проблема, которую решает система, формулируется так: есть рабочий поиск по товарам, документам, — Solr, Coveo, Elasticsearch, Algolia — неважно, и есть гипотезы как сделать его лучше, но есть и опасение, что сделав лучше в одном, мы сломаем другое. Вот моя штука помогает это увидеть в цифрах и графиках, дать заключение с обоснованием, включающим статистическую значимость и другие метрики.

Ещё она умеет быть виртуальным поисковым ассессором. Она для каждого результата поиска может давать оценку, несколько хорошо каждый из документов соответствует запросу. Это очень нетривиальная задача (особенно для больших документов), там включаются chunking, embeddings, LLM evaluation of relevant chunks и т.д. Нетривиальная, но работает.

Ещё она умеет анализировать поисковые запросы и разбивать их на группы по похожести. Например, такое разбиение может показать, что пользователи иногда ставят пробел между словами, образующими бренд товара, а иногда нет. Эти разные варианты попадут в одну группу.

Мне бы хотелось это обсудить с кем-то, кто может лучше меня в этой теме, у кого есть/были такие проблемы и кто может их как-то решил.

У меня сейчас ощущение, что мой продукт единственный на рынке. Точнее, он ещё даже не на рынке. Но вообще ничего похожего я не вижу. Может, никому это и не надо?

Скриншоты не буду открыто публиковать пока. Картинка для, привлечения внимания.

Пошарьте плиз если в вашем нетворке могут быть нужные люди.