Автоматизация кросс-постинга: боремся с трудностями API Facebook | 2026-05-23T14:28:22

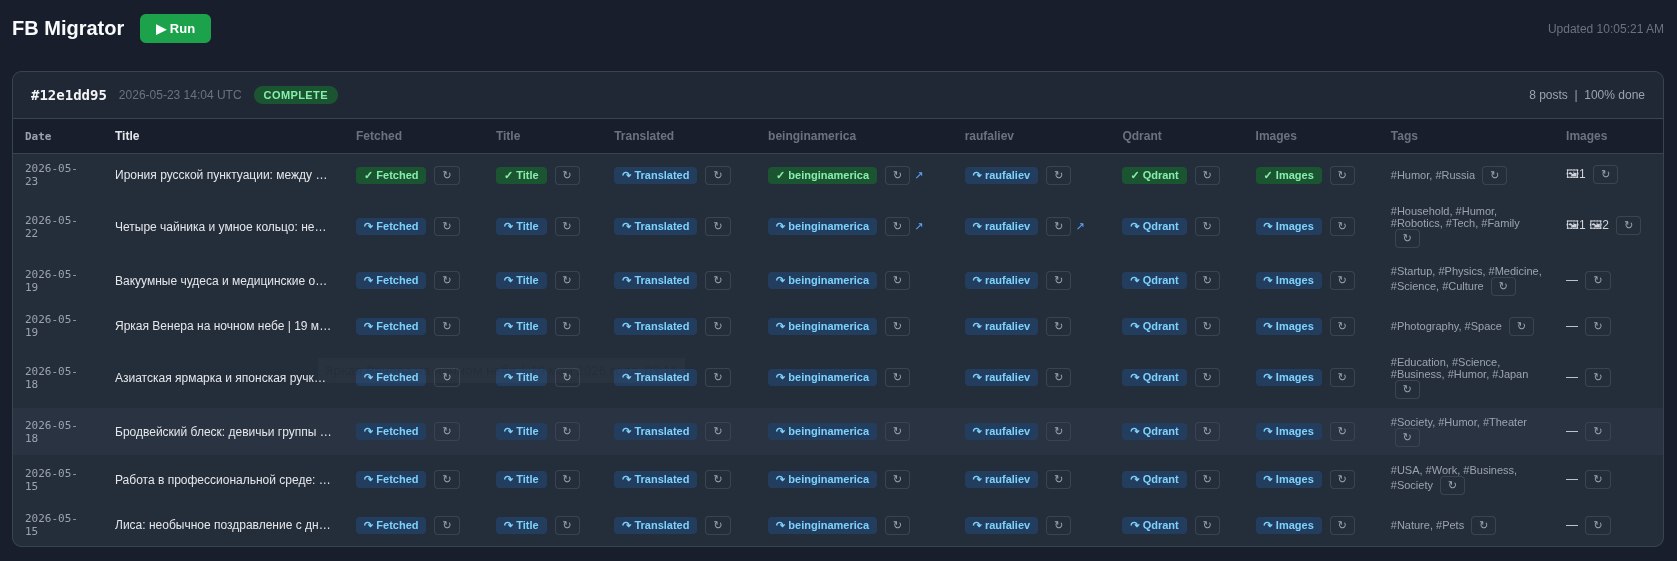
Доделал в лучшем виде кросс-постинг из фейсбука на два моих сайта-блога [на которые почти никто не заходит] — beinginamerica точка com и raufaliev точка com. При публикации нового поста в фейсбуке по расписанию стартует механизм перевода поста на английский, разбор приложенных картинок, генерация описаний к ним, создание заголовка на основе текста поста и описания картинок, создание тегов на их же основе, запись поста в turso db — это облачная база, бесплатная до определенных лимитов, создание эмбеддингов через openai, запись в qdrant cloud — это тоже облачная база, но уже векторная, ну и загрузка изображений в wordpress по API, и публикация поста на английском и на русском по API.

Все бы хорошо, но из всех API самый дурацкий — у фейсбука. Во-первых, для страниц как у меня, переведенных в New Experience, нет возможности использовать почти все из этого API. Точнее, есть, но нужно долго доказывать фейсбуку, что это реально надо, показывая документы на стартап, демонстрируя приложение и т.д. Очевидно, им не хочется иметь дело с чем-то уносящим контент из их системы во вне. Кроме этого, токен, который дает доступ к последним сообщениям, относительно короткоживущий (возможно, несколько недель), и получать его заново нужно через браузер только. То есть, любая автоматика требует регулярного внимания, иначе она ломается.

Если протупил и вовремя не выгрузил последние посты через этот Facebook Graph API, они просто исчезают из списка последних и все, больше по API к ним не обратиться. Единственный способ — запросить выгрузку архива у фейсбука. Эта выгрузка тоже довольно дурацкая — там нужно много трансформаций делать и убирать лишнее. Например, в файле с постами, который я обрабатываю, там почему-то хранятся ссылки, которые я отправлял в комментариях без сопроводительного текста. А комментарии там идут в отдельном файле!

Чтобы назначить теги, пришлось решить отдельный челендж. Вот есть около 10000 постов за все время. Это большой кусок, и по нему теги построить нельзя, потому что он в контекстное окно LLM не помещается. А надо. Поэтому я делал так: скрипт берет случайные посты из 10000 в таком объеме, чтобы их суммарный размер был чуть меньше указанного лимита в токенах, и в конец этого блока добавляется промпт «сгенери мне наиболее частые теги, 30 штук» (промпт привожу упрощенно). В итоге я запустил это 10 раз и получил 10 наборов тегов по 30 штук, сгенерированных для разных срезов базы. Получилось 300 тегов, из которых конечно есть полные дубликаты, а есть синонимы и близкие по смыслу. Это все скармливается LLM, и получаем список тегов и иерархию тегов. Теперь у нас есть ограниченный набор тегов, которые максимально отражают 10000 постов. Так получилось, что за почти 20 лет на фейсбуке у меня расклад такой:

Тег Постов

==================================================

#Russia 3412

#Thoughts 3146

#Tech 3105

#Culture 2765

#Hobbies 2726

#AI 1603

#Science 1367

#Software 1358

#Travel 1298

#Learning 1138

#Society 1050

#Nature 958

#Education 915

#Business 902

#Art 894

#Programming 889

#Humor 840

#History 807

#Gadgets 750

#Moscow 713

#USA 614

#Cinema 567

#Webdev 493

#Music 476

#Sports 473

#Mindset 443

#Auto 400

#Books 386

…

ну и так далее. Этот список включает как теги из ограниченного списка, так и теги, которые LLM поставила материалу просто потому, что не нашла в ограниченном ничего подходящего.

Теги из ограниченного списка стали категориями на сайте. Остальные теги + эти стали просто тегами wordpress.

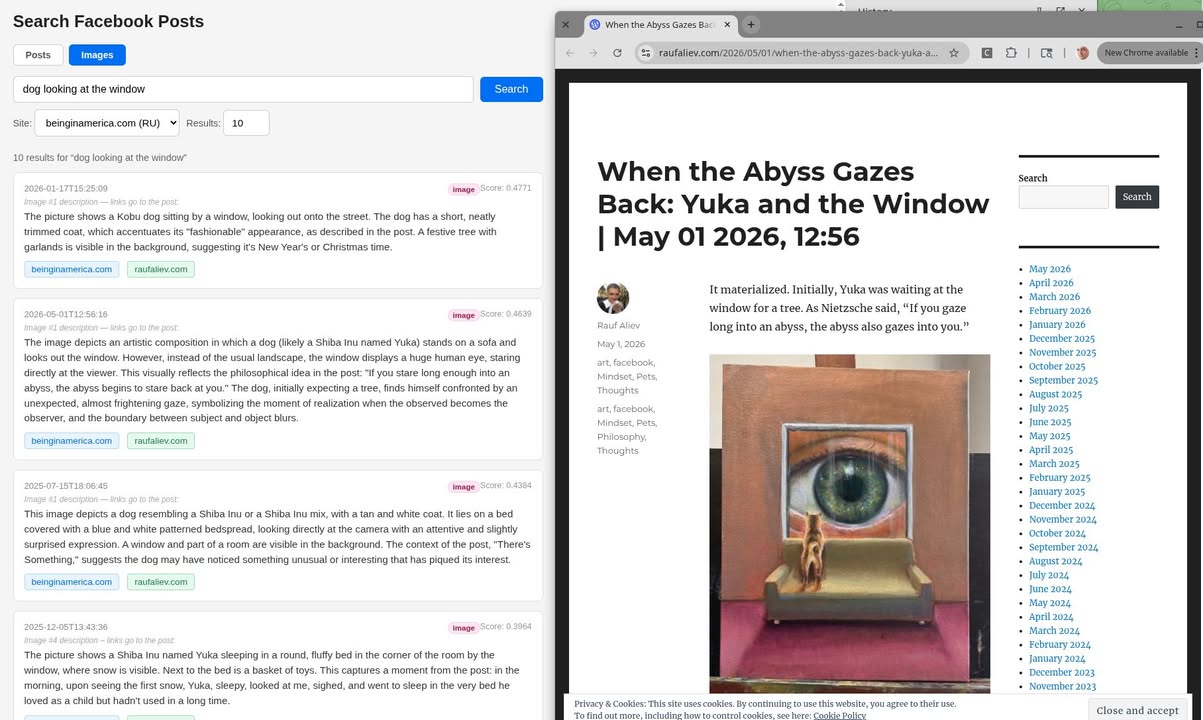
Поиск по картинкам. У меня было две идеи как его сделать. Первая — OpenCLIP. Это довольно просто, но требует хостинга модели где-нибудь. На своей машине легко, но каждый раз ее запускать неудобно, плюс я планировал переносить мигратор на дешевый сервер в амазон. В облачных моделях тоже нормально считать, но хоть немного за это надо платить, а это еще одна dependency. Но главное — что и без этого неплохо работает. Я с помощью OpenAI , который и так используется для перевода на английский, генерю описания к картинкам, и дальше по этим описаниям делаю embeddings с помощью large модели. Пока что все тесты на поиск проходят на ура. Особенно, когда на картинке есть текст, и большой вопрос разобрал бы ли его OpenCLIP.

В итоге:

1) вордпресс raufaliev точка com — бесплатный

2) вордпресс beinginamerica точка com — бесплатный

3) turso db где хранятся все посты — бесплатный

4) qdrant cloud где хранятся эмбеддинги — бесплатный

5) openai для перевода и описания картинок — не бесплатный, но недорогой (обработка постов за год потребовала 30 баксов).

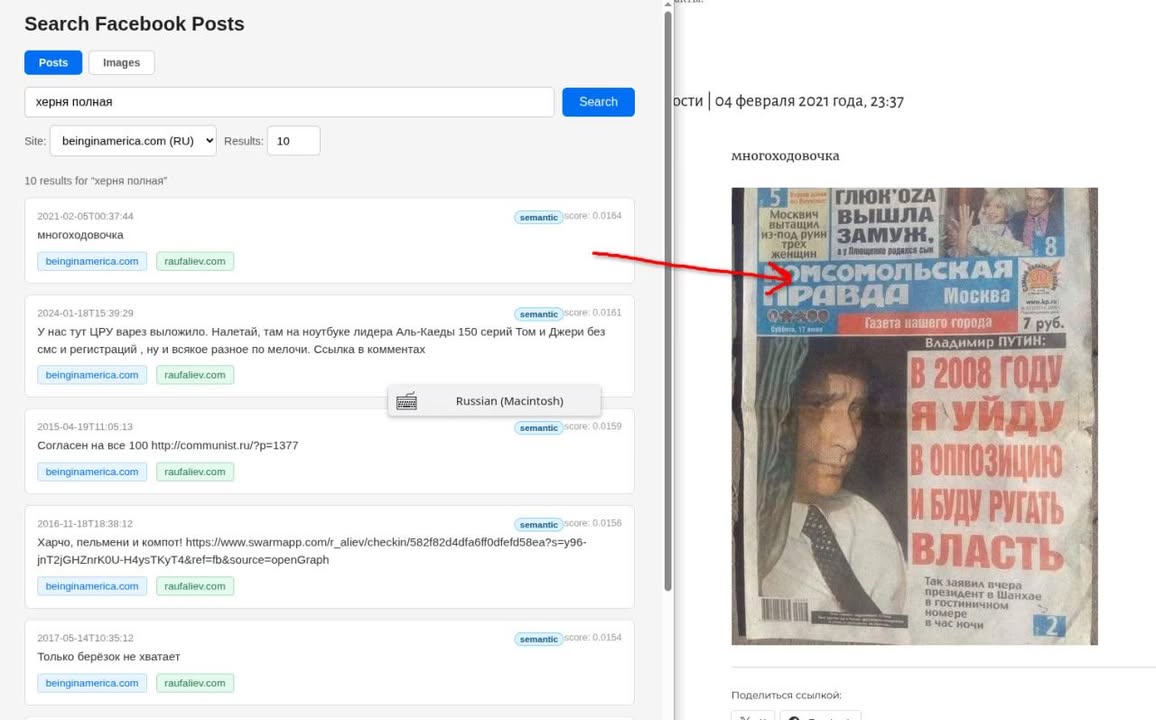
Прикладываю два скриншота — как работает поиск по изображениям, и по текстам, а также дашборд мигратора.
Диплом с отличием: путь программиста Рауфа Велиевича | 2026-03-21T13:54:58

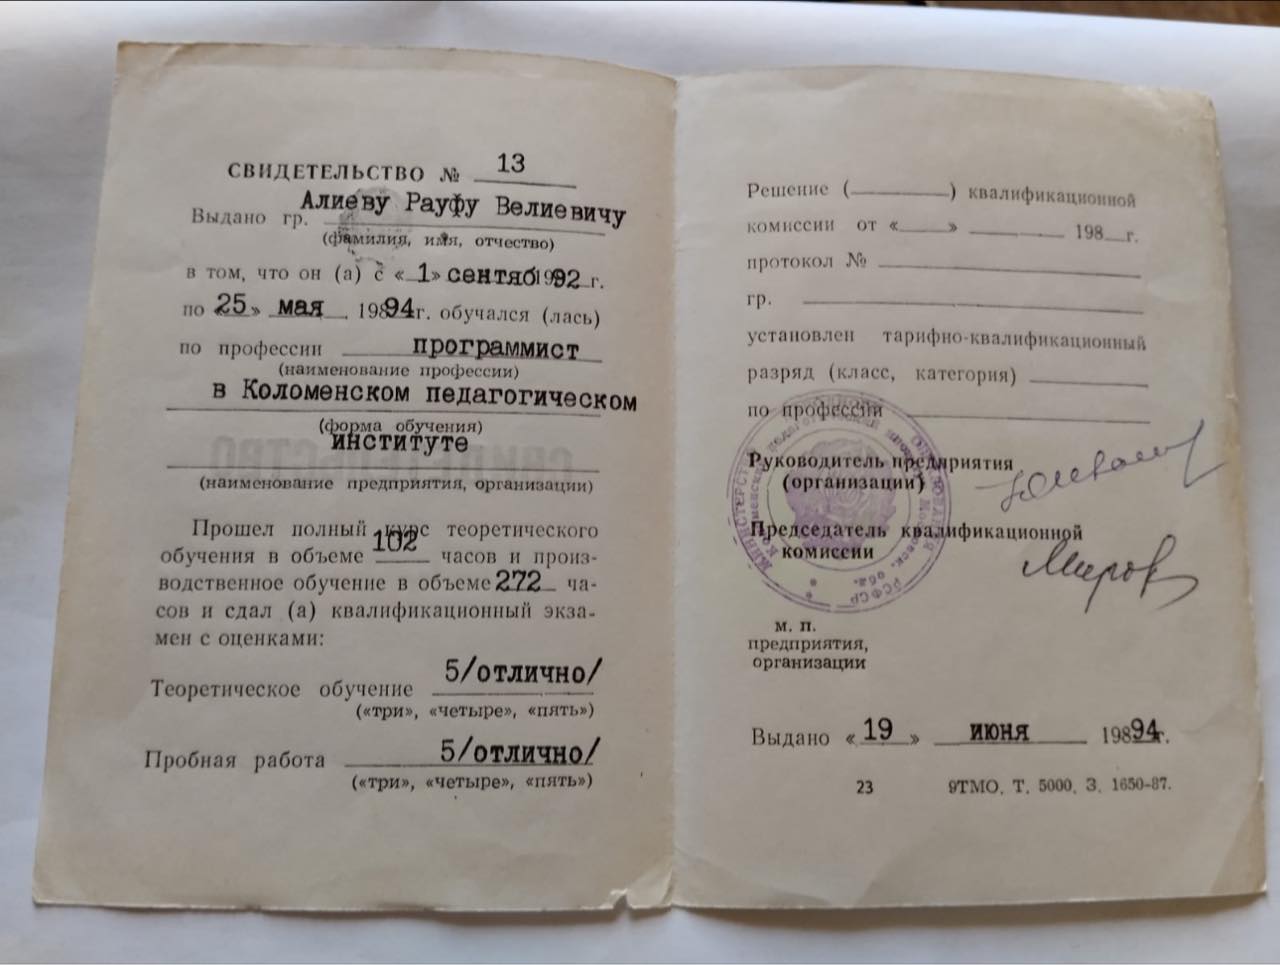
Мама прислала. Это мне с окончанием школы выдали. Хорошее школьное образование было по крайней мере в то время. Часть занятий по точным наукам шла в институте

Косинусы военного времени: от теории к абсурду | 2026-03-11T22:00:50

«Товарищи курсанты, в военное время значение косинуса может достигать 2, а в исключительных случаях, когда того требует сложившаяся на фронтах обстановка, даже 3!»

Планы на 2026: от Галапагосских островов до PhD | 2026-01-20T04:44:36

Мой план на 2026:

— Уехать на неделю на Галапагоссы, в Эквадор (лето)

— Дописать и выпустить книжку по Information Retrieval (тоже лето, идет медленно, пара первых глав уже написана. Уже потратил на эту тему часов 50-100, то, что шло легко)

— Выпустить как минимум одну научную статью, видимо по Data Mining (весна). В идеале засабмиттить куда-нибудь в журнал (сложно). Уже потратил на эту тему часов 30, осталось еще дохрена.

— Сделать шаг к PhD. Найти профессоров, посетить универы, понять цену вопроса и оценить свои возможности и ресурсы.

— Продолжить изучать фундаментальную математику и не умереть (линейная алгебра, матанализ, тервер, статистика, классическое ML). В 2025 потратил на эту тему часов 200-400.

— Продолжить изучать Deep Learning и дойти до уровня «могу преподавать». В 2025 потратил на эту тему часов 100-200.

— Продолжить изучать Data Mining/NLP.

— Актуализировать мою книжку по RecSys, выпустив версию 2.0 включив обновления и исправления (осень 2026)

— Добиться видимого прогресса в живописи и игре на фортепиано. Конкретно, доучить серенаду Шуберта (Ständchen, D 889) и сделать хотя бы один холст, который не стыдно подарить.

Различия в научных терминах: от России до мира | 2026-01-14T04:46:24

Сегодня с удивлением узнал, что сила Кориолиса оказывается произносится как сила КориолИса, а не кориОлиса, как нас в школе учили. Начал разбираться, а что еще не так, и выяснилось удивительное.

Оказывается, то, что у нас называлось законом Гей-Люссака, во всем остальном мире называется Законом Шарля, а то, что у нас называлось Законом Шарля, во всем мире называется Законом Гей-Люссака.

Декартова система координат тут Carthesian. Cartesius — это просто латинизированное имя Рене Декарта.

В наших учебниках закон сохранения массы называется Законом Ломоносова — Лавуазье (что вступило в хим. реакцию = массе образовавшихся веществ). Во всем остальном мире это исключительно Закон Лавуазье (Lavoisier’s Law). Ломоносов тут затесался только из-за «сколько чего у одного тела отнимется, столько присовокупится к другому».

Еще оказалось, что если на английском придется кому-то объяснить теорему Пифагора, то без подсказки вообще невозможно догадаться, что это Пайтагорас. С греческими именами вообще беда. Фалес тут произносится как Тейлиз.

Почему-то Roentgen в физике называют РентгЕном. Хотя он Рёнтген с ударением на ё.

В России трапеция — это четырехугольник, у которого две стороны параллельны, а две нет. В США наша трапеция называется Trapezoid. А словом Trapezium тут называют четырехугольник, у которого вообще нет параллельных сторон. В Великобритании же все наоборот. Наша трапеция — это Trapezium, а «кривой» четырехугольник — Trapezoid.

Сравнение учебных нагрузок: США vs СССР/Россия | 2025-12-10T17:35:36

К вопросу про образование в США и в СССР/России. Мой диплом в США эвалюирован как Master of Science degree in Computer Science. Мои коллеги помоложе говорят, что диплом российского вуза редко сейчас признается как Master, и часто даже на Bachelor тянет с трудом. Я решил посмотреть на цифры и очень удивился.

Для того, чтобы получить бакалавра в США, нужно потратить примерно 2000 часов в аудитории/лабораториях. Это в пересчете на кредиты дает 120 кредитов (credit hours). Один кредит — это обычно 1 час (50 минут) лекций в неделю в течение семестра (15 недель). Лабораторные работы имеют другой коэффициент (часто 2–3 часа в лаборатории считаются за 1 кредит), поэтому реальное количество часов в аудитории будет немного выше (ближе к 2000+).

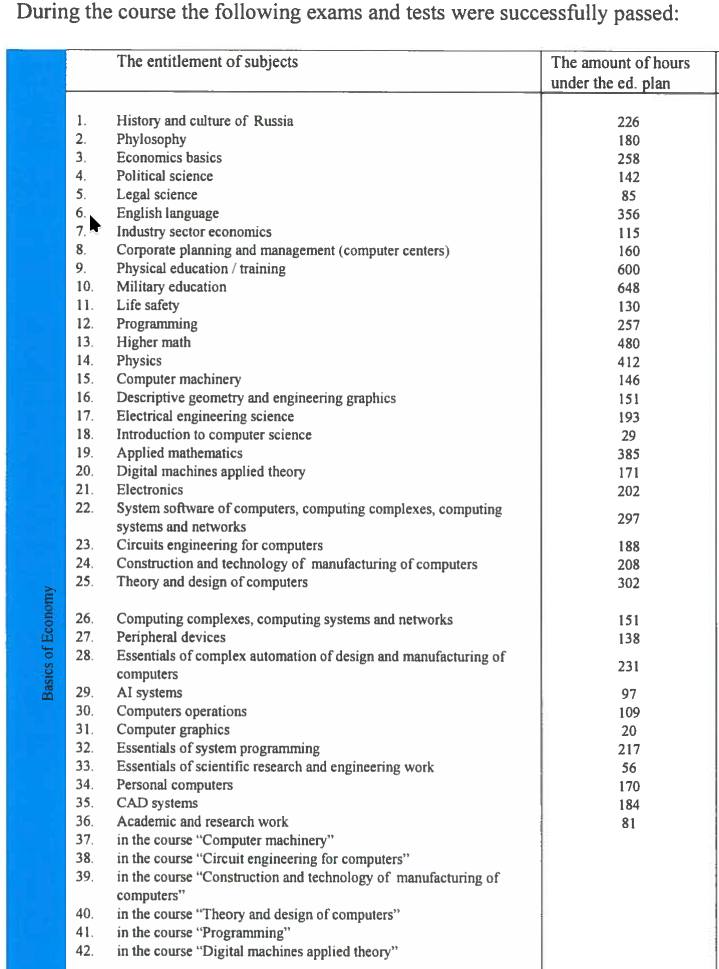
Так вот, у меня в дипломе написано, что я потратил только на парах 7908 часов за пять лет. То есть, это в 4 раза больше, чем типичный студент в США. По цифрам выходит, что у меня только математика, физика, и английский подбираются к 2000 за пять лет, а всего предметов там 42 штуки.

Товарищ поделился, что в его дипломе бакалавра из России уже 3140 академчасов, что в два раза меньше. А поделитесь, сколько у вас в дипломе часов?

Год выпуска, универ, специальность и число часов? Интересно, насколько сильный разброс.

Википедия: когда сложность становится барьером | 2025-11-26T01:06:17

У википедии есть одна большая проблема. Ну или у нас с википедией. Если зайти на практически любую страницу википедии об относительно сложном математическом или физическом понятии, часто резко перестает хотеться ее дальше читать. Формально там все верно, но объяснение дается через концепции, часто еще более сложные, чем объясняемая. Кроме этого, там дается часто много лишнего — то, что формально/академически/таксономически находится внутри темы, но по сути «загрязняет» получение первого впечатления.

Эта проблема возникает потому, что у авторов Википедии (часто математиков) приоритет стоит на строгости и полноте, а не на дидактике и понятности.

В англоязычной среде такое иногда называют «Drift into pedantry» (скатывание в педантизм). Статьи часто пишутся экспертами для экспертов, а не для тех, кто пытается изучить предмет с нуля.

Вот возьмем, например, «тензор». Представьте студента, который слышал, что тензоры используются в машинном обучении (Google TensorFlow) или физике, и хочет понять суть.

Чего ждет читатель (интуиция): «Тензор — это таблица чисел (ну или какой-нибудь контейнер данных), которая описывает свойства объекта и правильно изменяется, если мы повернем систему координат»

Что дает википедия: «Те́нзор (от лат. tensus, «напряжённый», по классической раскладке механического напряжения на гранях деформируемого куба, см.иллюстрацию) — раскладка (расположение в пространстве) чисел (компонент), применяемая в математике и физике как особый тип многоиндексного объекта, обладающего математическими свойствами.» Статья сразу же начинает перечислять ранги, ковариантность и контравариантность индексов. Это формально верно, но это «загрязняет» первое впечатление.

Иллюстрация в самом верху подписана вот так: «Механическое напряжение, деформирующее куб с гранями, перпендикулярными осям координат, в классической теории упругости описывается тензором напряжений Коши (англ. Cauchy stress tensor), который связывает 2 индекса: вектор нормали к грани с вектором напряжения Т (сила на единицу площади); имеются 3 направления нормалей и 3 направления компонент напряжения, что даёт тензор 2-го ранга 3×3 — из 9 компонент.»

Формально — ни одной ошибки. Фактически — это стена текста, которая требует знания линейной алгебры, чтобы просто прочитать определение.

Это как если бы вы спросили «Что такое яблоко?», а вам ответили: «Яблоко — это плод растений подсемейства Сливовые (Amygdaloideae) или Спирейные, обладающий эпикарпием, мезокарпием и эндокарпием, часто участвующий в гравитационных экспериментах Ньютона».

С одной стороны, кажется, что с появлением LLM википедия как бы больше не необходима. Есть же условно LLMы типа ChatGPT, которые по сути пересказывают все то, что есть в wikipedia в нужном виде. Но они так делают, потому что их обучили на википедии, причем наверняка именно википедии дали сильно больше веса при обучении, чем всякому шлаку в интернете. Если бы не было википедии в обучающем сете, все было бы сильно сложнее. При этом википедия постоянно редактируется, и LLM и Google используют именно ее при ответах на вопросы.

Поэтому, с одной стороны, мне кажется, что википедии давно пора переходить на генерацию на основе курируемых экспертами данных и упаковывать знания в требуемом формате, например, в виде вопросов-ответов. С другой, теряется вся идея мастер-данных энциклопедии для LLM/RAG.

Парадокс в том, что LLM — это, по сути, единственный «интерфейс», который смог прочитать эти педантичные определения Википедии, «понять» их (через тысячи примеров кода и статей) и перевести обратно на человеческий язык. Википедия стала отличной базой данных для роботов, но плохим учебником для людей.

Интерактивное обучение 1986: «Химический тренажер» | 2025-11-23T15:55:06

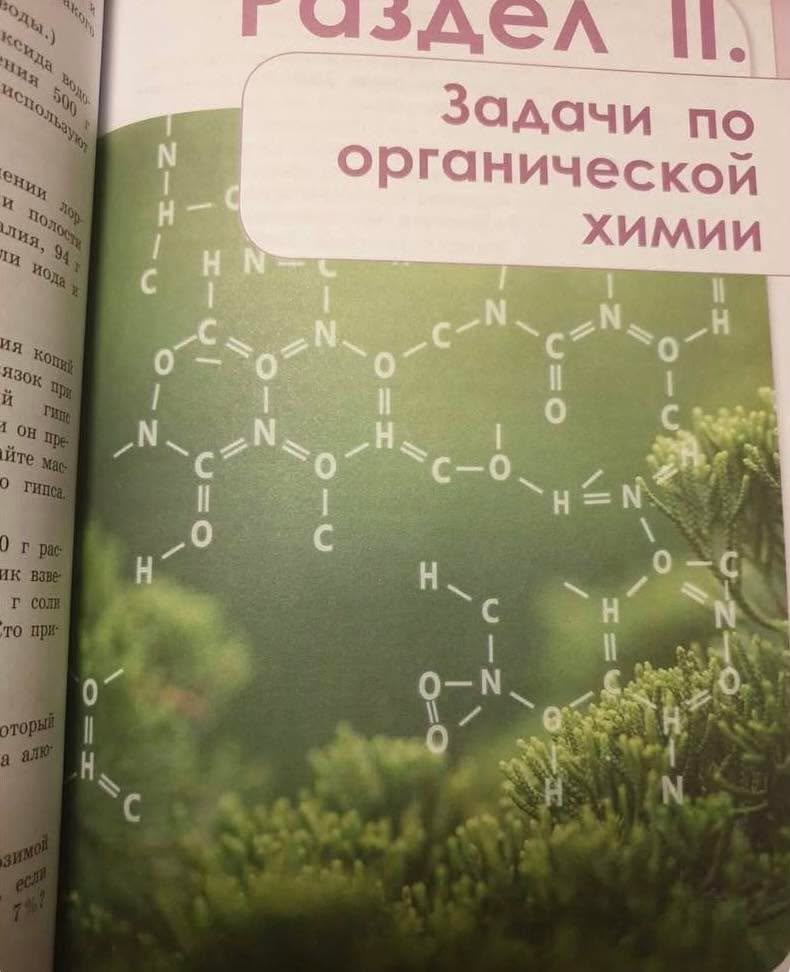
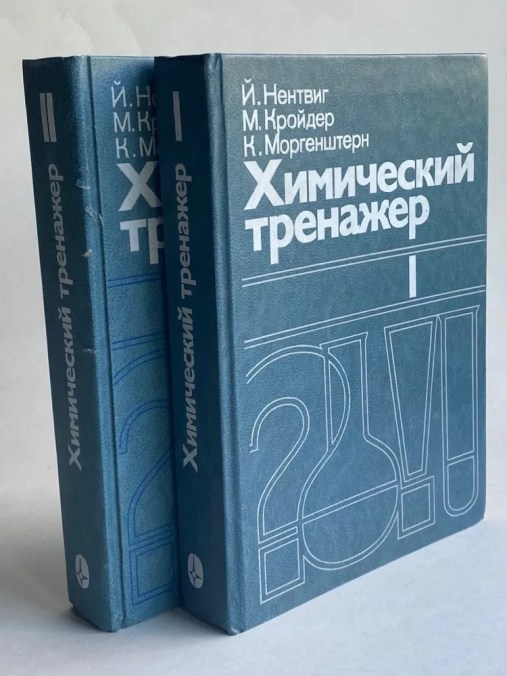
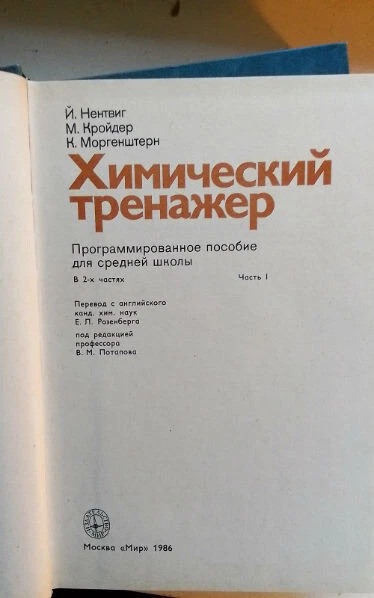
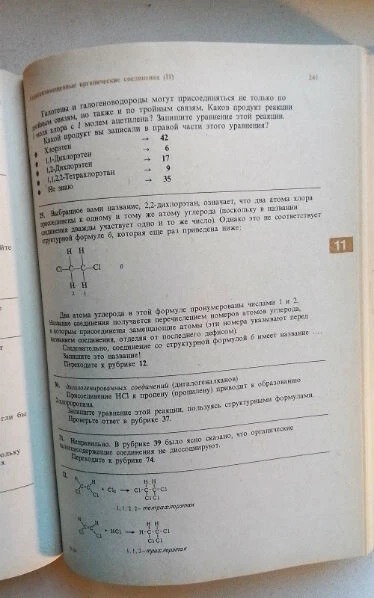
У меня дома в Коломне есть книжка Химический тренажер 1986 года. Я таких никогда не до и не после не видел.

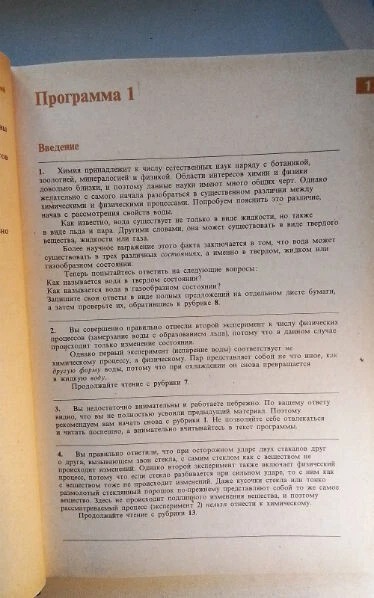
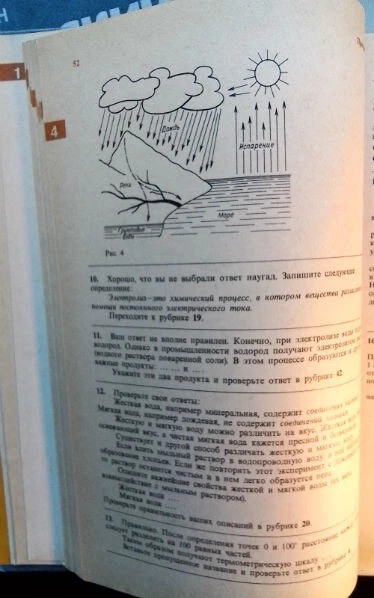
Материал каждой из 54 программ подразделяется на множество мелких, очень коротких частей, или рубрик. В конце каждой рубрики задается один или несколько вопросов. Это делается с целью проверить – действительно ли понято содержание данной рубрики. У каждого ответа есть место в книге, куда нужно перепрыгнуть, чтобы почитать, правильный ли ответ. Если ответ неправильный, там описывается, почему и задается новый вопрос. Если правильный — продвигаешься в этом квесте дальше.

Эти немцы в 1986 году сделали интерактивный учебник еще до того, как это стало модным.

Илья Мечников: Жизнь в борьбе за науку | 2025-11-13T04:53:34

Читал тут биографию Мечникова (не знаю, как меня уж занесло) и подумал, как много может поместиться в одну жизнь. Это не просто учёный, это какой-то сериал:

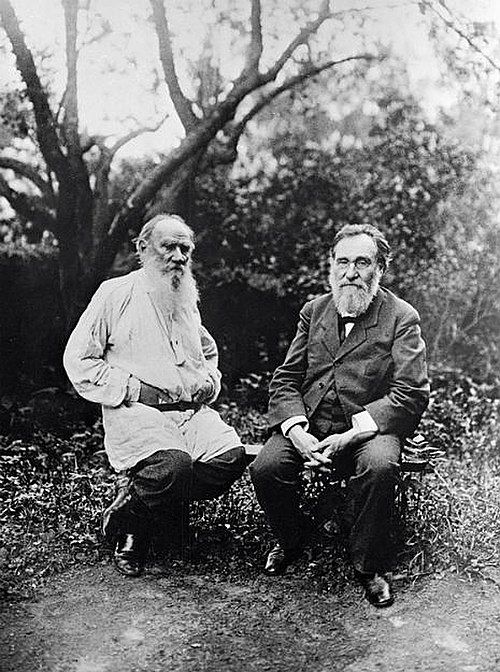
Его старший брат Иван — тот самый прототип «Смерти Ивана Ильича» у Льва Толстого. А другой брат, Лев, был видным анархистом, социологом и сражался в Италии вместе с Гарибальди. У Мечникова две попытки отправиться на тот свет: первый раз — после смерти первой жены (которую, больную туберкулезом, внесли в церковь на стуле). Он выпил морфий, но выжил. Второй раз — когда его вторая жена Ольга тяжело заболела тифом. Он сознательно привил себе возвратный тиф. К счастью, оба выжили. Зато потом смерть с косой сделала свое только после третьего инфаркта подряд.

Чувак окончил университет в 19 лет экстерном. Его рекомендовал сам И.М. Сеченов на профессорскую должность. Но Мечникова «забаллотировали» (провалили) одним голосом. В знак протеста Сеченов уволился вместе с ним.

Он основал в Одессе первую на тот момент в стране бактериологическую станцию. Но из-за ошибки сотрудника (испортили вакцину от сибирской язвы) погибло целое стадо овец. После этого скандала он уехал из России. Станция — на улице Льва Толстого.

В Париже его сразу же взял под крыло Луи Пастер (который отец пастеризованного молока), который поддержал его теорию и дал ему лабораторию в своем институте. Там Мечников и проработал 28 лет, став замдиректора.

Во время изучения холеры в Институте Пастера Мечников выдвинул теорию, что не все люди, контактирующие с возбудителем, заболевают. Он предположил, что все дело… (конечно же) в микрофлоре кишечника. Чтобы это доказать, он сознательно выпил культуру с холерным вибрионом. Ничего, пронесло (тебя бы так проснесло, подумал Мечников)

В итоге он получил Нобелевскую премию за открытие фагоцитоза (клеточный иммунитет). А еще он «отец геронтологии» — именно Мечников выдвинул теорию, что для долголетия нужно бороться с плохими бактериями в кишечнике с помощью пробиотиков. Теперь, говорят, геронтологи всего мира пьют 15 мая простоквашу вспоминая Мечникова.

Умер в Париже, его прах хранится в библиотеке Института Пастера.

А еще в английской Википедии он Élie Metchnikoff. Непросто догадаться.

На фото Мечников и Лев Толстой обсуждают иммунологию.

Профессиональные тайны юристов: от «бара» до «Esq.» | 2025-10-14T01:20:33

Оказалось, что фраза «barristers must gain admission to the bar» вообще не про бар и баристов, как я бы подумал, не прочитав, что это, оказывается, про юристов США. “Admission to the bar” — официальное допущение к адвокатской практике (для barristers). А “Barrister” — это адвокат, представляющий клиентов в суде. Есть еще “Solicitor” — юрист, работающий с клиентами и документами.

Исторически “bar” — это буквально перегородка (барьер) в суде, отделяющая место, где сидят судьи и адвокаты, от остальной части зала. “Being called to the bar” — “быть вызванным к барьеру”, то есть быть допущенным к представлению дел в суде. Сегодня “the bar” означает юридическую профессию в целом или адвокатское сообщество.

Собственно, все началось с того, что я увидел титл (professional designation) у чувака «Esq.» и понял, что я ни фига не разбираюсь в этих буковках, которые часто указываются после имени. Их огромное множество, и вы наверняка не раз видели PhD, M.D., или CPA.