Пожил несколько месяцев без автопилота в машине, сейчас включил, а машина за это время научилась не просто приезжать на место через весь город и просёлки, но и находить парковку у места назначения и сама парковаться. Но вот когда я ей сказал домой приехать, прям указал, туда где тебя кормят (charger), она встала перед домом соседа. Заставляет задуматься;) но вообще очень круто, Тесла
Метка: AI
Создание приложения для изучения языка в полёте | 2025-12-01T15:45:11
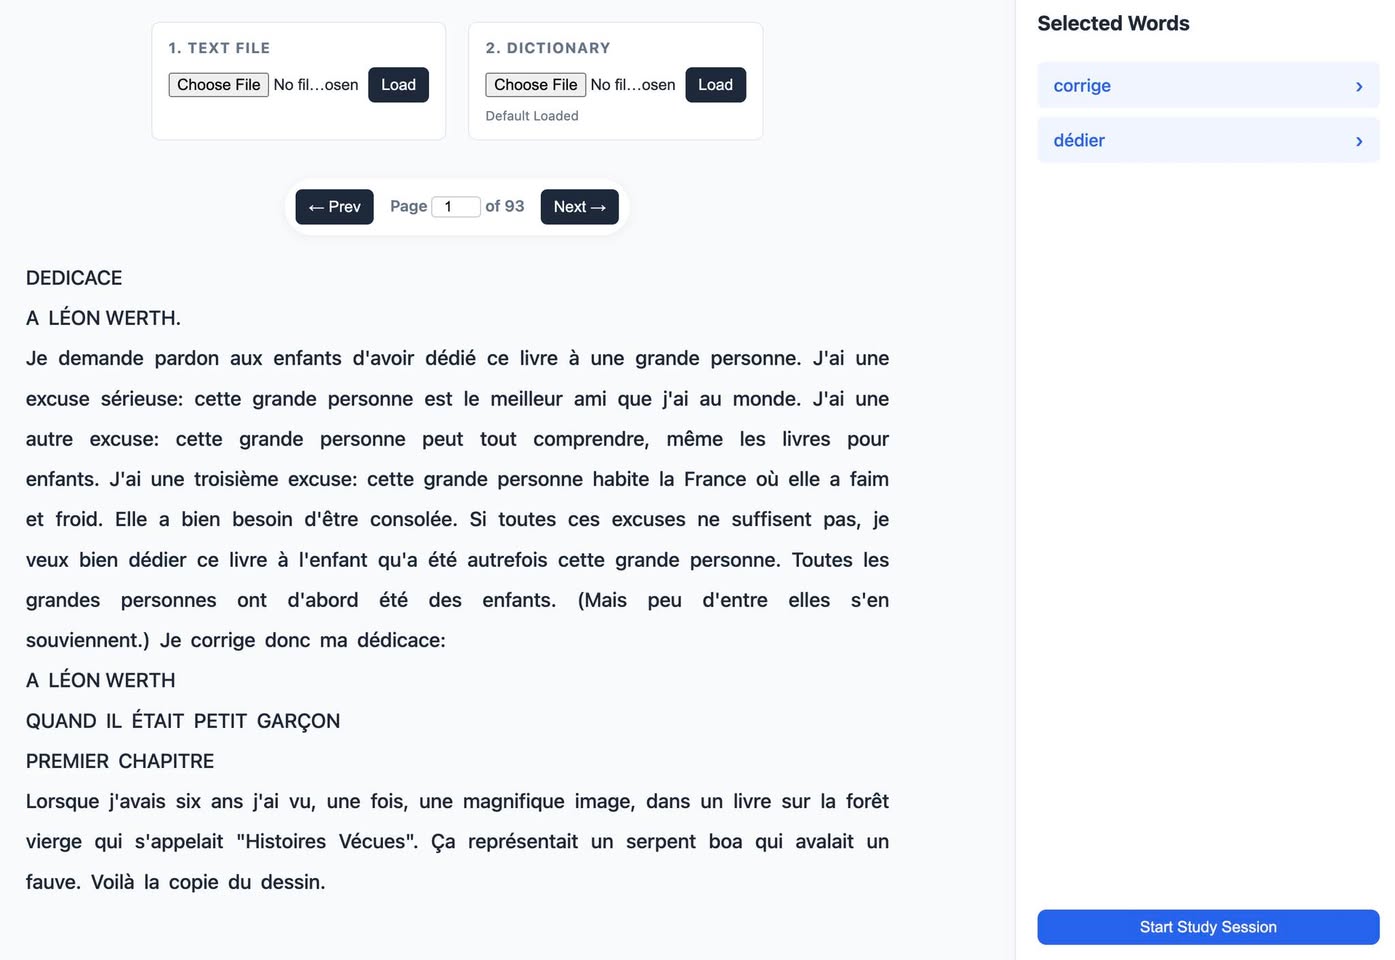
Кстати, вчера утром, пока ждал у выхода на посадку в Майами, я быстро с помощью Gemini написал приложение для изучения французского языка по идее, которую набросал товарищу, пока ехал в аэропорт, а потом в полёте использовал это приложение.
Идея в том, что в незнакомом тексте на иностранном языке пользователь сначала помечает незнакомые слова, а затем видит их переводы — но без оригинального текста, а потом возвращается к самому тексту — но уже не видя переводов. То есть, это как если бы «словарь был в соседней комнате». Гипотеза, что такой метод помогает лучше запоминать, чем когда перевод показывается сразу при клике на слово, и когда не надо прилагать усилия.
Приятно, что создание приложения с нуля до готового варианта заняло всего около 35-40 минут, а потом я еще какое-то время пользовался им в полёте, без интернета. Так как все переводы всех слов/фраз уже сделались заранее.
Только что развернул его на Render. Тоже приятно, что показать код в работе бесплатно и заняло еще минут 10.
https://readandlearn.onrender.com/
Превосходная мощь NVIDIA RTX 5090: архитектурные горизонты и digital art | 2025-12-01T01:39:52
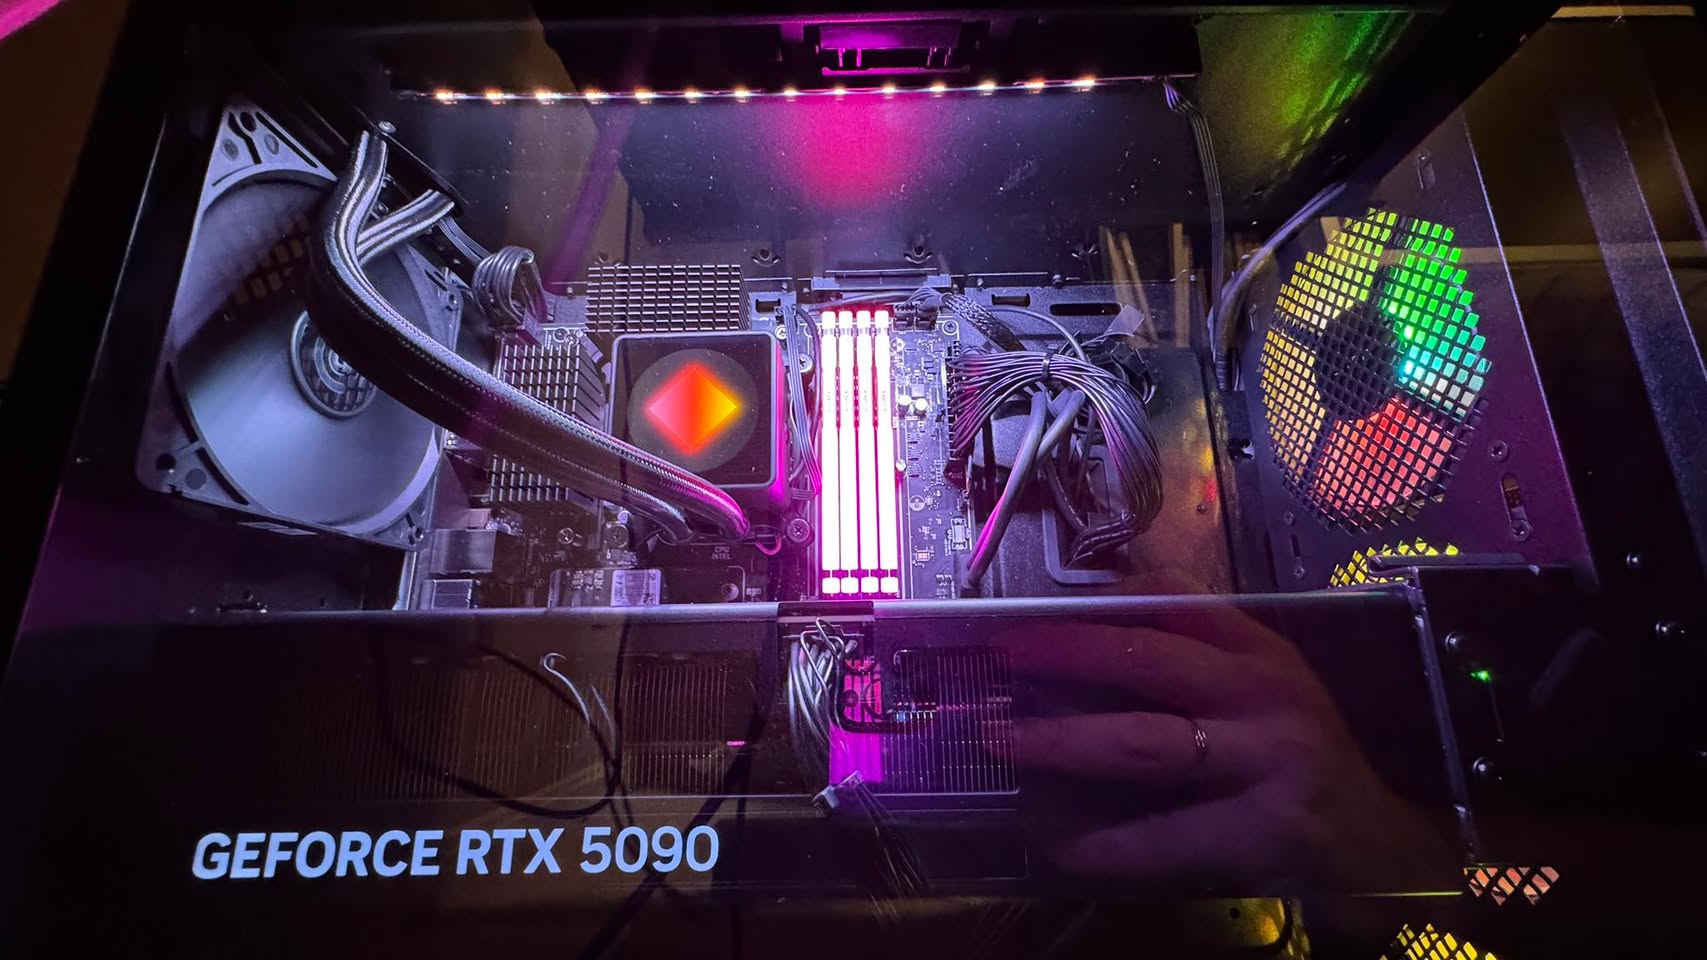
Nvidia RTX 5090 32Gb! довольный как слон. Поставил ArchLinux и CUDA. Планирую скоро поумнеть в теме прокачки трансформерных глубоких нейросеток и есть масса идей по digital art на иных идеях, чем диффузионные модели.
Производительность: Запустил сейчас тест, модель GPT_OSS_20b_UD_Q4_K_XL при контексте 131072 токенов генерит 350 токенов в секунду. То есть это условно страницу А4 за несколько секунд. Gemma3 27B — 55 токенов в секунду. Qwen3_30B_A3B_Q6_K — 259 токенов в секунду.
Рекламный парадокс ChatGPT | 2025-11-29T15:52:07
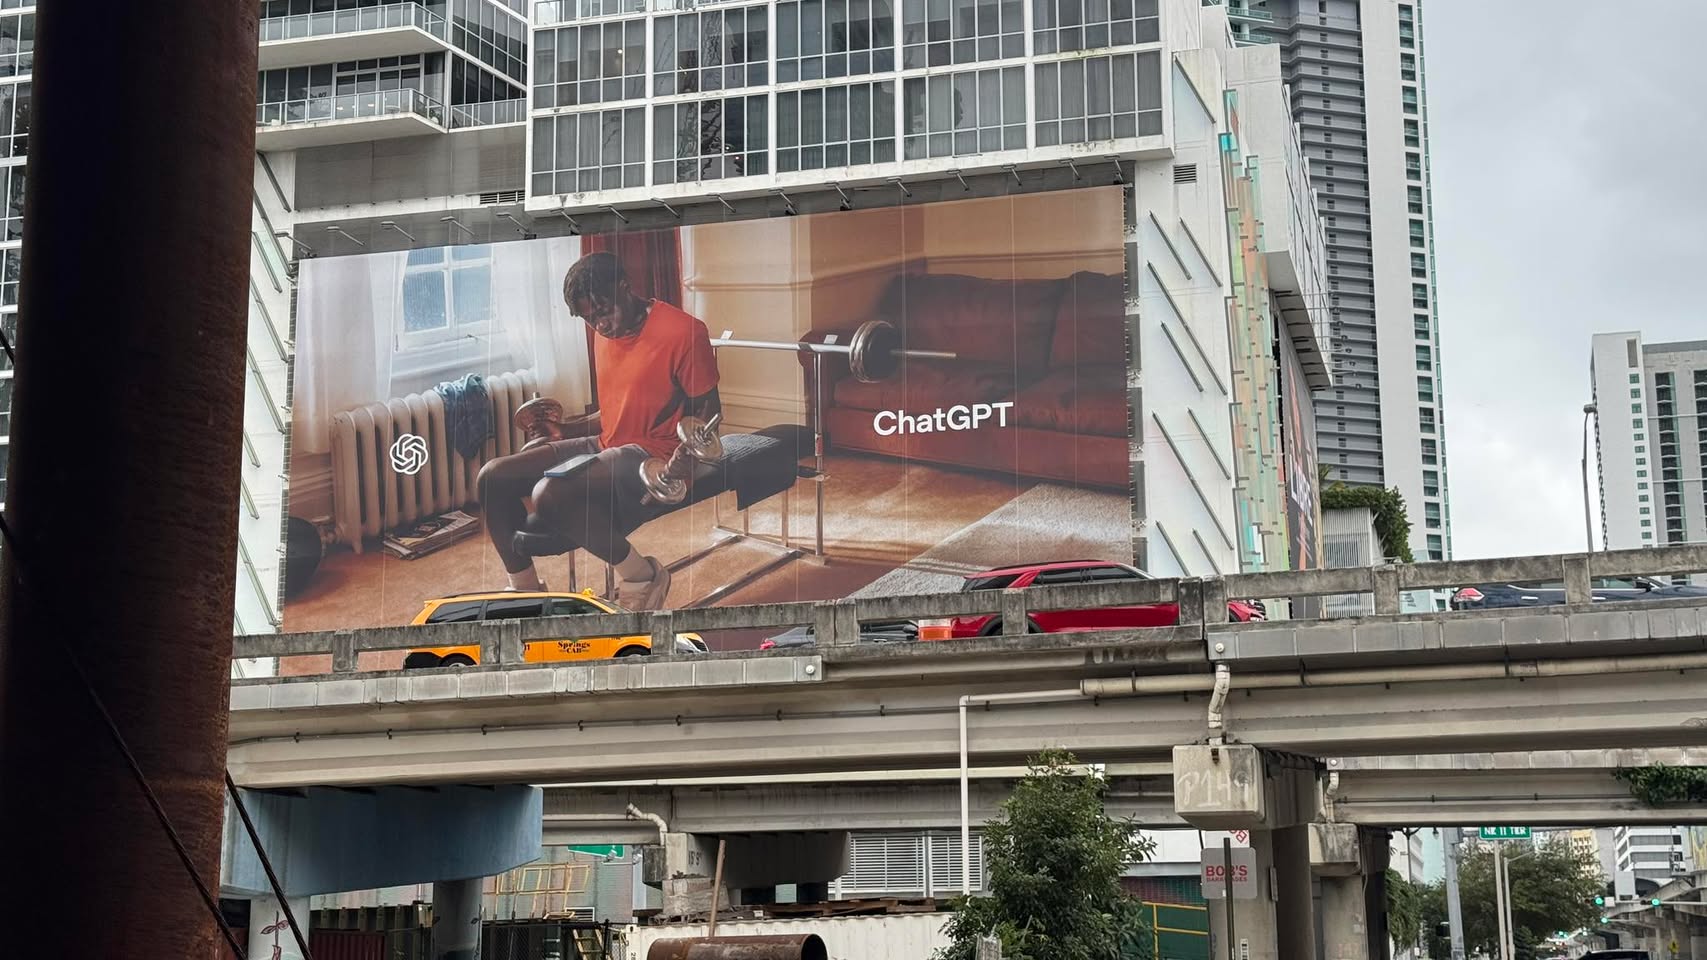
Видимо, рекламу chatgpt сам и делал и размещал (висит в месте, где, кажется , вообще никто не ходит)
Википедия: когда сложность становится барьером | 2025-11-26T01:06:17
У википедии есть одна большая проблема. Ну или у нас с википедией. Если зайти на практически любую страницу википедии об относительно сложном математическом или физическом понятии, часто резко перестает хотеться ее дальше читать. Формально там все верно, но объяснение дается через концепции, часто еще более сложные, чем объясняемая. Кроме этого, там дается часто много лишнего — то, что формально/академически/таксономически находится внутри темы, но по сути «загрязняет» получение первого впечатления.
Эта проблема возникает потому, что у авторов Википедии (часто математиков) приоритет стоит на строгости и полноте, а не на дидактике и понятности.
В англоязычной среде такое иногда называют «Drift into pedantry» (скатывание в педантизм). Статьи часто пишутся экспертами для экспертов, а не для тех, кто пытается изучить предмет с нуля.
Вот возьмем, например, «тензор». Представьте студента, который слышал, что тензоры используются в машинном обучении (Google TensorFlow) или физике, и хочет понять суть.
Чего ждет читатель (интуиция): «Тензор — это таблица чисел (ну или какой-нибудь контейнер данных), которая описывает свойства объекта и правильно изменяется, если мы повернем систему координат»
Что дает википедия: «Те́нзор (от лат. tensus, «напряжённый», по классической раскладке механического напряжения на гранях деформируемого куба, см.иллюстрацию) — раскладка (расположение в пространстве) чисел (компонент), применяемая в математике и физике как особый тип многоиндексного объекта, обладающего математическими свойствами.» Статья сразу же начинает перечислять ранги, ковариантность и контравариантность индексов. Это формально верно, но это «загрязняет» первое впечатление.
Иллюстрация в самом верху подписана вот так: «Механическое напряжение, деформирующее куб с гранями, перпендикулярными осям координат, в классической теории упругости описывается тензором напряжений Коши (англ. Cauchy stress tensor), который связывает 2 индекса: вектор нормали к грани с вектором напряжения Т (сила на единицу площади); имеются 3 направления нормалей и 3 направления компонент напряжения, что даёт тензор 2-го ранга 3×3 — из 9 компонент.»
Формально — ни одной ошибки. Фактически — это стена текста, которая требует знания линейной алгебры, чтобы просто прочитать определение.
Это как если бы вы спросили «Что такое яблоко?», а вам ответили: «Яблоко — это плод растений подсемейства Сливовые (Amygdaloideae) или Спирейные, обладающий эпикарпием, мезокарпием и эндокарпием, часто участвующий в гравитационных экспериментах Ньютона».
С одной стороны, кажется, что с появлением LLM википедия как бы больше не необходима. Есть же условно LLMы типа ChatGPT, которые по сути пересказывают все то, что есть в wikipedia в нужном виде. Но они так делают, потому что их обучили на википедии, причем наверняка именно википедии дали сильно больше веса при обучении, чем всякому шлаку в интернете. Если бы не было википедии в обучающем сете, все было бы сильно сложнее. При этом википедия постоянно редактируется, и LLM и Google используют именно ее при ответах на вопросы.
Поэтому, с одной стороны, мне кажется, что википедии давно пора переходить на генерацию на основе курируемых экспертами данных и упаковывать знания в требуемом формате, например, в виде вопросов-ответов. С другой, теряется вся идея мастер-данных энциклопедии для LLM/RAG.
Парадокс в том, что LLM — это, по сути, единственный «интерфейс», который смог прочитать эти педантичные определения Википедии, «понять» их (через тысячи примеров кода и статей) и перевести обратно на человеческий язык. Википедия стала отличной базой данных для роботов, но плохим учебником для людей.
Как странное превью заставило меня кликнуть на рекламу | 2025-11-21T21:51:31
Фейсбук мне и показывает рекламу (в данном случае — жилет) и периодически выбирает очень «удачные» места для стопкадра, выполняющего роль превью видео в ленте. Но, надо сказать, добивается своего и я нажимаю, чтобы посмотреть, что это за жесть такая.

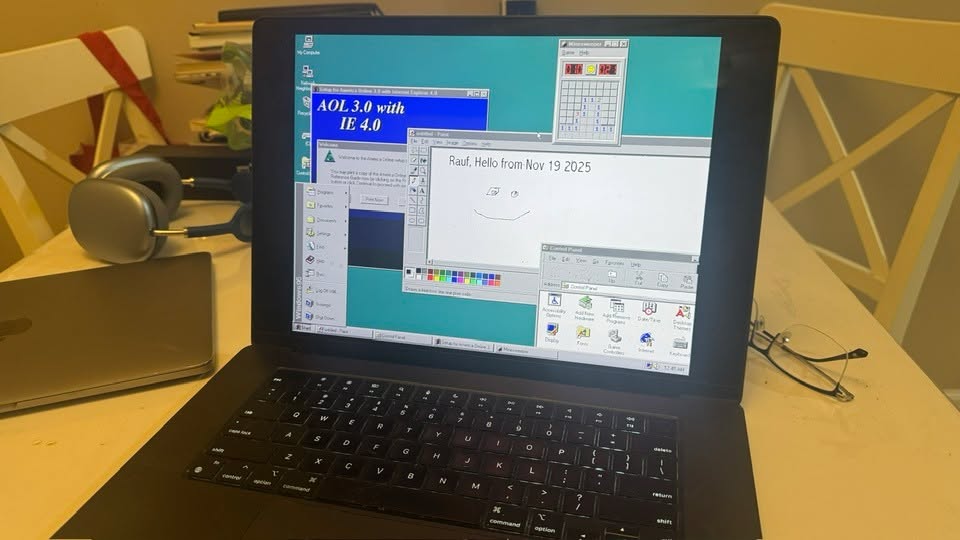
Ностальгия online: Windows 95 в вашем браузере | 2025-11-19T23:38:34
Какая прелесть, Windows 95 в браузере copy.sh/v86.
Сбой системы: как Cloudflare справится без Stack Overflow и ChatGPT? | 2025-11-18T14:35:15
Cloudflare сломался. Товарищ очень правильный вопрос задал
Алхимия данных: размышления об алгоритмах RecSys | 2025-11-16T04:02:08
Заумный пост сегодня. Пока писал книгу по RecSys, поймал себя на мысли, что современный data science — это, по сути, алхимия 21 века. За половиной «лучших практик» в алгоритмах нет хорошего математического аппарата. Это набор эвристик, которые «просто работают». Причем как в 17 веке смешивали все подряд, так и сейчас смешивают, и если что-то сработало лучше, все остальные начинают делать так же. Ответа на вопрос «почему» просто нет.
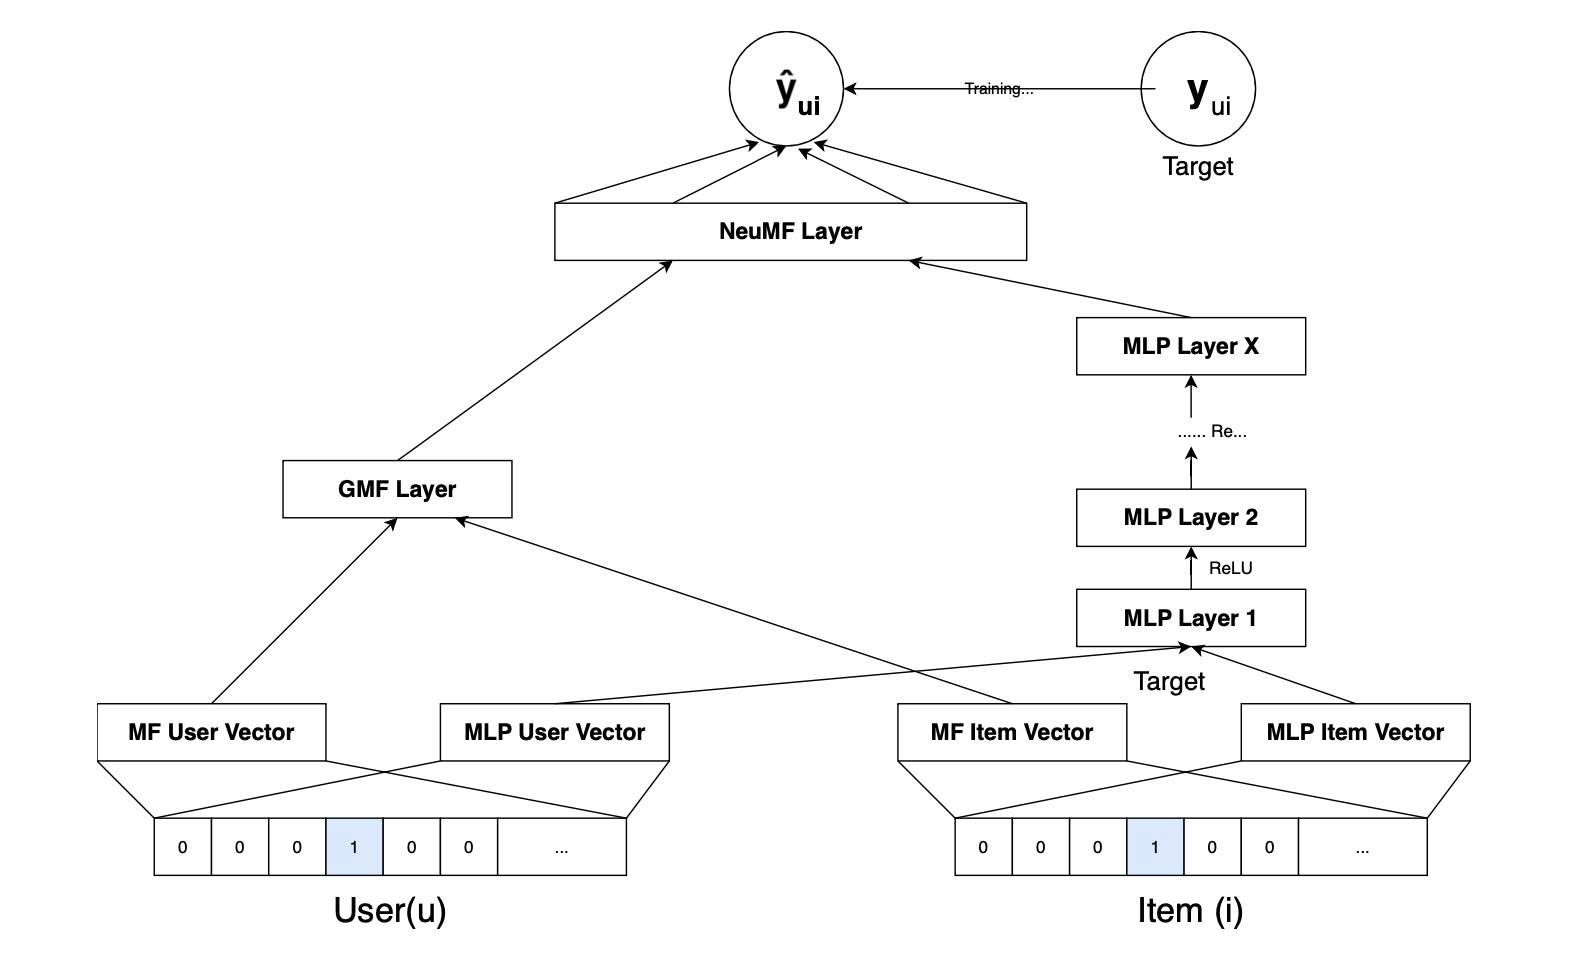
Возьмем, к примеру, алгоритм NCF/NeuMF (Neural Collaborative Filtering). Там такая логика. Есть, скажем, миллион оценок пользователями фильмов. И 100 миллионов оценок пользователями еще на даны — пользователи ж не могут посмотреть все фильмы на свете. Но из этих 100 миллионов для конкретного пользователя надо выбрать кандидатов для рекламы. У алгоритма, конечно, есть фаза тренировки, когда рассчитываются веса, и стадия предсказания, когда эти веса используются на входящих данных.
(Что делает алгоритм. Там по сути ансамбль из три подалгоритмов, два из которых генерят каждый свое заключение, а потом их решения поступают на новую нейронку, третий алгоритм, который дает финальную рекомендацию. По-умному это гибрид GMF (матричная факторизация) и MLP (многослойный персептрон) Первый из этих двух основан на разложении матриц, а второй представляет собой нейронную сеть из нескольких слоев. На тренировочных данных подбираются веса.)
На один позитивный пример он берет 4 негативных. Потому четыре? Да просто это «не много и не мало». Будет ли 8 лучше? Неизвестно, но учиться будет точно дольше.
Почему размерность эмбеддингов 32? или 64? Нет никакой формулы. Это «золотая середина» между «тупой» моделью (мало k) и «переобученной» (много k).
Теперь про нейронку. Почему MLP-блок строят «башней» (64 -> 32 -> 16)? Почему не (50 -> 25 -> 10)? Почему между ними ReLU (а не tanh например)? Чистая эмпирика. Число слоев в башне тоже подбирается.
Почему у GMF и MLP-частей разные эмбединги на входе? Потому что авторы статьи попробовали, и так «получилось лучше». Мат. доказательства нет. Почему на финальный слой они идут с равными весами? Потому что потому.
Почему выходы двух путей «склеиваются» (concat), а не складываются или перемножаются? «Опыт показал, что так результат точнее».
И так во всем, вплоть до выбора оптимизатора Adam или «магического» learning_rate=0.001, хотя с этими по крайней мере понятен матаппарат.
То есть, у одного алгоритма как минимум с десяток параметров подобрано эмпирически, при этом однозначной уверенности, что они независимые друг от друга — нет. Зато многие из них зависят от датасета, но никто не знает как 😉
В общем, алхимия.
Интерактивная визуализация алгоритмов рекомендаций в новом open source приложении | 2025-11-11T05:23:46
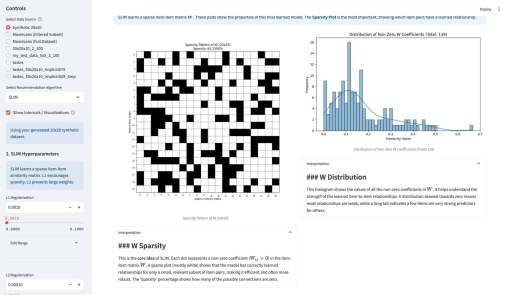
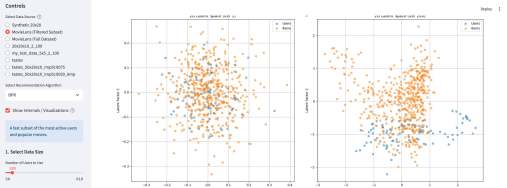
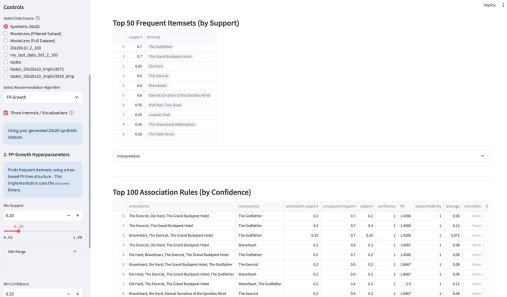
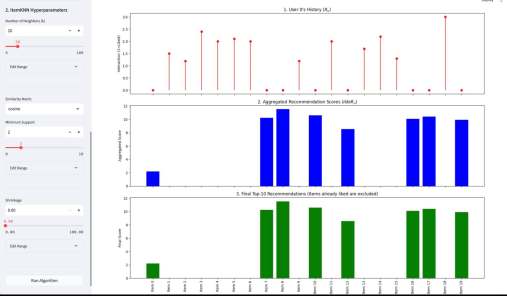
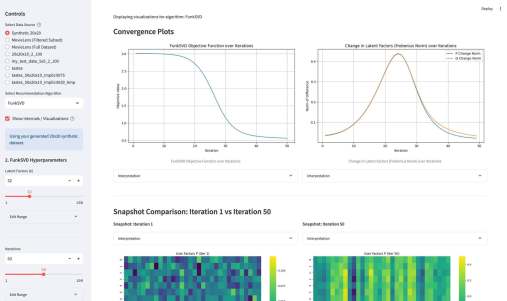
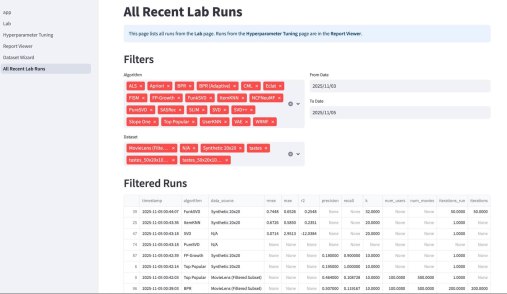
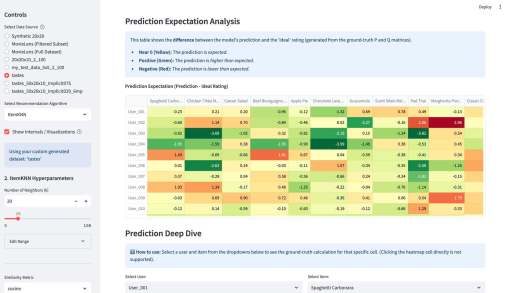
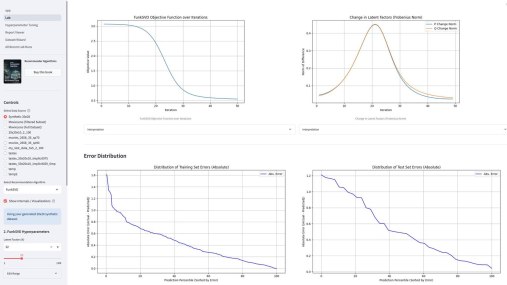
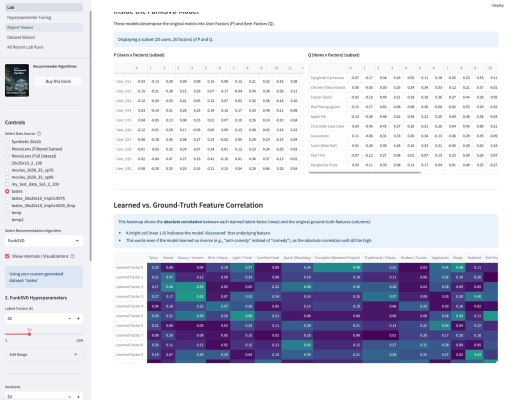
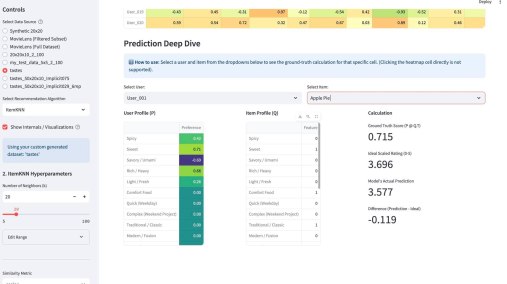
У меня вышло электронное open source приложение к моей книжке Recommender Algorithms! Это «песочница», где можно «погонять» различные алгоритмы рекомендаций с разными настройками, и по каждому алгоритму посмотреть специфичную ему визуализацию, помогающую понять как он работает. Например, для таких алгоритмов как ItemKNN, SLIM или EASE ключевой визуализацией является heatmap, выученной матрицы схожести (item-item similarity matrix). Это позволяет увидеть, какие именно пары товаров модель считает «похожими» (или «влияющими» друг на друга). Для SLIM, например, полезна «Sparsity Plot» , показывающая, что матрица схожести действительно получилась разреженной. Для алгоритмов ассоциативных правил (Apriori, FP-Growth, Eclat) визуализация — это вообще не график, а интерактивные таблицы с найденными «Частотными наборами» (Frequent Itemsets) и сгенерированными «Правилами» (Association Rules) , которые можно фильтровать и сортировать.
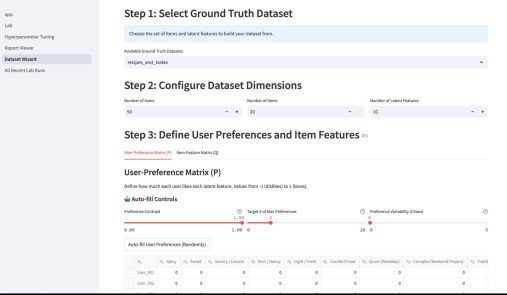
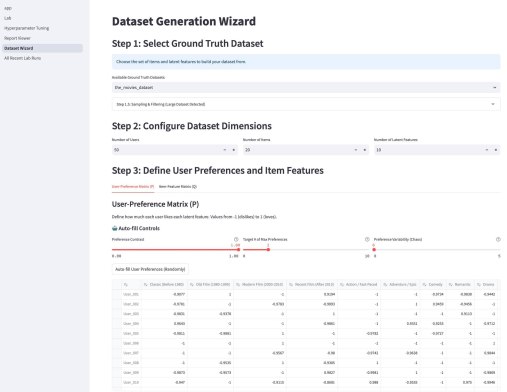
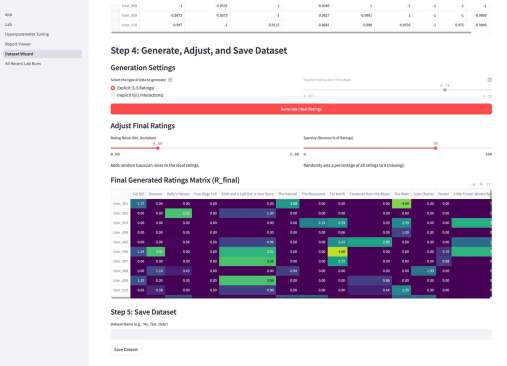
Кроме этого, там есть параметрический механизм создания «игрового датасета» — Dataset Wizard. Работает он так — есть шаблонные датасеты, которые описывают items через характеристики. Например, рецепты через вкусы. Или фильмы через жанры. Система генерирует случайных пользователей со случайным набором характеристик из того же набора — причем там много ползунков, позволяющих это распределение сделать более контрастным или сложным. Далее создается уже матрица оценок пользователями айтемов — условно если совпадают характеристики пользователя и айтема, то оценка будет выше, так как «совпадают вкусы» и наоборот, если различаются, то оценка будет ниже. Тут тоже ползунки, добавляющие шум и scarcity — рандомно удаляется часть матрицы. На вход алгоритму рекомендаций характеристики товаров и пользователей не подаются, они скрыты, но они используются для визуализации результатов.
Третьим компонентом приложения является подбор гиперпараметров. По сути, это автоконфигуратор под конкретный датасет. Там используется итеративный подход, который намного эффективнее, чем полный перебор (Grid Search) или случайный поиск (Random Search). Если говорить кратко, система анализирует историю прошлых запусков (trials) и строит вероятностную «карту» (суррогатную модель) того, какие параметры, скорее всего, дадут лучший результат. Затем она использует эту карту, чтобы по-умному выбрать следующую комбинацию для проверки. Этот метод называется Последовательная оптимизация на основе суррогатных моделей (SMBO).
Код свободный, будет еще дополняться новыми алгоритмами и новыми визуализациями.
Ссылочка на код в комментариях.
Ссылочка на сайтик, где код развернут и где можно посмотреть на приложение, тоже в комментариях.
 Being in America
