Математические нотации: хаос под строгим порядком | 2025-12-02T15:30:20

Если вам кто-то говорит, что математика это точная наука — не верьте. Поскольку у меня сейчас хобби data science, я изучаю всякое разное из разных книжек и у меня взрывается мозг, как вообще может такое происходить в науке, где каждая мелочь должна укладываться в систему, иначе она идет лесом. Пока дело не доходит до нотаций. С ними там какой-то дикий бардак. Набор диалектов.

Взять, например, обычные логарифмы. «Стандарт» как обозначать логарифм зависит от того, в какой комнате университета вы находитесь. В матанализе и теории чисел log(x) почти всегда означает натуральный логарифм ln(x) база e. Производная от e^x равна e^x. Это «естественно». Писать ln им лень. Там, же где могут вылезти дясятичные логарифмы (computer science тот же), log(x) внезапно становится десятичным, а ln(x) — по основанию e.

Матожидание E имеет аргумент в квадратных скобках. При этом те же квадратные скобки в computer science используются для степ-фукции 0/1.

Или вот если вы видите вектор — это столбец или строка? В классической математике вектор — это всегда столбец. Чтобы умножить его на веса, мы пишем T после вектора и потом w для весов. Но во многих пейперов векторы мыслятся как строки. И если вы видите y = xW+b , то x — это не столбец, потому что иначе размерности не сойдутся. x тут — строка. но в следующей статье пишут Wx+b. И тут x — столбец 🙂

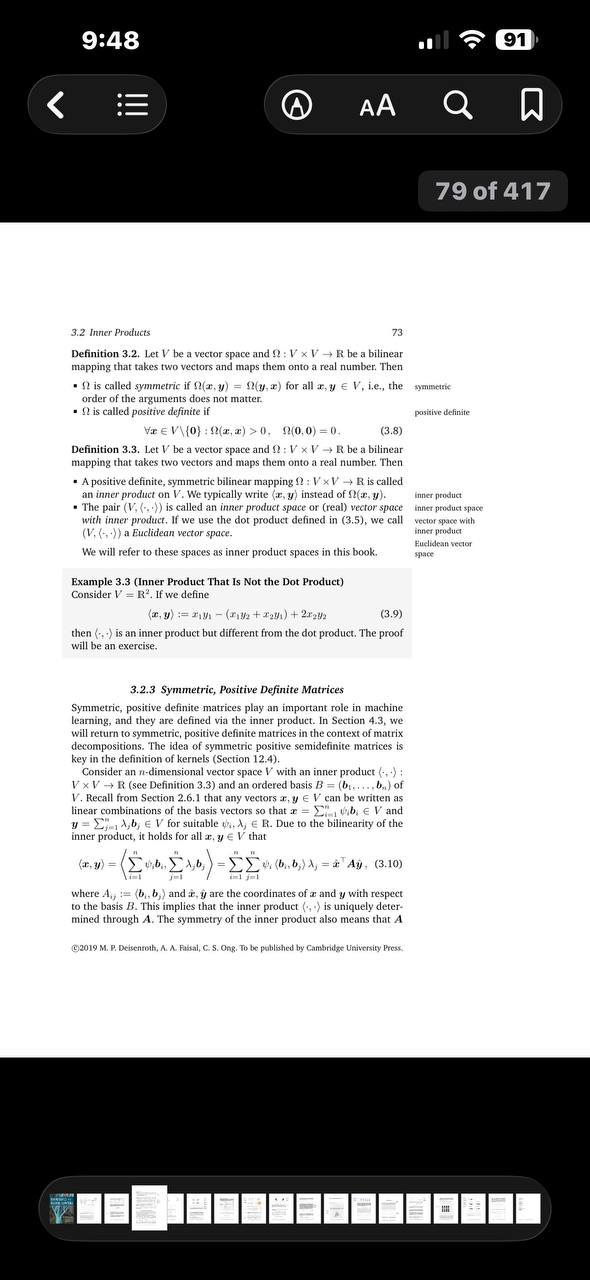
Угловые скобки . Для скалярного произведения (dot product) используется знак «⋅», но его плохо видно, особенно на доске, и я очень часто вижу, что математики используют угловые для dot product. Вообще по науке угловые используются для обобщенного (generalized) понятия inner product, где скалярное произведение частный случай. означает некий абстрактный способ перемножить a и b и получить число. Причем в квантовой механике это бы записывалось как . А еще для скалярного произведения некоторые используют кружок с точкой или x в кружочке.

Ну и для кучи еще в России тангенс — это tg, а в США — tan. А есть еще tan^-1 и arctan, что одно и то же, хотя x^-1 вообще означает 1/x
Создание приложения для изучения языка в полёте | 2025-12-01T15:45:11

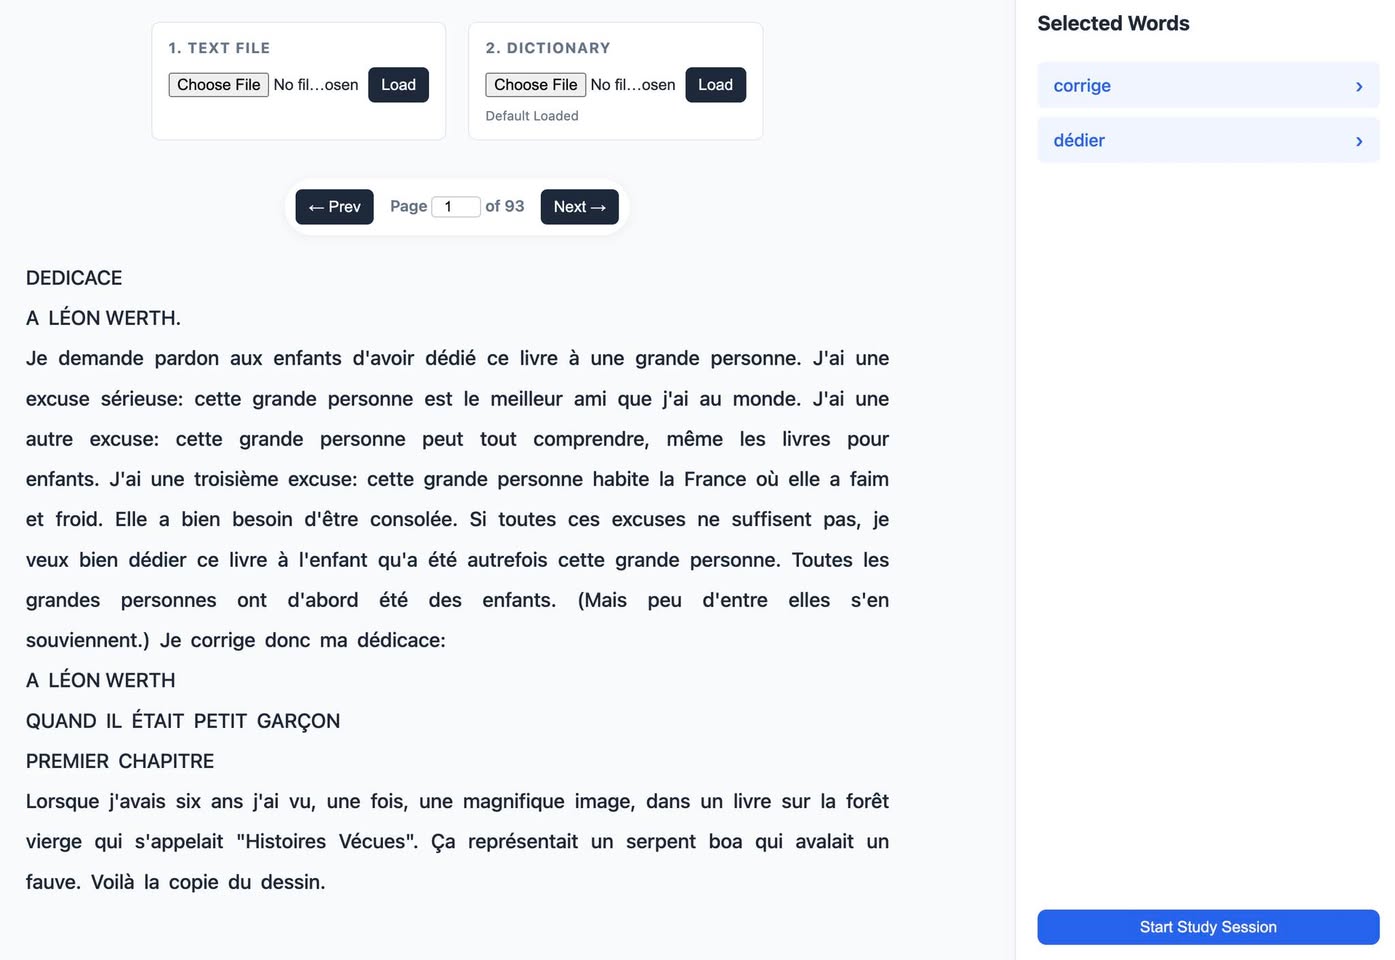
Кстати, вчера утром, пока ждал у выхода на посадку в Майами, я быстро с помощью Gemini написал приложение для изучения французского языка по идее, которую набросал товарищу, пока ехал в аэропорт, а потом в полёте использовал это приложение.

Идея в том, что в незнакомом тексте на иностранном языке пользователь сначала помечает незнакомые слова, а затем видит их переводы — но без оригинального текста, а потом возвращается к самому тексту — но уже не видя переводов. То есть, это как если бы «словарь был в соседней комнате». Гипотеза, что такой метод помогает лучше запоминать, чем когда перевод показывается сразу при клике на слово, и когда не надо прилагать усилия.

Приятно, что создание приложения с нуля до готового варианта заняло всего около 35-40 минут, а потом я еще какое-то время пользовался им в полёте, без интернета. Так как все переводы всех слов/фраз уже сделались заранее.

Только что развернул его на Render. Тоже приятно, что показать код в работе бесплатно и заняло еще минут 10.

https://readandlearn.onrender.com/

Белый налёт: когда все Tesla одного цвета | 2025-12-01T14:15:40

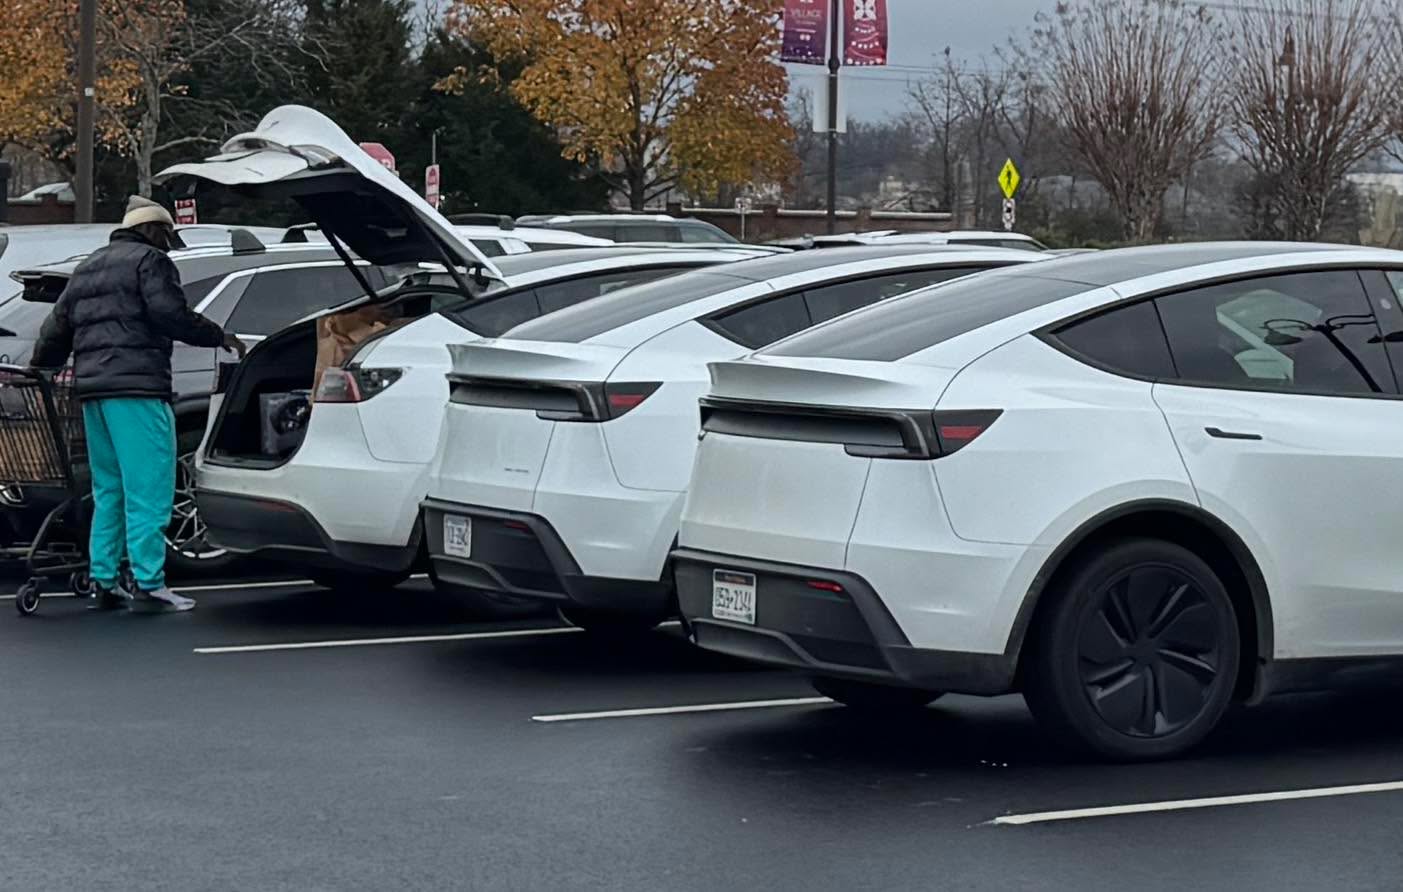
Приезжаю в магазин, и создаётся впечатление, что у меня просто дефолтная белая машина

Превосходная мощь NVIDIA RTX 5090: архитектурные горизонты и digital art | 2025-12-01T01:39:52

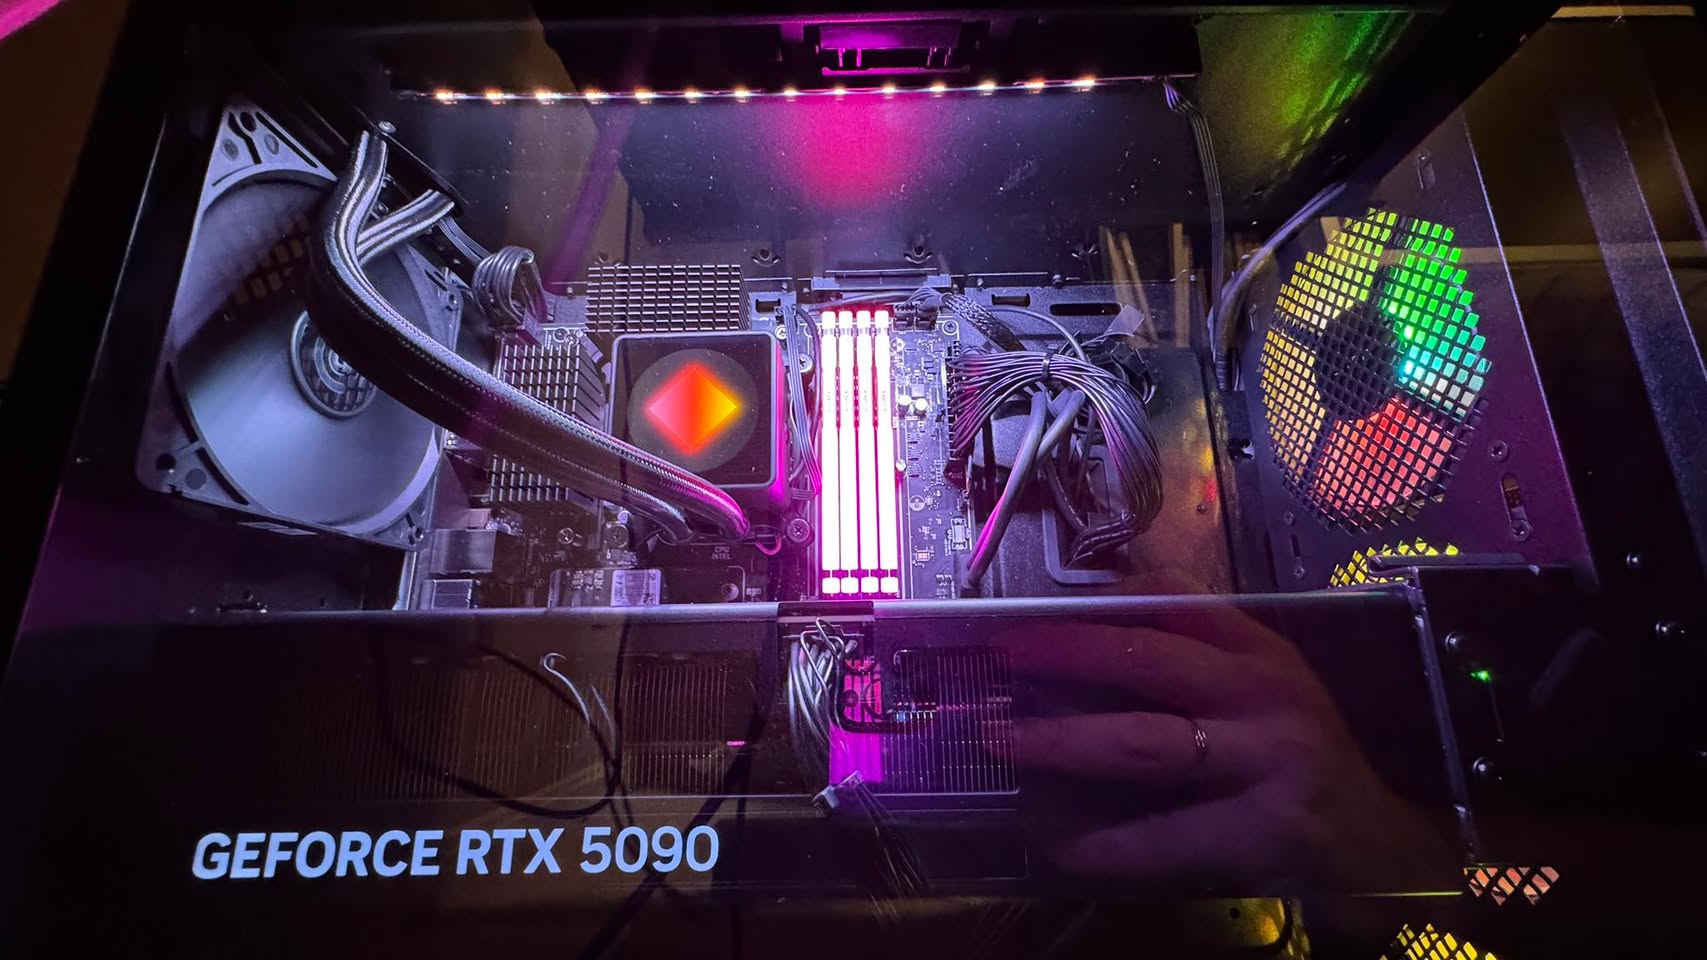
Nvidia RTX 5090 32Gb! довольный как слон. Поставил ArchLinux и CUDA. Планирую скоро поумнеть в теме прокачки трансформерных глубоких нейросеток и есть масса идей по digital art на иных идеях, чем диффузионные модели.

Производительность: Запустил сейчас тест, модель GPT_OSS_20b_UD_Q4_K_XL при контексте 131072 токенов генерит 350 токенов в секунду. То есть это условно страницу А4 за несколько секунд. Gemma3 27B — 55 токенов в секунду. Qwen3_30B_A3B_Q6_K — 259 токенов в секунду.

Яхты техномагнатов: Moonrise и Dragonfly в порту | 2025-11-29T18:14:41

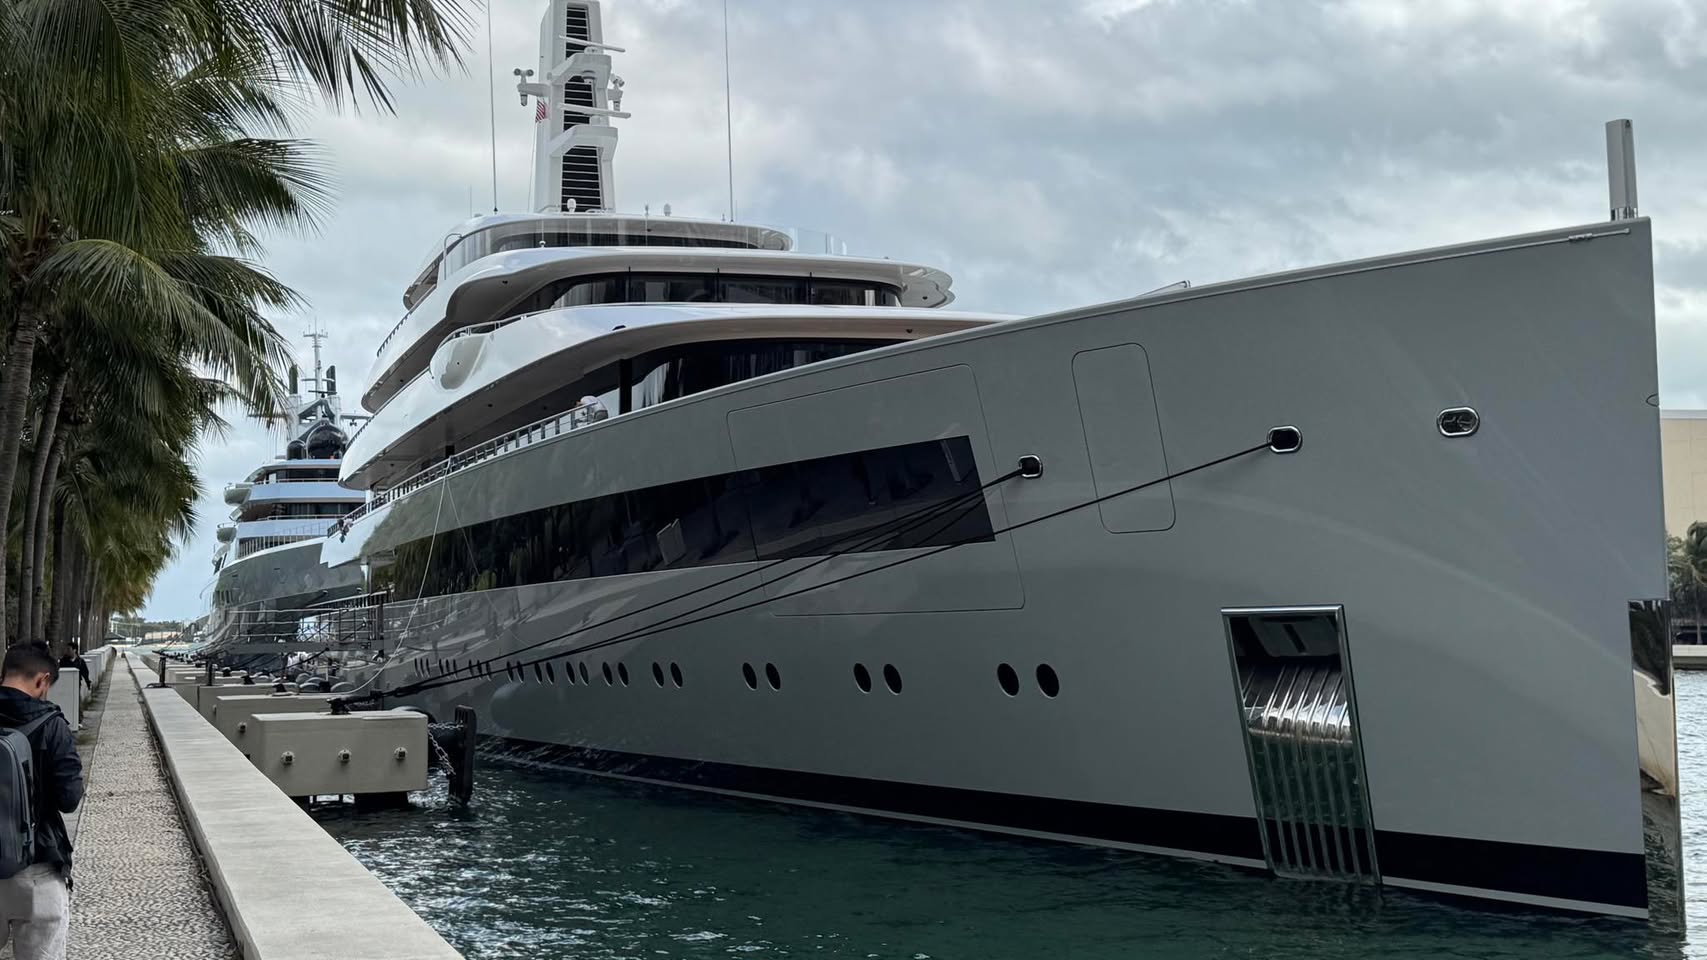
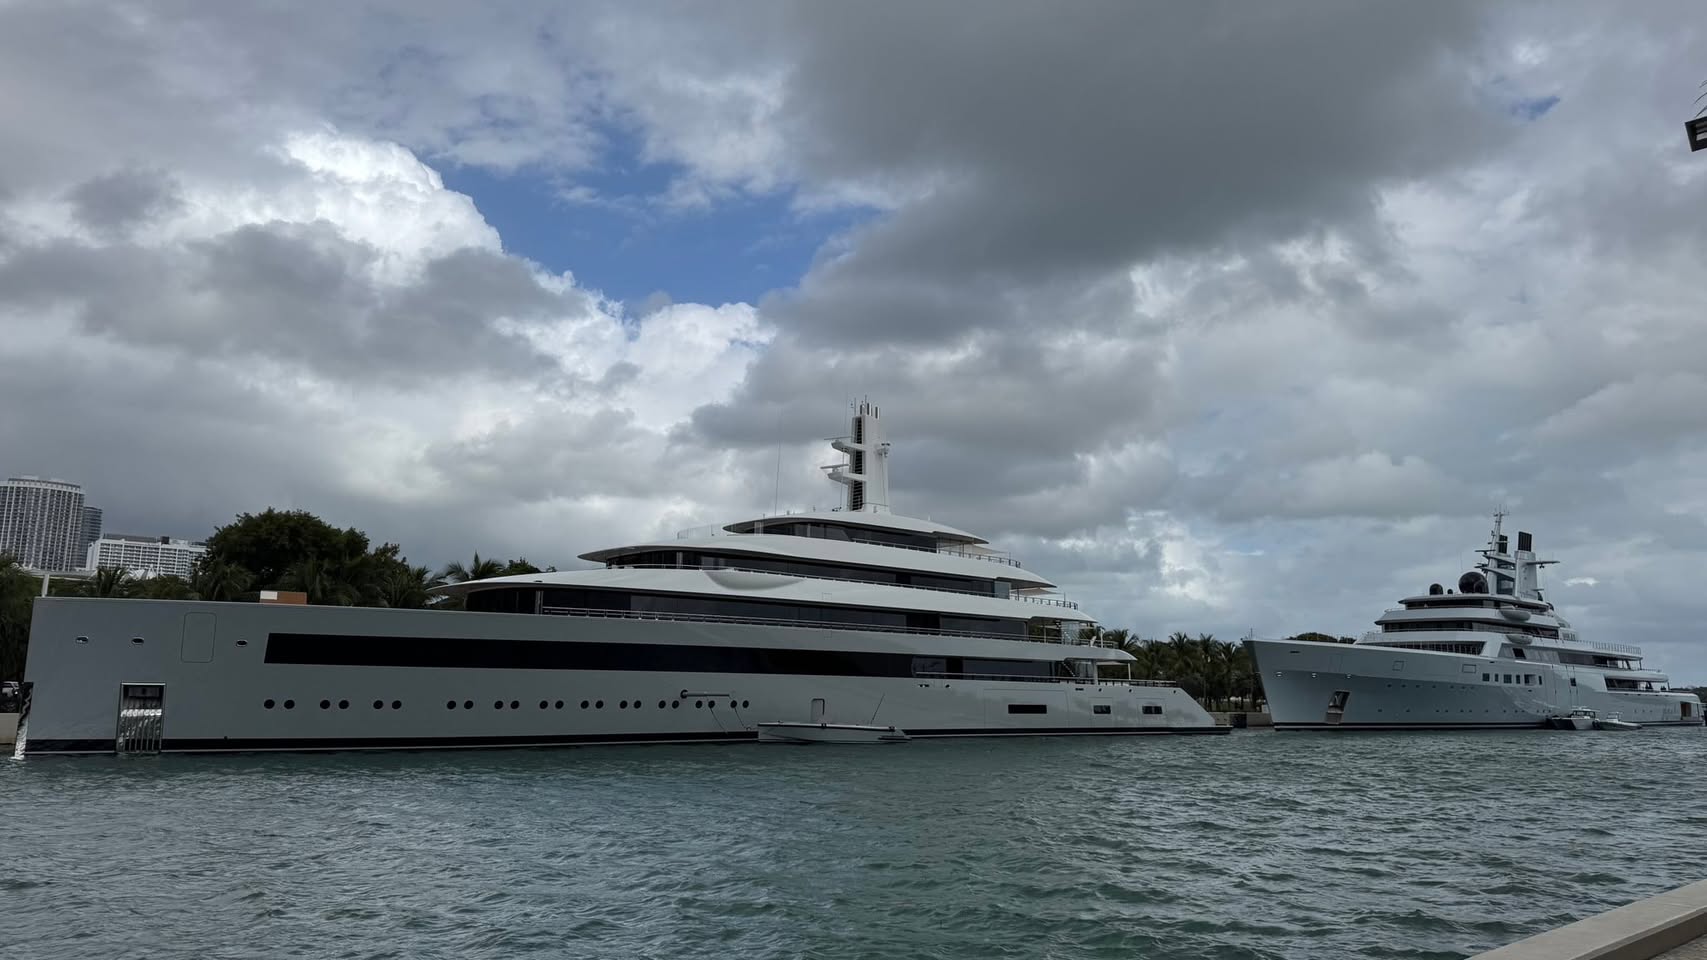
Две яхты подряд стоят — первая, Moonrise, принадлежит основателю WhatsApp Ян Куму, вторая — яхта Dragonfly — принадлежит Сергею Брину, основателю Google.

Рекламный парадокс ChatGPT | 2025-11-29T15:52:07

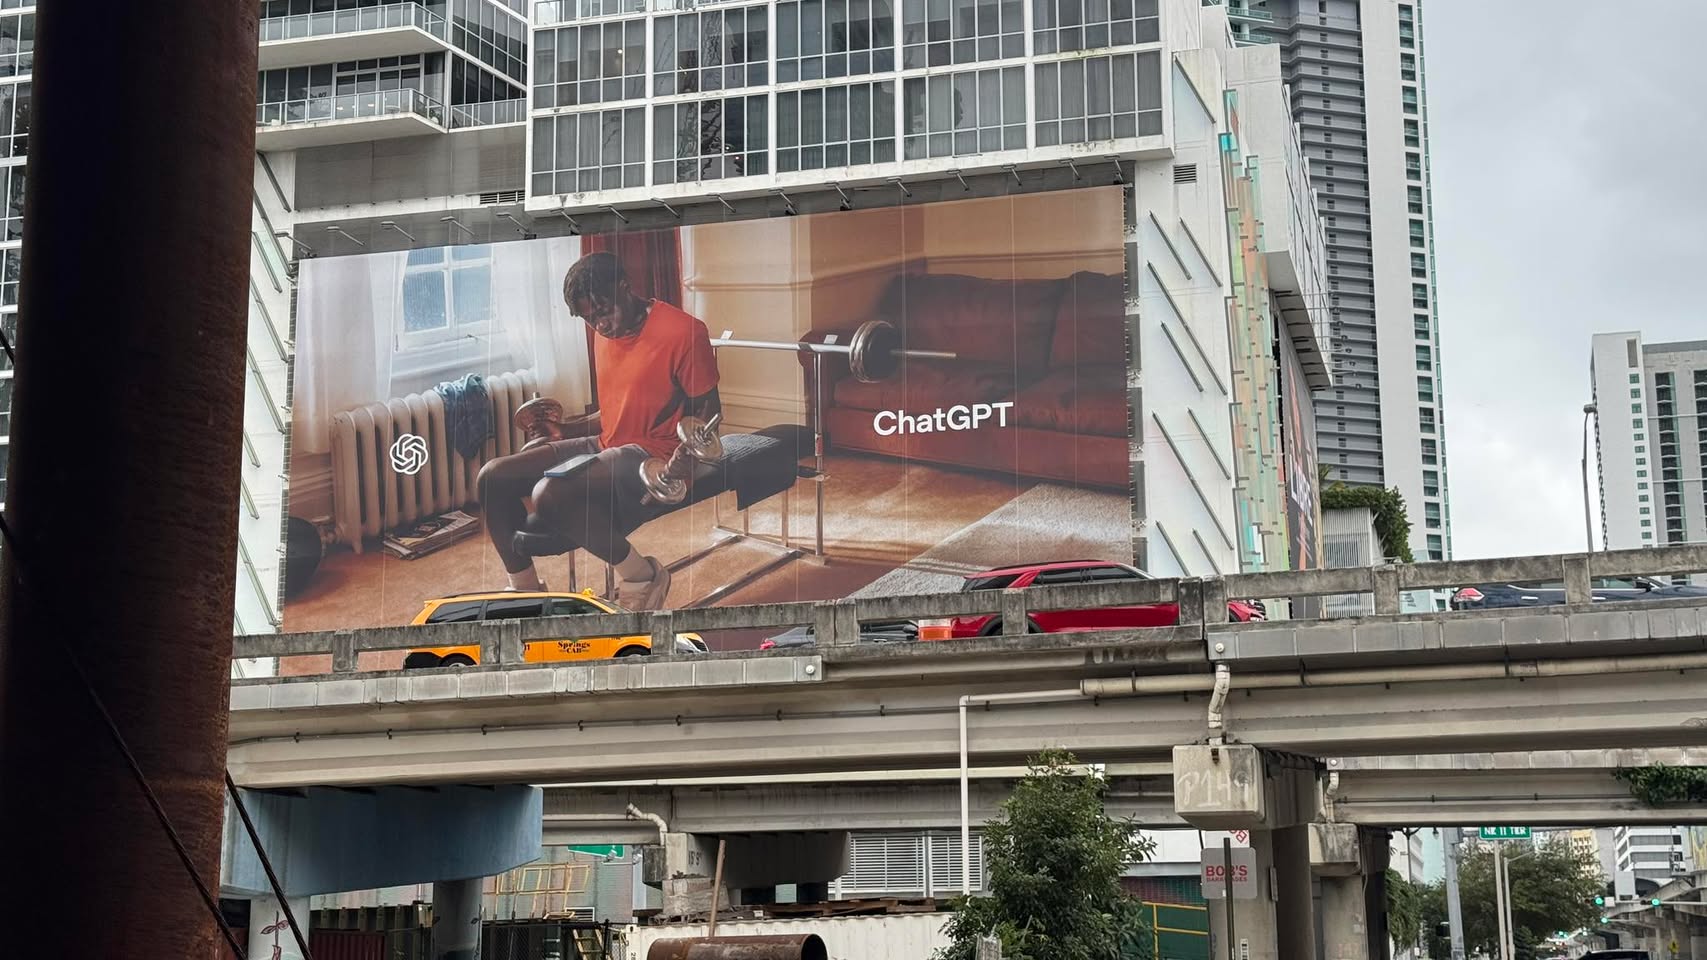
Видимо, рекламу chatgpt сам и делал и размещал (висит в месте, где, кажется , вообще никто не ходит)

Знаки времени: ирония безопасности на улицах Майами | 2025-11-28T21:05:54

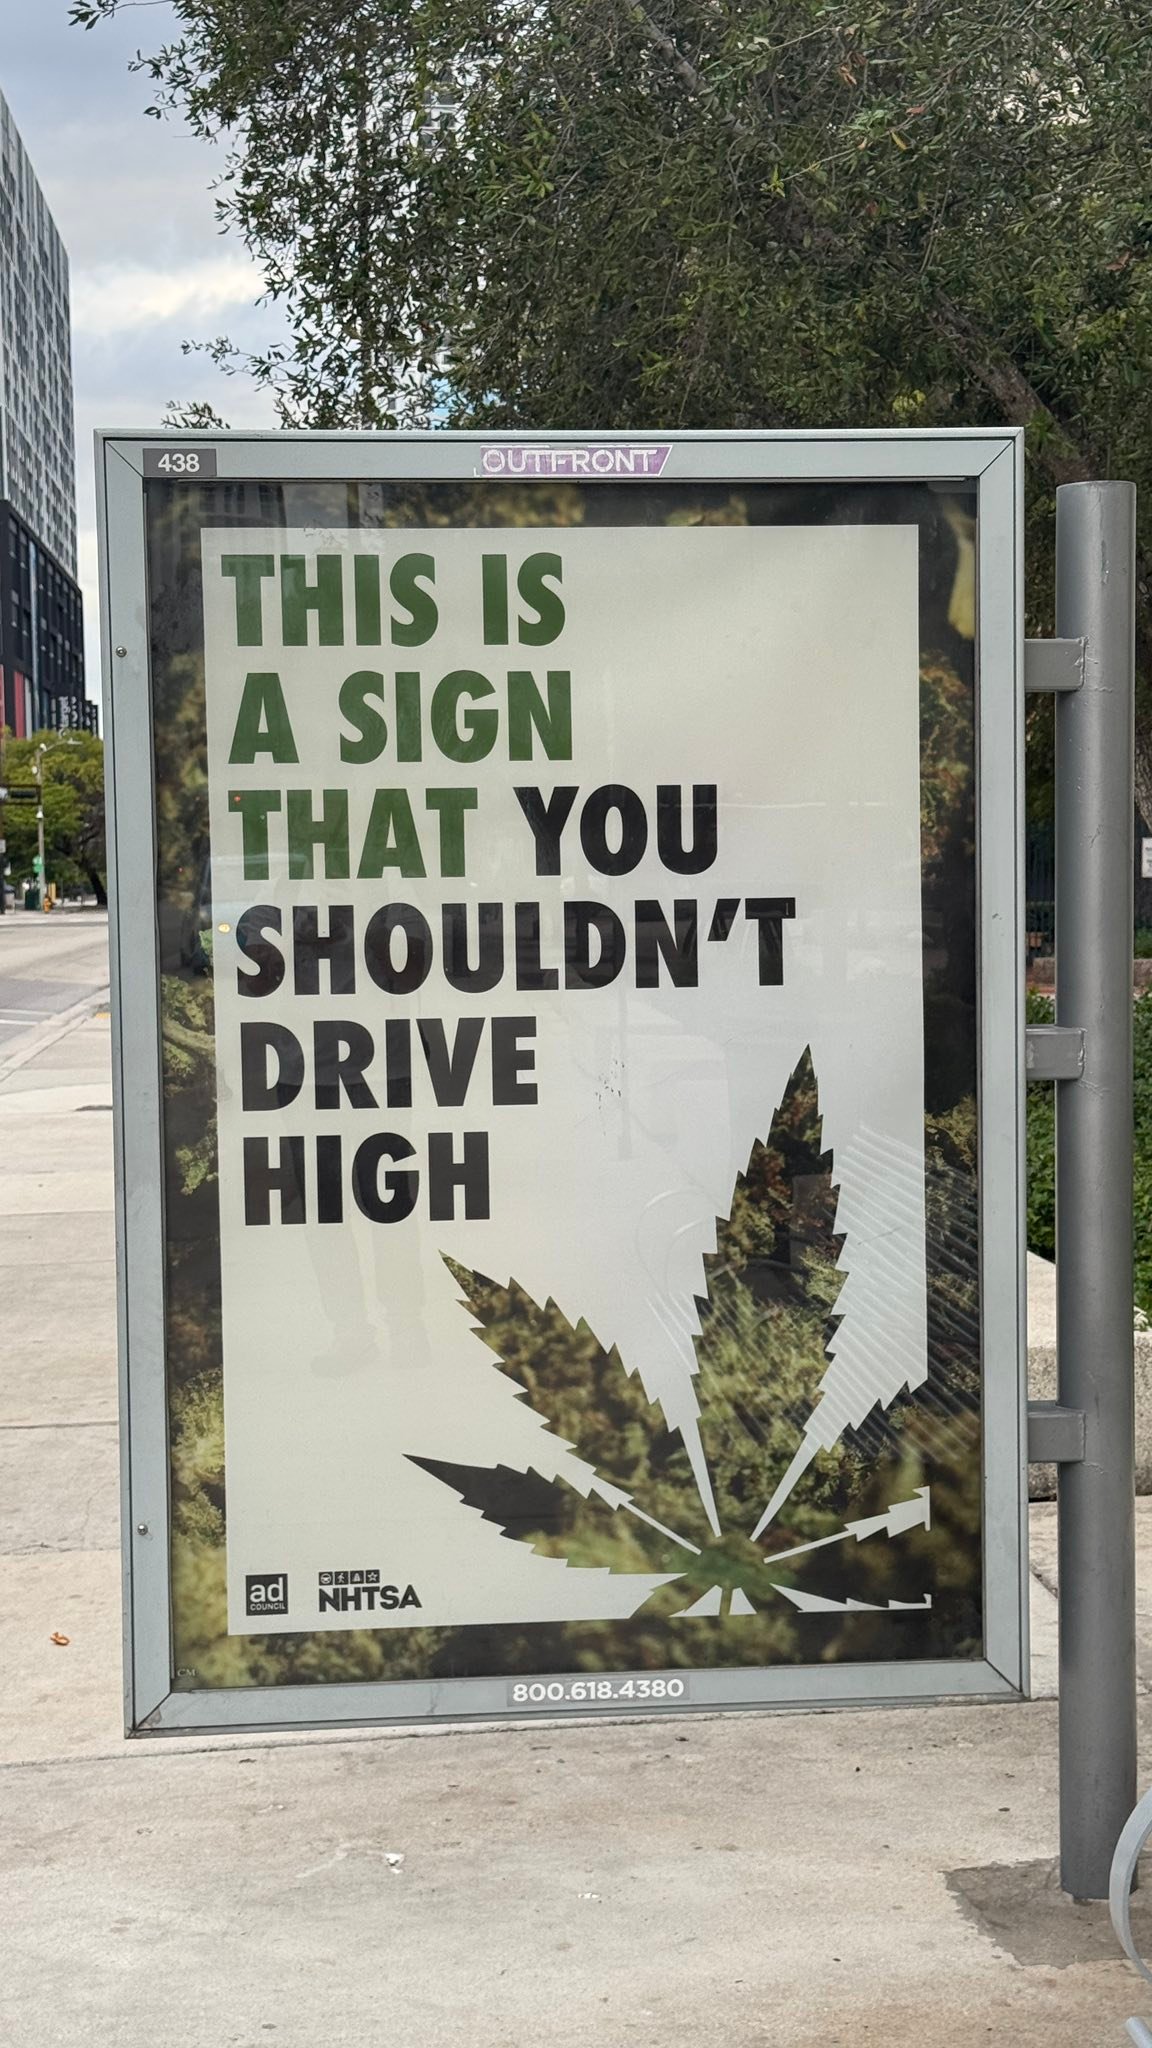
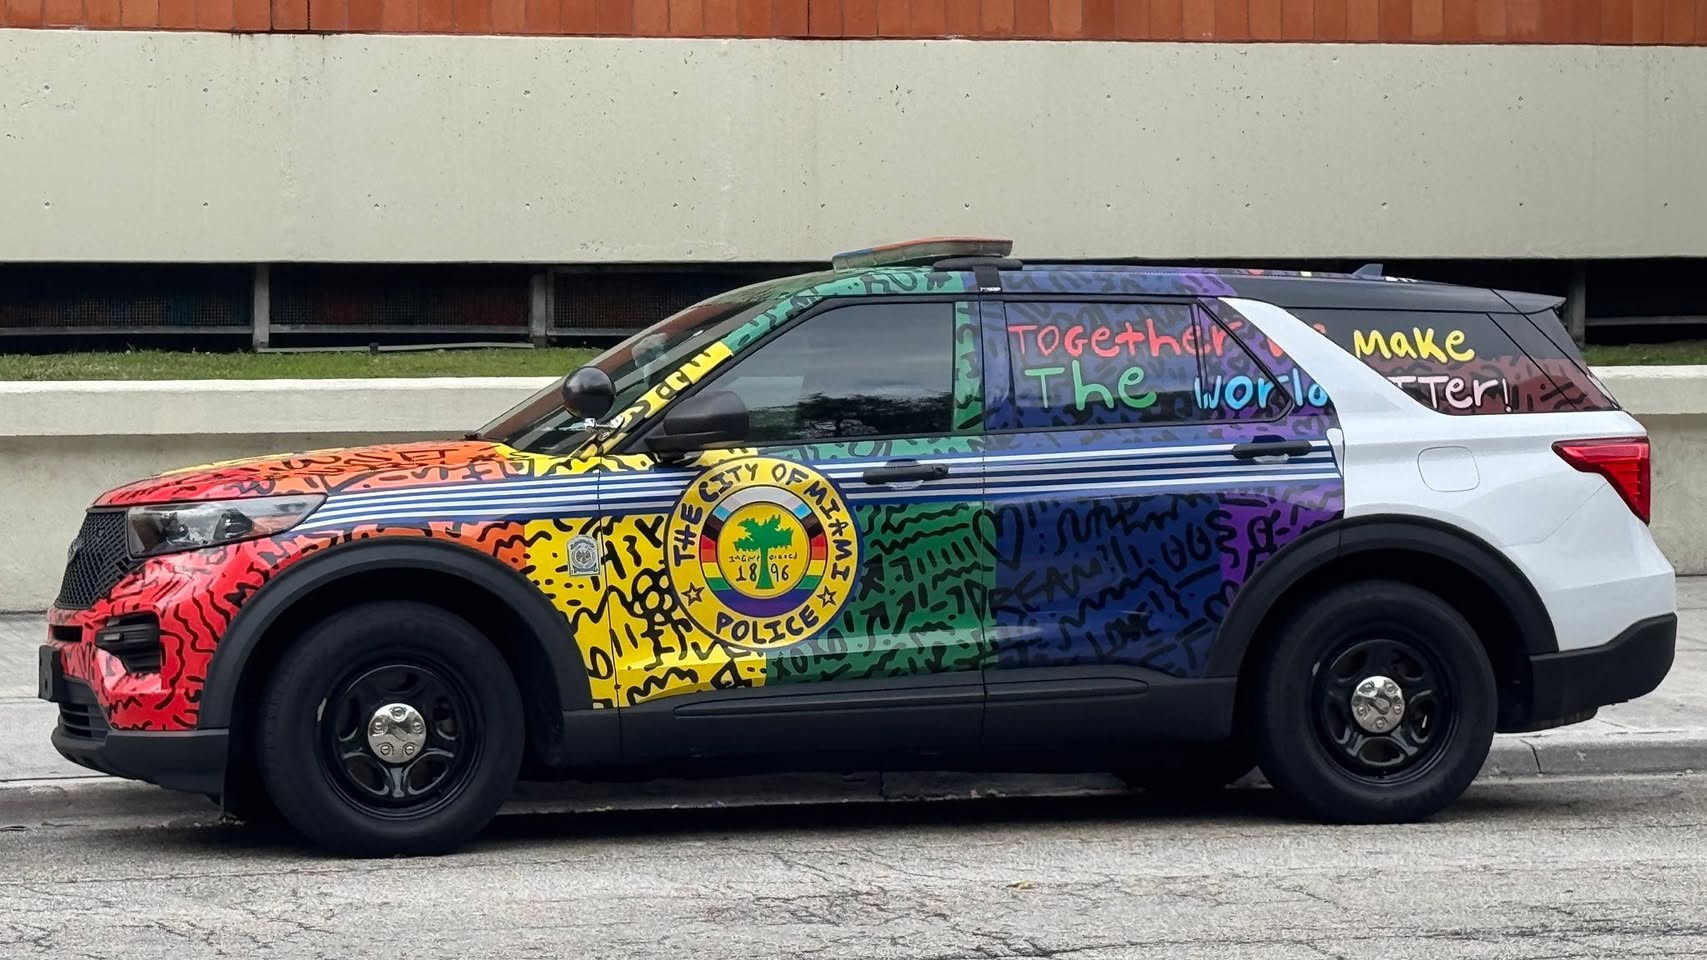
Полиция Маями и знак рядом с ней

Википедия: когда сложность становится барьером | 2025-11-26T01:06:17

У википедии есть одна большая проблема. Ну или у нас с википедией. Если зайти на практически любую страницу википедии об относительно сложном математическом или физическом понятии, часто резко перестает хотеться ее дальше читать. Формально там все верно, но объяснение дается через концепции, часто еще более сложные, чем объясняемая. Кроме этого, там дается часто много лишнего — то, что формально/академически/таксономически находится внутри темы, но по сути «загрязняет» получение первого впечатления.

Эта проблема возникает потому, что у авторов Википедии (часто математиков) приоритет стоит на строгости и полноте, а не на дидактике и понятности.

В англоязычной среде такое иногда называют «Drift into pedantry» (скатывание в педантизм). Статьи часто пишутся экспертами для экспертов, а не для тех, кто пытается изучить предмет с нуля.

Вот возьмем, например, «тензор». Представьте студента, который слышал, что тензоры используются в машинном обучении (Google TensorFlow) или физике, и хочет понять суть.

Чего ждет читатель (интуиция): «Тензор — это таблица чисел (ну или какой-нибудь контейнер данных), которая описывает свойства объекта и правильно изменяется, если мы повернем систему координат»

Что дает википедия: «Те́нзор (от лат. tensus, «напряжённый», по классической раскладке механического напряжения на гранях деформируемого куба, см.иллюстрацию) — раскладка (расположение в пространстве) чисел (компонент), применяемая в математике и физике как особый тип многоиндексного объекта, обладающего математическими свойствами.» Статья сразу же начинает перечислять ранги, ковариантность и контравариантность индексов. Это формально верно, но это «загрязняет» первое впечатление.

Иллюстрация в самом верху подписана вот так: «Механическое напряжение, деформирующее куб с гранями, перпендикулярными осям координат, в классической теории упругости описывается тензором напряжений Коши (англ. Cauchy stress tensor), который связывает 2 индекса: вектор нормали к грани с вектором напряжения Т (сила на единицу площади); имеются 3 направления нормалей и 3 направления компонент напряжения, что даёт тензор 2-го ранга 3×3 — из 9 компонент.»

Формально — ни одной ошибки. Фактически — это стена текста, которая требует знания линейной алгебры, чтобы просто прочитать определение.

Это как если бы вы спросили «Что такое яблоко?», а вам ответили: «Яблоко — это плод растений подсемейства Сливовые (Amygdaloideae) или Спирейные, обладающий эпикарпием, мезокарпием и эндокарпием, часто участвующий в гравитационных экспериментах Ньютона».

С одной стороны, кажется, что с появлением LLM википедия как бы больше не необходима. Есть же условно LLMы типа ChatGPT, которые по сути пересказывают все то, что есть в wikipedia в нужном виде. Но они так делают, потому что их обучили на википедии, причем наверняка именно википедии дали сильно больше веса при обучении, чем всякому шлаку в интернете. Если бы не было википедии в обучающем сете, все было бы сильно сложнее. При этом википедия постоянно редактируется, и LLM и Google используют именно ее при ответах на вопросы.

Поэтому, с одной стороны, мне кажется, что википедии давно пора переходить на генерацию на основе курируемых экспертами данных и упаковывать знания в требуемом формате, например, в виде вопросов-ответов. С другой, теряется вся идея мастер-данных энциклопедии для LLM/RAG.

Парадокс в том, что LLM — это, по сути, единственный «интерфейс», который смог прочитать эти педантичные определения Википедии, «понять» их (через тысячи примеров кода и статей) и перевести обратно на человеческий язык. Википедия стала отличной базой данных для роботов, но плохим учебником для людей.

Путеводитель по Майами: куда сходить за 3 дня? | 2025-11-25T20:03:54

Майями — что там делать? Завтра улетаем на 3 дня — Надя, Лиза, я. Понакидайте что там стоит посетить. И если вдруг есть общие друзья из Маями, потегайте, плз, вдруг что посоветуют интересного. А то, честно говоря, у меня только один музей там в списке «точно надо посетить» (Perez), а все остальное какое-то мутное.