Метод Липпмана: Революция в цветной фотографии | 06 июня 2026 года, 05:30

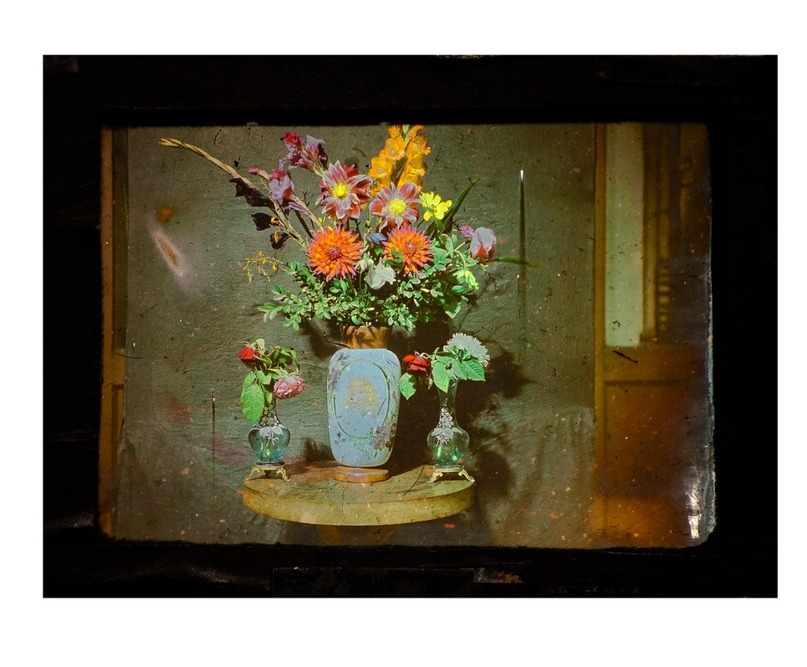
Узнал сегодня о методе цветной фотографии изобретенной в 1891 году, — о пластинах Липмана. Метод Липпмана — это красивейший гибрид фотографии и голографии На стеклянную пластину наносился слой прозрачной желатины с наночастицами галогенида серебра, а с обратной стороны ее поджимали зеркалом из жидкой ртути (!). Свет, проходя сквозь стекло, отражался от ртути, сталкивался сам с собой и создавал стоячую волну. Внутри микроскопического слоя желатины свет буквально «застывал», выжигая серебряные нано-структуры в строгом соответствии с реальной длиной волны.

У всех современных методов цвет достигается за счет наложения трех цветов, также как на экране, с которого вы это читаете, красного, синего и зеленого. То есть никакого истинного желтого или фиолетового на фотографии нет. А на пластине Липпмана все цвета настоящие.

А еще любопытно, что пластина Липмана не содержит ни капли пигмента или красителя. Она абсолютно прозрачна! Цвет в ней рождается физически (за счет структурной интерференции) — точно так же, как переливаются крылья бабочек или мыльные пузыри.

Ну и очевидно, что с такой «фотографии» невозможно сделать копию. Ссылку на хорошее видео дам ниже

Правда, у этой оптической магии были свои капризы. Идеально четкие зеркальные слои внутри пластины получались только от чистого, концентрированного цвета. Если в кадр попадал сложный «грязный» или блеклый свет, микро-структуры начинали накладываться друг на друга, смазывая точность цветопередачи. К тому же в эмульсии одновременно рождались два противоположных эффекта: физическое серебряное зеркало создавало цветную позитивную картинку, но само по себе это серебро оставалось обычным черно-белым негативом. Из-за этого оптического конфликта яркость кадра сильно сжималась, создавая винтажный эффект «раскрашенной вручную» фотографии. Поэтому метод требовал ювелирной работы со светом и идеально ярких декораций.

Тайны работы водонапорной башни | 05 июня 2026 года, 20:02

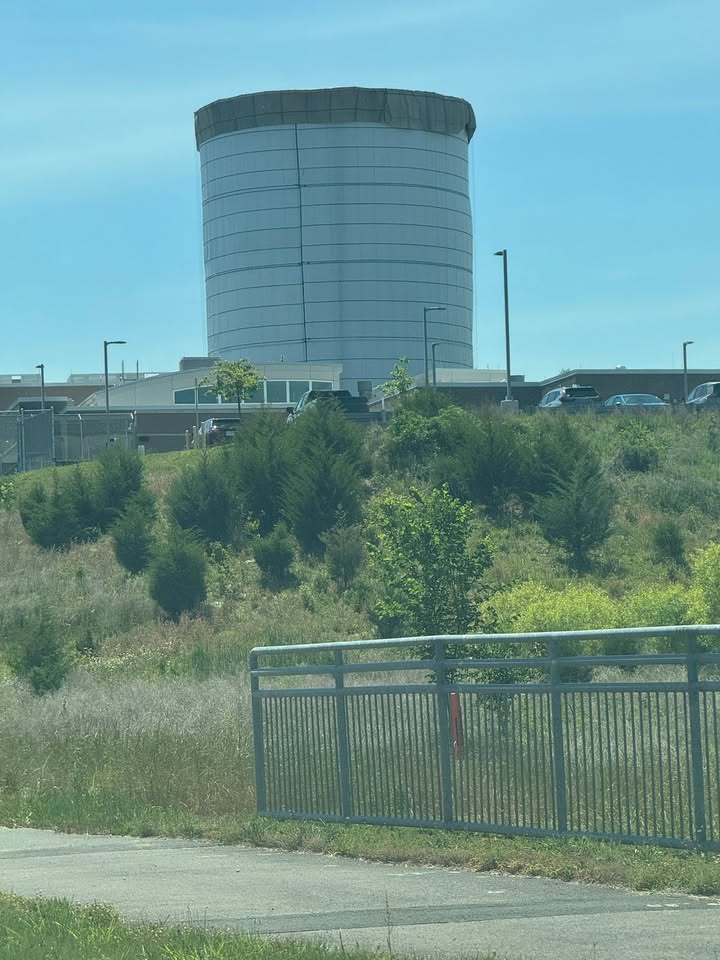
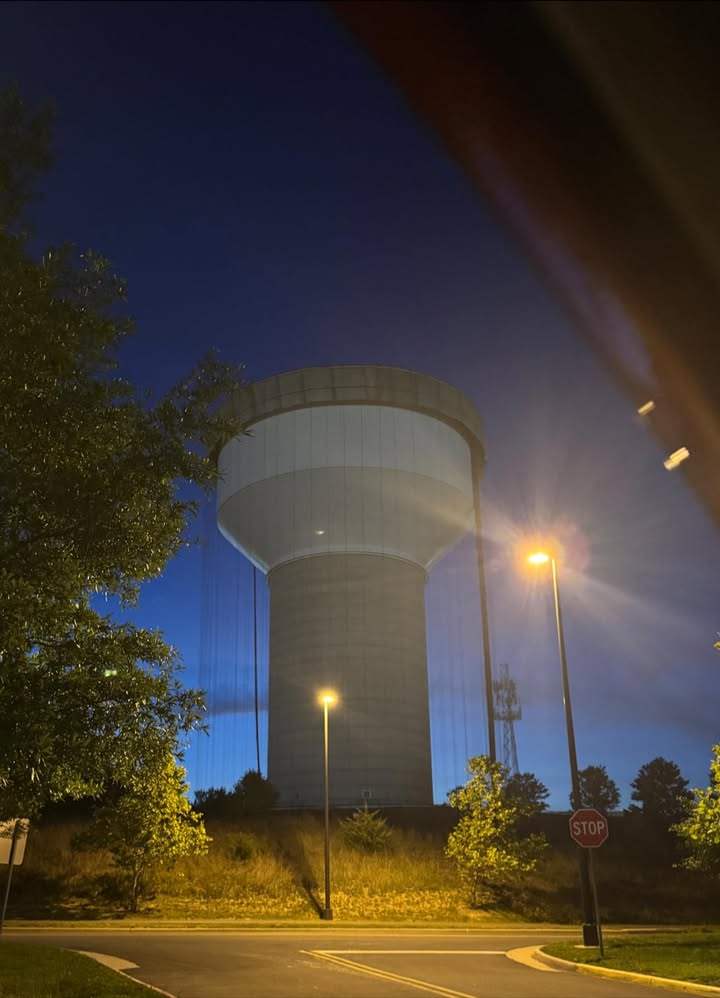
Почему у водонапорной башни (рядом с домом) днём в тридцатиградусную жару тент есть, а ночью — нет? Вот и я так думал. Оказалось — неправильно думал.

Оказалось, что тент этот временный, нужен для проведения работ по покраске башни. Как покрасят — снимут. Ночью краска продувается и сохнет.

Кстати, башня металлическая, а значит от перепадов температур она изменяется в размерах. Краска поэтому — эластичная.

Ещё интересно, как проверяют, все ли покрыли краской (потому что иначе ржаветь начнёт). Используют метод, который забавно ещё со времён раннего кораблестроения называется Holiday Detection, а по сути это дефектоскопия «на искру».

Специалист берет прибор, похожий на швабру с металлической щеткой, на которую подается высокое напряжение (до нескольких тысяч вольт). Поскольку сухая эпоксидная смола — это диэлектрик, а стальная стена за ней — проводник, инспектор медленно ведет щеткой по свежеокрашенной стене. Если в покрытии есть хоть малейший микроскопический дефект, электрическая цепь замыкается, раздается громкий писк и проскакивает искра. Это место тут же помечают и красят заново.

Ещё, кстати, вдруг кто не знал, эти башни и близко не создают достаточного давления, чтобы вода добралась до вашего крана. Они играют роль аккумуляторов, смягчающих неравномерность потребления. Ну и заодно амортизатор.

И ещё интересно, что в северных штатах проблема как раз не с нагревом, а с заморозкой зимой. На поверхности и вдоль стенок образуется слой льда толщиной, сравнимой с метром-двумя. И там реально есть водонагреватели.

Почему металлический корпус ноутбука «вибрирует» при зарядке? | 31 мая 2026 года, 15:27

Сегодня узнал, что за физика/биология стоит за ощущением покалывания от металлического корпуса (скажем) макбука, когда он заряжается. Эффект называется электровибрацией, а возникает он из-за паразитной емкостной связки и отсутствия заземления у стандартного блока питания. Это было вроде очевидно, но вот как это работает — не было.

Внутри зарядника есть кондер, из-за которого на алюминиевый корпус ноутбука просачивается безопасный, но ощутимый потенциал розеточного переменного тока. Когда касаетесь крышки, тело и ноут превращаются в своеобразный живой конденсатор, тонкий слой люминия и кожи — изолятор, разделяющий заряды.

Пульсация тока в розетке — 50–60 Гц. Электрополе между пальцем и корпусом то усиливается, то ослабевает. По закону Кулона это заставляет кожу притягиваться к металлу и отпускать. Если просто положить руку на ноутбук, сила этого притяжения слишком мала, чтобы её заметить.

Происходит обман рецепторов — нервные окончания в подушечках пальцев, которые в природе отвечают за распознавание текстур, сходят с ума от такой микроскопической чехарды с трением. Мозг совершенно не умеет распознавать электростатические микротоки напрямую, поэтому он выбирает самую логичную для себя интерпретацию и внушает вам, будто вибрирует сам металл.

Трехмерные надписи: от идеи до печати | 27 мая 2026 года, 21:12

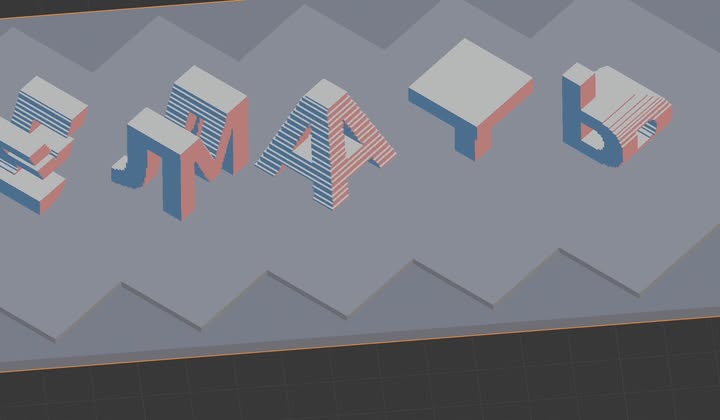
Сделал скрипт, который генерит надписи, читаемые как три разных слова слева, справа и сверху. В целом это развитие того, что у меня было в предыдущем посте. — там было только лево-право. Один скрипт генерит тройки слов по словарю, которые технически можно сделать. Другой делает 3D-модель, которую можно кинуть на принтер (может сегодня и кину), а третий делает визуализацию этой модели — см видео

Трансформация слов: игра в переводы и 3D-печать | 27 мая 2026 года, 18:28

Сделал скрипт, который создает вот такие штуки. Можно разные фразы друг в друга переводить, лишь бы совпадало число букв. Вот думаю, надо распечатать на 3D-принтере, все готово ж

Создание неуловимого: когда ИИ терпит неудачу | 2026-05-24T22:56:03

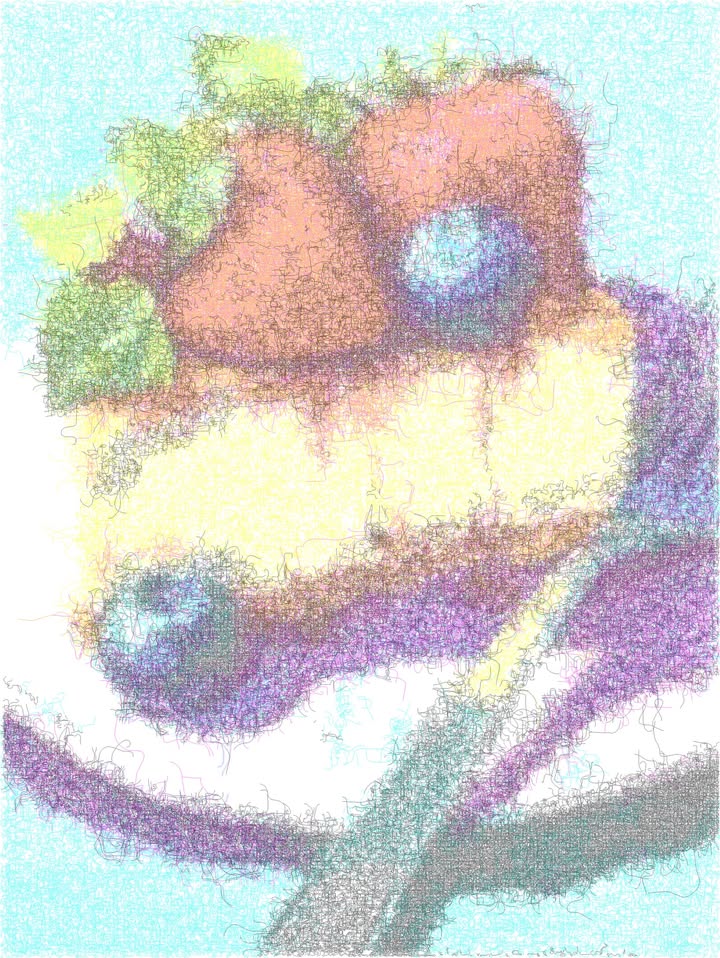
Забавно, но Gemini, Claude, ChatGPT не смогли разобрать, что я тут такое нарисовал. Вообще это в первый раз такое, что то, что способен увидеть человек, не способна увидеть разобрать модель.

Алгоритмическое искусство в большом формате: создание через сплайны и CMYK | 2026-05-24T22:40:31

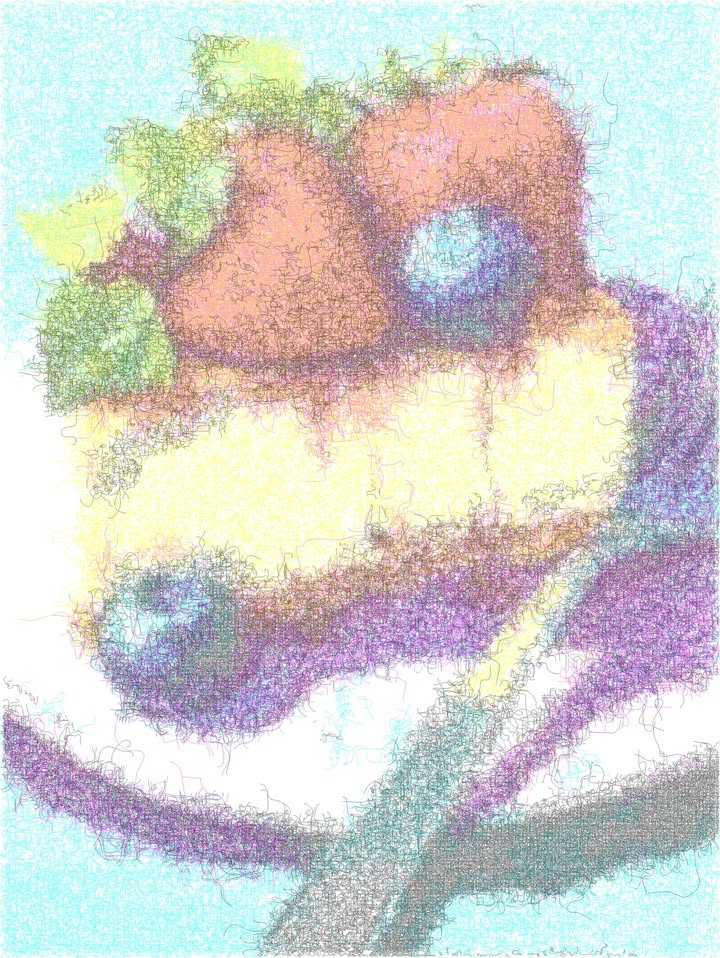
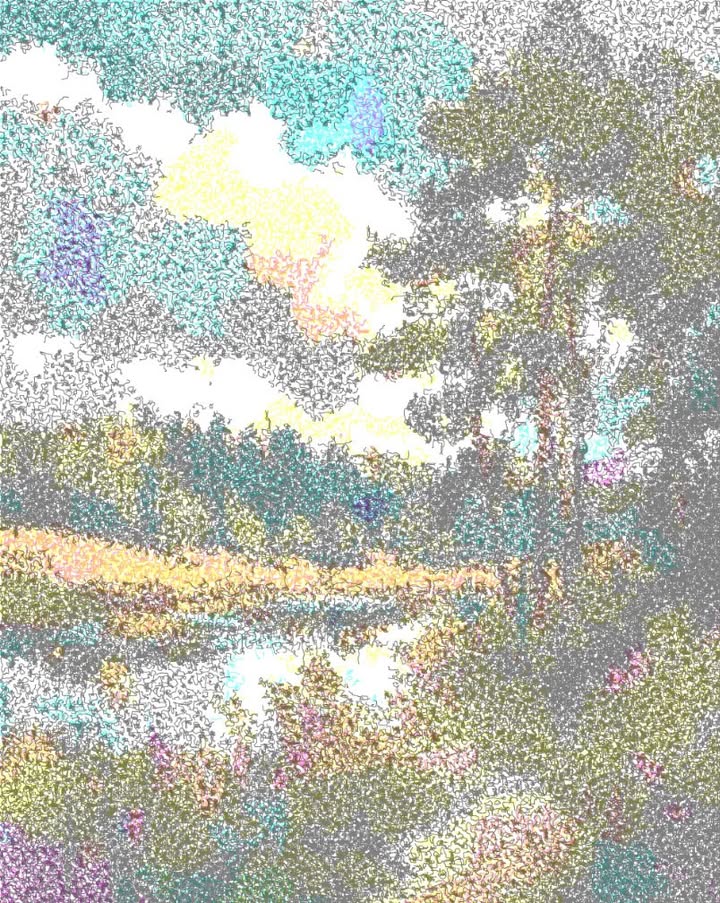
Играюсь с алгоритмической обработкой изображений. Картинки интересно выглядят только будучи распечатанными на большом формате — потому что все эти тонкие линии при масштабировании на экран телефона сливаются. Приложу в комменты приближение.

Работает так: на вход дается изображение, оно разбивается на квадраты разных размеров. Каждый квадрат — одно число: насколько он тёмный. Чем темнее — тем больше линий рисуется внутри. Линии не прямые — это сплайны Безье. Они плавно перетекают из одного квадрата в соседний, потому что точки на границах — общие. Получается не сетка, а единая непрерывная нить. Цвет — изображение раскладывается на каналы CMYK (как в типографии). Каждый канал обрабатывается отдельно: своя сетка, свои линии. Потом слои накладываются друг на друга — и из трёх или четырёх чёрно-белых пластин появляется цветная картинка.

Изображение не выглядит блочным из-за того, что сплайны из квадратов плавно перетекают друг в друга, но есть проблема: разбиение картинки на квадраты 10×10 по сути понижает разрешение в 10 раз. Для коррекции производится несколько проходов с разными размерами квадратов и сдвинутыми

сетками. Первый проход — крупные клетки, второй — мельче и сдвинуты на 10 пикселей вправо, третий — ещё мельче и сдвинуты по диагонали.

Весь процесс управляется JSON-конфигом — для каждого канала свои параметры, для каждого прохода внутри канала свои. На выходе — SVG, который можно масштабировать до размера стены без потери качества, и PNG, в котором CMYK слои накладываются с полупрозрачностью.

Автоматизация кросс-постинга: боремся с трудностями API Facebook | 2026-05-23T14:28:22

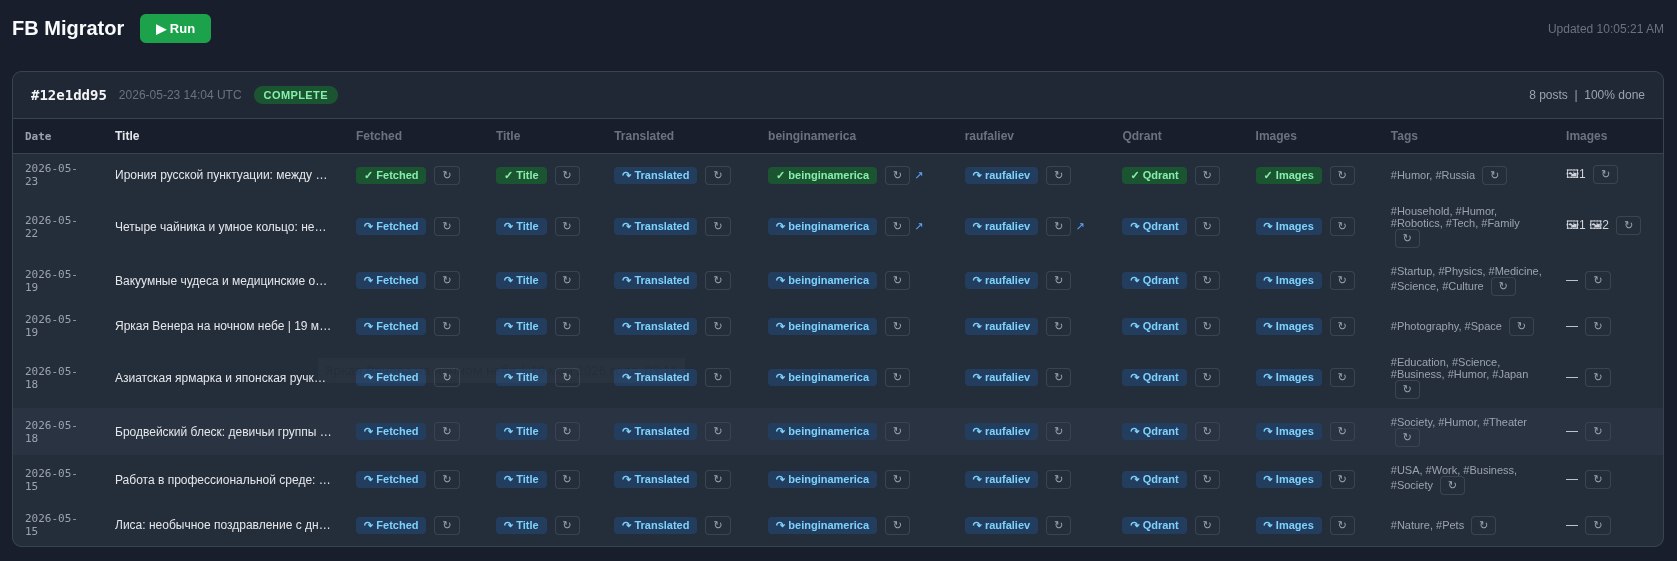
Доделал в лучшем виде кросс-постинг из фейсбука на два моих сайта-блога [на которые почти никто не заходит] — beinginamerica точка com и raufaliev точка com. При публикации нового поста в фейсбуке по расписанию стартует механизм перевода поста на английский, разбор приложенных картинок, генерация описаний к ним, создание заголовка на основе текста поста и описания картинок, создание тегов на их же основе, запись поста в turso db — это облачная база, бесплатная до определенных лимитов, создание эмбеддингов через openai, запись в qdrant cloud — это тоже облачная база, но уже векторная, ну и загрузка изображений в wordpress по API, и публикация поста на английском и на русском по API.

Все бы хорошо, но из всех API самый дурацкий — у фейсбука. Во-первых, для страниц как у меня, переведенных в New Experience, нет возможности использовать почти все из этого API. Точнее, есть, но нужно долго доказывать фейсбуку, что это реально надо, показывая документы на стартап, демонстрируя приложение и т.д. Очевидно, им не хочется иметь дело с чем-то уносящим контент из их системы во вне. Кроме этого, токен, который дает доступ к последним сообщениям, относительно короткоживущий (возможно, несколько недель), и получать его заново нужно через браузер только. То есть, любая автоматика требует регулярного внимания, иначе она ломается.

Если протупил и вовремя не выгрузил последние посты через этот Facebook Graph API, они просто исчезают из списка последних и все, больше по API к ним не обратиться. Единственный способ — запросить выгрузку архива у фейсбука. Эта выгрузка тоже довольно дурацкая — там нужно много трансформаций делать и убирать лишнее. Например, в файле с постами, который я обрабатываю, там почему-то хранятся ссылки, которые я отправлял в комментариях без сопроводительного текста. А комментарии там идут в отдельном файле!

Чтобы назначить теги, пришлось решить отдельный челендж. Вот есть около 10000 постов за все время. Это большой кусок, и по нему теги построить нельзя, потому что он в контекстное окно LLM не помещается. А надо. Поэтому я делал так: скрипт берет случайные посты из 10000 в таком объеме, чтобы их суммарный размер был чуть меньше указанного лимита в токенах, и в конец этого блока добавляется промпт «сгенери мне наиболее частые теги, 30 штук» (промпт привожу упрощенно). В итоге я запустил это 10 раз и получил 10 наборов тегов по 30 штук, сгенерированных для разных срезов базы. Получилось 300 тегов, из которых конечно есть полные дубликаты, а есть синонимы и близкие по смыслу. Это все скармливается LLM, и получаем список тегов и иерархию тегов. Теперь у нас есть ограниченный набор тегов, которые максимально отражают 10000 постов. Так получилось, что за почти 20 лет на фейсбуке у меня расклад такой:

Тег Постов

==================================================

#Russia 3412

#Thoughts 3146

#Tech 3105

#Culture 2765

#Hobbies 2726

#AI 1603

#Science 1367

#Software 1358

#Travel 1298

#Learning 1138

#Society 1050

#Nature 958

#Education 915

#Business 902

#Art 894

#Programming 889

#Humor 840

#History 807

#Gadgets 750

#Moscow 713

#USA 614

#Cinema 567

#Webdev 493

#Music 476

#Sports 473

#Mindset 443

#Auto 400

#Books 386

…

ну и так далее. Этот список включает как теги из ограниченного списка, так и теги, которые LLM поставила материалу просто потому, что не нашла в ограниченном ничего подходящего.

Теги из ограниченного списка стали категориями на сайте. Остальные теги + эти стали просто тегами wordpress.

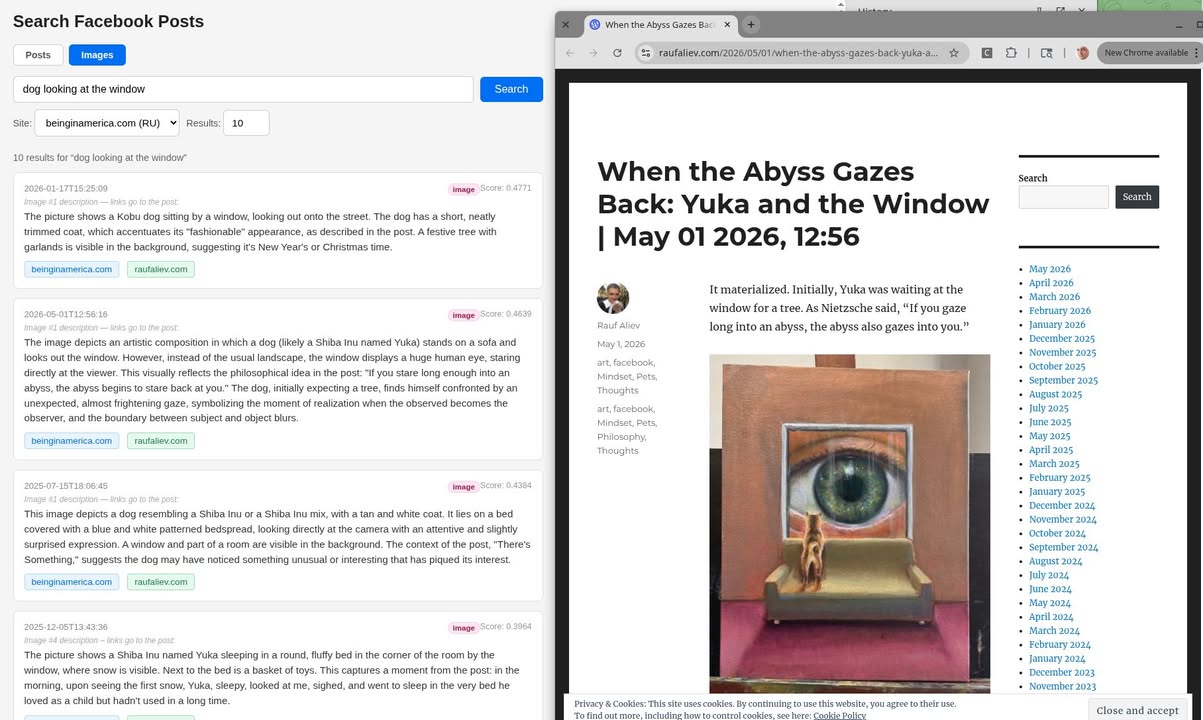
Поиск по картинкам. У меня было две идеи как его сделать. Первая — OpenCLIP. Это довольно просто, но требует хостинга модели где-нибудь. На своей машине легко, но каждый раз ее запускать неудобно, плюс я планировал переносить мигратор на дешевый сервер в амазон. В облачных моделях тоже нормально считать, но хоть немного за это надо платить, а это еще одна dependency. Но главное — что и без этого неплохо работает. Я с помощью OpenAI , который и так используется для перевода на английский, генерю описания к картинкам, и дальше по этим описаниям делаю embeddings с помощью large модели. Пока что все тесты на поиск проходят на ура. Особенно, когда на картинке есть текст, и большой вопрос разобрал бы ли его OpenCLIP.

В итоге:

1) вордпресс raufaliev точка com — бесплатный

2) вордпресс beinginamerica точка com — бесплатный

3) turso db где хранятся все посты — бесплатный

4) qdrant cloud где хранятся эмбеддинги — бесплатный

5) openai для перевода и описания картинок — не бесплатный, но недорогой (обработка постов за год потребовала 30 баксов).

Прикладываю два скриншота — как работает поиск по изображениям, и по текстам, а также дашборд мигратора.
Четыре чайника и умное кольцо: неожиданные подарки от роботов | 2026-05-22T19:21:14

Заказал чайник Breville. Сто баксов стоит. Да, можно было купить похожий за 30, но у меня все Breville, плюс чайник покупается на несколько лет. Прихожу домой — у двери стоит коробка мне по пояс. Удивило не сильно, потому что Amazon любит класть какую-то мелочь в дальний угол огромной коробки, им так проще. Но сомнения усилились после того, как я ее не поднял одной рукой. Заношу домой — а там четыре чайника.

Открываю Амазон, смотрю заказ — все правильно, один. Может, они за 100 баксов продают 4-pack? Нет, в описании один чайник. Жму на саппорт, отвечает робот. Выбираю пункт «привезли extra items». Робот говорит «наш фолт, оставьте себе». Ну ок, теперь у меня четыре чайника. Семья большая, по чайнику каждому.

У Нади есть умное кольцо Oura 4. Что-то часто приходится заряжать, говорит. Раньше подольше работало, говорит. Связываюсь с саппортом. Отвечает робот. Я открываю своего робота и прошу сформулировать хорошее письмо в саппорт. Их робот проникся, говорит, сейчас подключусь к вашему кольцу и все пойму. Подключился, понял. Говорит, ждите новое кольцо. Сегодня приехал невзрачный конвертик с кольцом внутри. Если бы не FedEx его душно было со спамом выбросить.

Люблю роботов, за эти два раза почти на семьсот баксов ништяков. Ну хорошо, с кольцом хоть гарантийный случай, хотя я ожидал, что меня с моими претензиями к батарее послали.

Ну раз так, попросил робота сделать иллюстрацию к посту.

Лисы и кролики: неожиданные зрители YouTube | 2026-05-12T13:26:59

На этом видео ничего не происходит. Забавно, что ютуб вызывает живой интерес не только у местных лис, но и у кроликов