Интерактивная игра на скорость реакции с беспроводными кнопками | 2025-07-28T22:26:20

Кто в электронике шарит? Рекомендуйте.

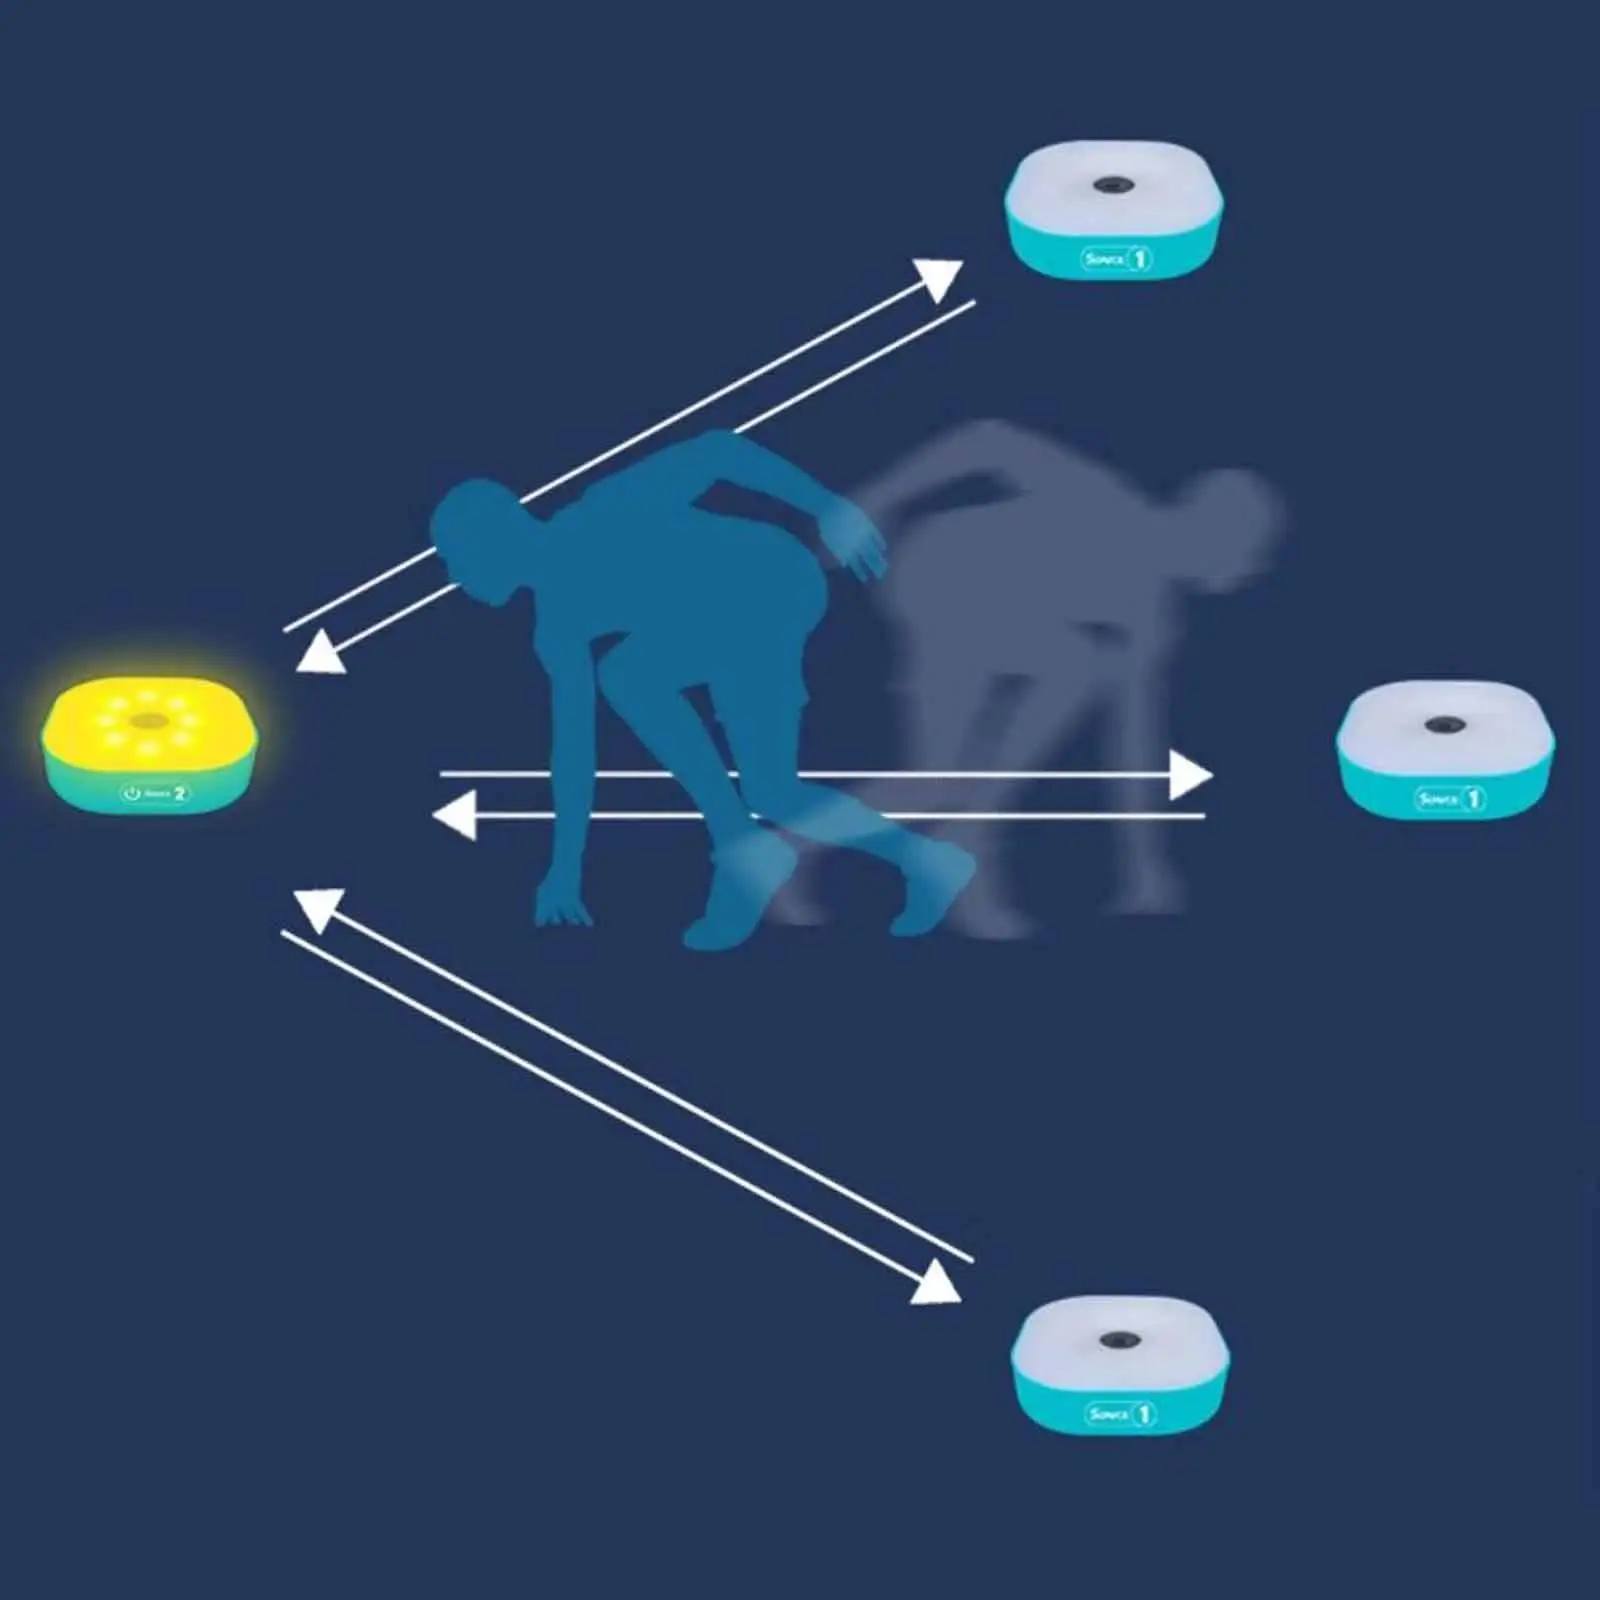
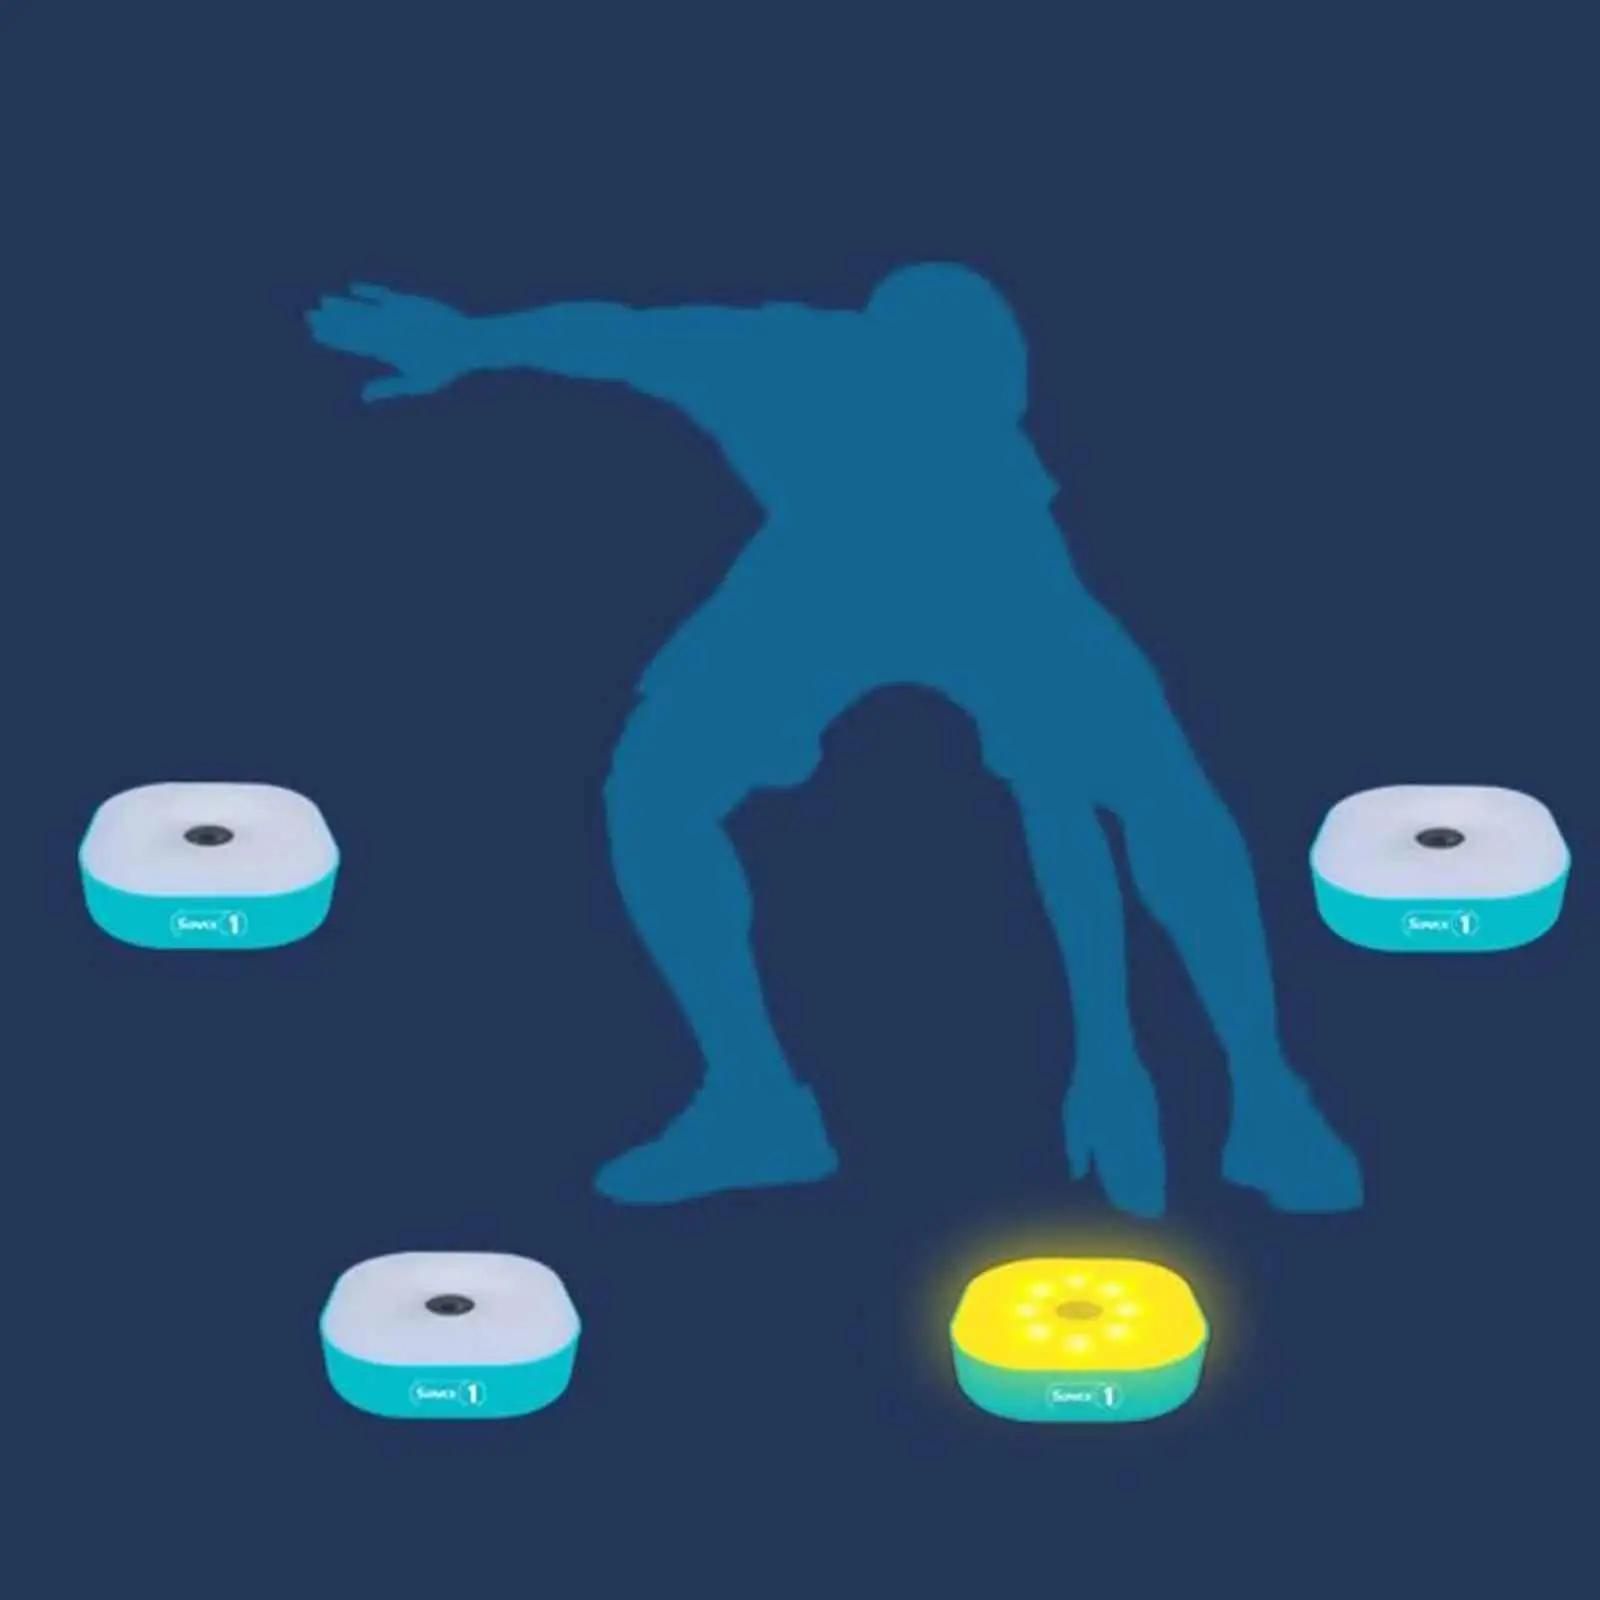
Хочу сделать на каких-то выходных такую штуку. Большая лампочковая кнопка. Загорается — ты по ней долбишь. В приложении сечется время, сколько прошло от загорания до долбежки. Кнопок может быть несколько и они могут быть разбросаны — по стене или полу. БЕЗ ПРОВОДОВ. Загораться они могут рандомно — это управляется приложением (телефон или комп). На лету вычисляются метрики типа среднего времени реакции в разном понятии слова средний. Будет можно, например, поставить кнопки на землю в нескольких метрах друг друга и придумать подвижную игру детям. Можно прикрепить на стенке и шарашить в нее мячиком. Короче, технический вопрос на самом деле.

Как бы вы это сделали — глупые кнопки на чипе nRF24L01+ или умные кнопки на микроконтрлеере esp32?

В первом случае каждый такой модуль слушает радиоэфир: как только от центрального узла приходит команда с его ID, он включает свет. После нажатия кнопки — отправляет обратное сообщение «pressed». Таймер находится на стороне центрального узла. Каждая кнопка имеет Arduino Pro Mini + nRF24L01+, но будет еще центральный хаб тоже с nRF24L01+ и Arduino Uno, Mega или ESP32, который собирает данные и который связан с компом (Bluetooth или Wifi).

Во втором случае кнопки подключены по Bluetooth (BLE) или Wifi. Мозгами кнопки является ESP32, его надо программировать через программатор.

По деньгам получается оба подхода без стоимости аркадных кнопок и 3D-печати плюс-минус одинаково — где-то в районе $10-15 за кнопку.
Как редко я перезагружаю свой Mac: всего четыре раза в год | 2025-07-11T20:18:22

На маке есть команда last reboot, из которой выходит, что я перегружал комп за последний год всего четыре раза.

Будущее автопилотирования: Tesla и новый уровень технологий FSD | 2025-07-11T03:59:25

Читаю всякие инженерные блоги про автопилот Tesla (FSD) — просто потому, что я последние полтора месяца почти постоянно езжу как на такси — указываешь место назначения и дальше практически никогда не нужно вмешиваться, машина едет из точки А в точку Б полностью самостоятельно. Это конечно будущее.

Такие системы есть не только у Tesla. Например, она есть у Мерседеса (Drive Pilot). У остальных только в лучшем случае в пробках помогает. Хотя Tesla кажется единственная, которая работает на всех дорогах.

Так вот, возвращаясь к инженерным интересностям. У Теслы есть производство AI-моделей на своей «ферме», которая называется Dojo — это экзафлопный суперкомпьютер на чипах Tesla. Туда скармливаются видео с камер, и он тренирует модели, которые дальше отправляются для автономной работы на весь парк машин Tesla.

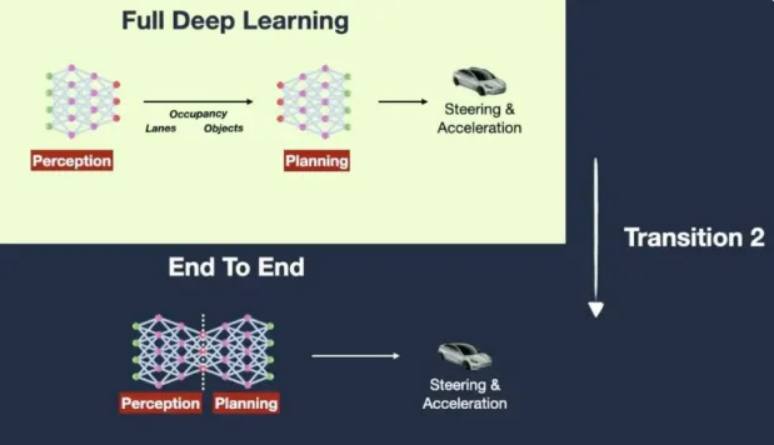
Архитектура FSD состоит из порядка 48 специализированных нейросетей, обученных на Dojo, которые вместе формируют около 1000 разных тензоров-прогнозов. Tesla постепенно переходит с модульных сетей (распознавание объектов + планирование) к end‑to‑end-тренингу — прямое преобразование видеокадров в траекторию/момент рулевого управления. Это похоже на «черный ящик» — нейросеть учится прямо по поведению человека, без ручной установки регуляторов; очень крутое инженерное решение, но, предполагаю, сложное в отладке.

Кстати, заявляется, что Тесла пересела с С++ на питон. И что этот переход на end-to-end training сделал ненужным 300,000 строк кода на С++, где были учтены всякие корнер-кейсы и правила разруливания различных ситуаций — теперь это на уровне модели.

Tesla отказалась от радара и ультразвука, перейдя к полностью камерным решениям (Vision Only) с «Hardware 4» (HW4, FSD Computer 2): 16 ГБ RAM, 256 ГБ флеш‑памяти, производительность 3–8× выше HW3.

Оцените производительность: 22 миллисекунды на создание 3D сцены с машинками, пешеходами, велосипедистами вокруг — идет сбор информации с 8 камер 36 раз в секунду.

85 мс на весь цикл от получения картинки до изменения плана и команд колесам. Фантастика!

Более 4 млн Teslas на дорогах ежедневно собирают данные, а в версии FSD Beta зафиксировано более миллиарда миль автономного вождения. Этот «живой» датасет используется для обучения сетей на самых реальных сценариях, включая редкие «edge‑case» (странные аварии, дорогие условия и т. д.).

В июне 2025 Tesla впервые доставила Model Y из завода в Остине к дому клиента без водителя и удаленного оператора — полностью автономно. Это очень круто.

Vision‑сеть не только анализирует текущий кадр, но и хранит признаки от предыдущих (на расстоянии ≈1 м). Это позволяет запоминать недавно пересечённую разметку/знаки, даже если они уже вышли из поля зрения – очень похоже на человеческую память.

Оптимизация полнотекстового поиска: платформа для анализа и улучшения результатов | 2025-07-06T04:35:44

У меня есть наработки в области тестирования полнотекстового поиска. Прямо готовая рабочая многопользовательская платформа, которой даёшь условно 1000 запросов, несколько конфигураций поисковой машины, и к утру она выдаёт отчёты с графиками, метриками, и заключением, что конфигурация A перформит лучше, чем B, и вот почему. Рассчитывает все эти NDCG@k, MAP, precision, recall, и ещё с десятка два разного. Использует LLM, но уже на последней стадии, после того, как вся математика закончилась.

Так вот, в чем вопрос. Я ищу кого-нибудь, кто задавался такой же проблемой на своём проекте, чтобы понять деманд и аск.

Проблема, которую решает система, формулируется так: есть рабочий поиск по товарам, документам, — Solr, Coveo, Elasticsearch, Algolia — неважно, и есть гипотезы как сделать его лучше, но есть и опасение, что сделав лучше в одном, мы сломаем другое. Вот моя штука помогает это увидеть в цифрах и графиках, дать заключение с обоснованием, включающим статистическую значимость и другие метрики.

Ещё она умеет быть виртуальным поисковым ассессором. Она для каждого результата поиска может давать оценку, несколько хорошо каждый из документов соответствует запросу. Это очень нетривиальная задача (особенно для больших документов), там включаются chunking, embeddings, LLM evaluation of relevant chunks и т.д. Нетривиальная, но работает.

Ещё она умеет анализировать поисковые запросы и разбивать их на группы по похожести. Например, такое разбиение может показать, что пользователи иногда ставят пробел между словами, образующими бренд товара, а иногда нет. Эти разные варианты попадут в одну группу.

Мне бы хотелось это обсудить с кем-то, кто может лучше меня в этой теме, у кого есть/были такие проблемы и кто может их как-то решил.

У меня сейчас ощущение, что мой продукт единственный на рынке. Точнее, он ещё даже не на рынке. Но вообще ничего похожего я не вижу. Может, никому это и не надо?

Скриншоты не буду открыто публиковать пока. Картинка для, привлечения внимания.

Пошарьте плиз если в вашем нетворке могут быть нужные люди.