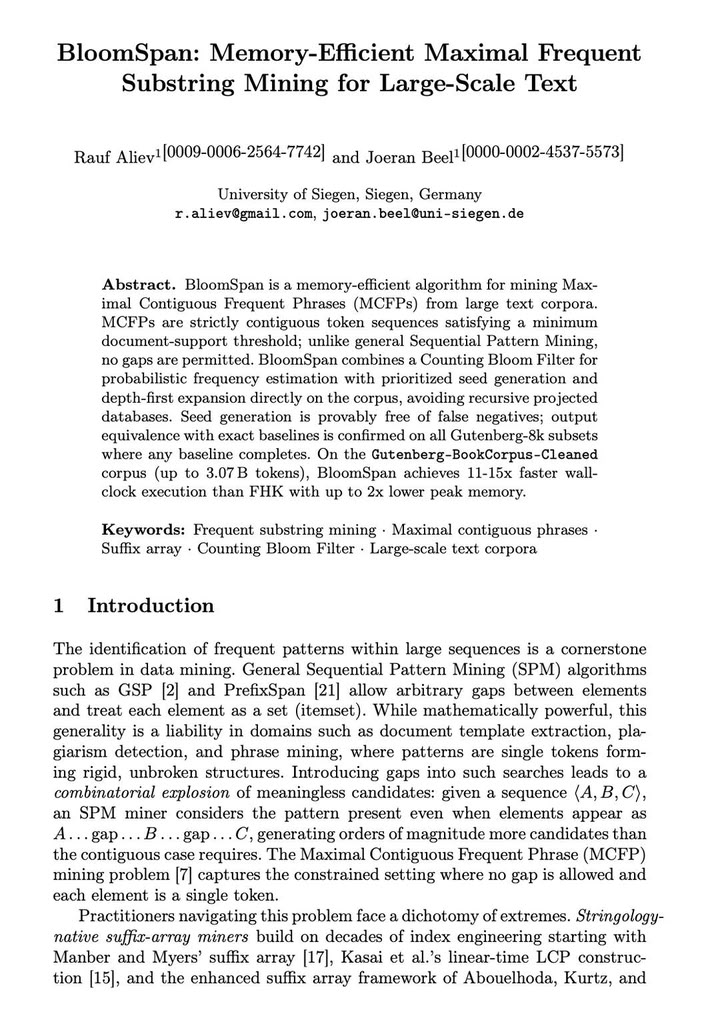
Хочу поделиться нашей свежей работой — алгоритм BloomSpan по поиску наиболее длинных частых последовательностей слов в массиве текстов. Я его назвал BloomSpan.
О чём это, если по-человечески. Представьте, что у вас есть библиотека из 50000 книг, и нужно найти все длинные фразы, которые повторяются во многих разных книгах слово в слово, без пропусков. Не «похожие» фразы, а именно одинаковые цепочки слов, причём максимально длинные — такие, что если добавить ещё одно слово слева или справа, фраза уже перестаёт встречаться достаточно часто. Задача звучит просто, но на миллиардах слов она упирается в память и время. Классические алгоритмы либо строят огромные индексы, либо перебирают слишком много кандидатов.
Где это нужно? Например, вытаскивать шаблоны из документов (например, одинаковые «шапки» в письмах или договорах), искать заимствования и плагиат, выделять устойчивые фразы и клише в больших текстовых массивах.
Так вот, что получилось. Алгоритм. Честно говоря, BloomSpan — это не прям алгоритм с нуля, а аккуратная сборка из известных идей, которые вместе дают сильный эффект. В базе — разные идеи от BIDE+, FHK, и поверх всего этого: (а) Фильтр Блума — компактная структура, которая отвечает на вопрос «встречалось ли это сочетание слов достаточно часто?», не храня сами сочетания. Она может иногда ошибиться в сторону «да», но никогда — в сторону «нет», поэтому мы гарантированно не теряем ни одной нужной фразы (б) Поиск «в глубину» прямо по тексту — находим короткое частое ядро и постепенно наращиваем его в длинную фразу, не создавая промежуточных копий корпуса. (в) Карта занятости — отмечаем в тексте позиции, уже «покрытые» найденными фразами, чтобы не проверять одно и то же по многу раз.
Что получилось. На корпусе из 50 тысяч книг Project Gutenberg (около 3 миллиардов слов) BloomSpan работает в 11-15 раз быстрее классического алгоритма FHK и съедает до двух раз меньше памяти. Это единственный из протестированных методов, который вообще дошёл до конца на полном корпусе в пределах 40 ГБ. При этом результат полностью совпадает с точными алгоритмами там, где они успевают отработать — то есть ускорение не за счёт качества.
На искусственных же данных с «неестественным» распределением слов старый добрый FHK быстрее. Bloomspan заточен именно под живой естественный язык, и в статье разбирается, почему так.
Препринт и код (Java) — в комментариях