Вертикальная рокировка: лазейка в правилах | 21 октября 2026 года, 12:11

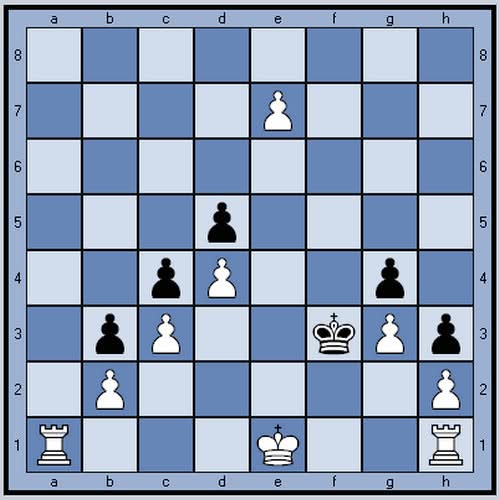
Сегодня я узнал, что в шахматах когда-то (теоретически) можно было (не запрещалась) сделать рокировку по вертикали. Был такой шахматный журналист Тим Краббе, составивший шахматную задачу в 1972 году, в которой белый король стоял на своём месте, на e1, а белая пешка превращалсь в ладью на поле e8. Краббе внимательно перечитал правила ФИДЕ и обнаружил, что там написано, что король и ладья не должны были ходить до этого, но нигде не сказано, что ладья должна быть на той же горизонтали, что и король. Новая ладья на e8 ни разу не ходила? Не ходила. Король тоже. Значит, по букве правил король может прыгнуть на e3, а ладья — на e2. Рокировка по вертикали, формально безупречная.

Задача разлетелась по шахматному миру, все похихикали, а потом ФИДЕ в 1973 году тихо поправила правила. Теперь в них чётко прописано, что рокировка делается только с ладьёй на той же горизонтали.
Искусственный интеллект на испытании: мини-игры ARC-AGI-3 | 17 августа 2026 года, 04:51

Сегодня наткнулся на тесты ARC-AGI-3 для моделей AI. То есть, если вам кажется, что AI может за вас сделать что угодно, то считайте, что вы заработали уже большую часть из $850,000 призового фонда — просто сабмитьте ваш прекрасный код, и пусть он будет лучшим. Но так не работает. Кожаные мешки справляются с 100% задач, а вот программы пока не преодолели планку в 2.5-3%. Что там за задачи такие?

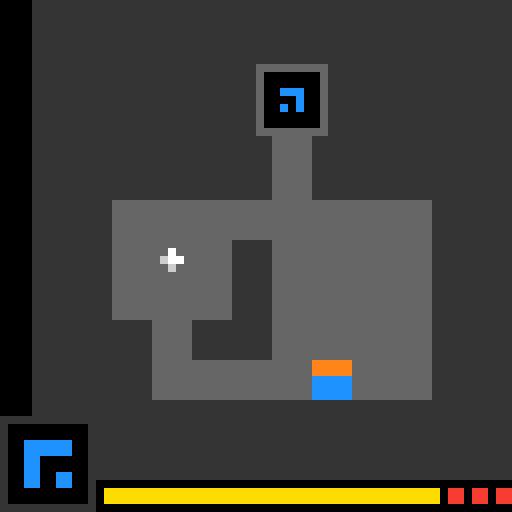
Программе дается не текстовое задание, а мини-игра. Нет ни инструкций, ни описания правил. На каждом шаге программа получает «кадр» — JSON-объект с текущим состоянием поля. Это сетка размером до 64×64 клетки, где ячейки закодированы числами от 0 до 15 (обозначающими разные цвета или типы блоков). У агента есть стандартизированный интерфейс (действия 1–7), включающий базовые шаги и возможность указывать конкретные координаты (X, Y). Но ИИ заранее не знает, что делают эти действия! В одной задаче «Действие 1» может сдвигать блок вправо, в другой — перекрашивать его, в третьей — включать гравитацию. Чтобы понять логику, ИИ должен активно «тыкать палочкой» в среду. Он совершает экспериментальное действие, среда реагирует и возвращает новый кадр. Агент должен проанализировать изменения, обновить свою теорию о физике этого конкретного мира и сделать следующий осознанный шаг. Игра может завершиться статусом WIN, GAME_OVER или продолжаться дальше.

Еще раз — люди набирают 100%, машины — 2-3%. На сайте ARC PRIZE можете попробовать, там есть сэмпл-задачки.